

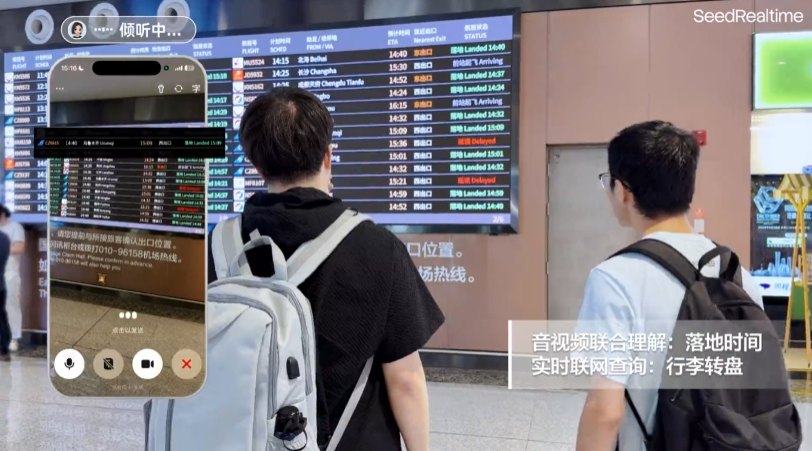
ByteDance Seed أعلنت اليوم على إطلاق النموذج الكبير للصوت والصورة بدوبلكس كامل SeedRealtime، اللي كيتجه نحو تفاعل طبيعي شامل الوسائط.
SeedRealtime كيدمج الصوت والصورة والنص بشكل أصلي داخل بنية موحّدة، وكيقدر يتفاعل فالوقت الحقيقي مع تدفّق متواصل ديال المعلومات متعددة الوسائط، باش يقدّم تجربة جديدة ديال «تشوف، تسمع وتهضر فآن واحد». وحقق النموذج ثلاث اختراقات أساسية:
الفهم الموحّد للصوت والصورة: كيدعم بشكل أصلي الدمج العميق بين الصوت والصورة والمعلومات الزمنية. النموذج كيقدر يستعمل السياق باش يميّز بين الكلمات اللي عندها نفس النطق، وكيقدر حتى يفهم بدقة الإشارات الزمنية فالمشهد، باش يدمج بين اللي كيتشاف واللي كيتسمع واللي كيتقال.
القدرة على التفاعل بشكل استباقي: كيتوفر على إدراك مستمر للبيئة وقدرة على التعبير بشكل استباقي. ملي كيلحظ تبدّل فحالة الصورة، بحال ظهور هدف مهم، كيقدر ينبّه المستخدم من راسو، وكيقدر حتى يستعمل الأدوات ويدمجها فالتعبير، وبهذا كيتحوّل التفاعل من مجرّد ردّ فعل إلى تعاون استباقي.
إيقاع تفاعل سلس: كيقدر يحسّ فالوقت الحقيقي بحالة الحوار ديال المستخدم وبإيقاع التواصل، ويدخل فالهضرة ويوقف ويردّ بشكل طبيعي فالوقت المناسب. وعندو كذلك قدرة قوية على مقاومة التشويش، بحيث كيقدر يميّز بين الهضرة الجانبية والضوضاء فخلفية المكان، وما كيتفعّلش بالغلط بسبب التشويش، وكيحافظ على تواصل سلس ومترابط.
بيّنت نتائج التقييم البشري من البداية للنهاية أن مشاكل إيقاع الحوار الصوتي والمرئي فـ SeedRealtime نقصات للنصف مقارنةً بالنماذج المتسلسلة. ولى النموذج كيتحكّم بشكل طبيعي أكثر فالتوقيت ديال الكلام، ونقصات بزاف حالات التعطّل بحال «يتقاطع الكلام قبل ما يكمل، أو يتأخر الرد من بعد ما يسالي الكلام، أو يتفعّل بالغلط بسبب الضوضاء والهضرة الجانبية». وفنفس الوقت، تحسّن بشكل واضح احتمال أن تكون المحادثة الواحدة كاملة وسلسة.
دابا SeedRealtime ولى متاح لجميع المستخدمين فـ Doubao App، وحقق لأول مرة فالمجال تطبيق تقنية الدوبلكس الكامل للصوت والصورة على نطاق واسع. حدّث Doubao App لآخر نسخة، واختار «مكالمة هاتفية» من داخل خانة الحوار، ومن بعد دخل لواجهة مكالمة الفيديو باش تجرّبو.
رابط الصفحة الرئيسية للمشروع:
https://seed.bytedance.com/seedrealtime