

أعلنت الجهات الرسمية ديال النموذج الكبير Ling التابع لمجموعة Ant Group البارح أن الجيل الجديد من نموذج الاستدلال الهجين الأصلي Ling-3.0-flash ولى مفتوح المصدر رسمياً.
كيعتمد Ling-3.0-flash على بنية MoE فيها 124B بارامتر إجمالي و5.1B بارامتر مفعّل. وقدّمت الجهة الرسمية فالنفس الوقت النسخة الأساسية ونسخ FP8 وFP4 وINT4، مع ثلاث اختيارات مختلفة للتطبيق:
الاستعمال عبر API: موجه للمطورين اللي باغين يدمجوه بسرعة بلا ما يبنيو خدمة استدلال خاصة بهم، ويمكن استعمال Ling-3.0-flash مباشرة عبر API سحابية؛
الاستضافة الخاصة على جهاز واحد: موجه للشركات والفرق اللي ما يمكنش لبياناتها تخرج من النطاق، بحيث تقدر نسختا MXFP4 وINT4 تديرا الاستدلال من البداية للنهاية على جهاز NVIDIA DGX Spark واحد؛
النشر عالي الأداء: موجه للخدمات عالية الأداء اللي كتكون حساسة لتأخير الطلب الواحد، بحيث تجاوز معدل الإخراج المتوسط 1100 tokens/s فإعدادات اختبار محددة لوحدات GPU.
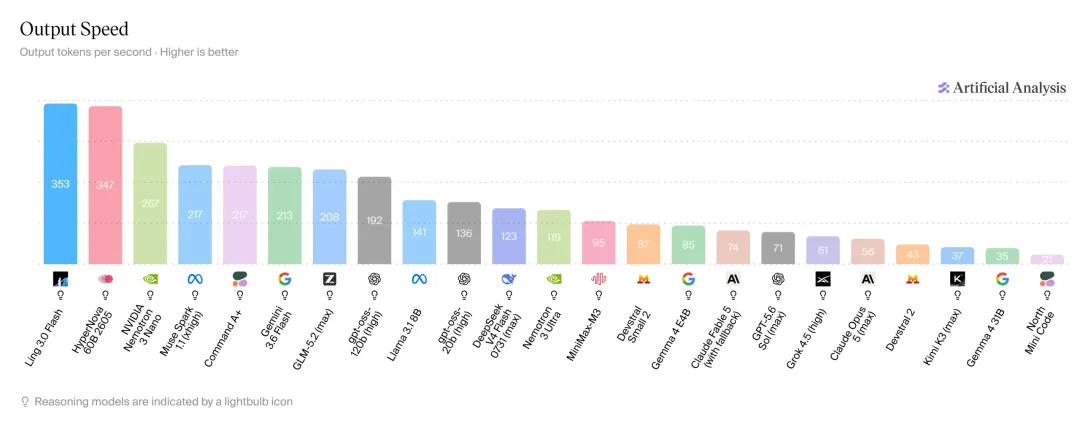
بالنسبة للمطورين وفرق المنتجات اللي باغين يختابرو المنتجات بسرعة ويطلقو تطبيقات Agent، فالـ API هي أسهل طريقة للدمج. وحسب ترتيب Artificial Analysis، وصلات سرعة إخراج Ling-3.0-flash لـ 353 tokens/s.
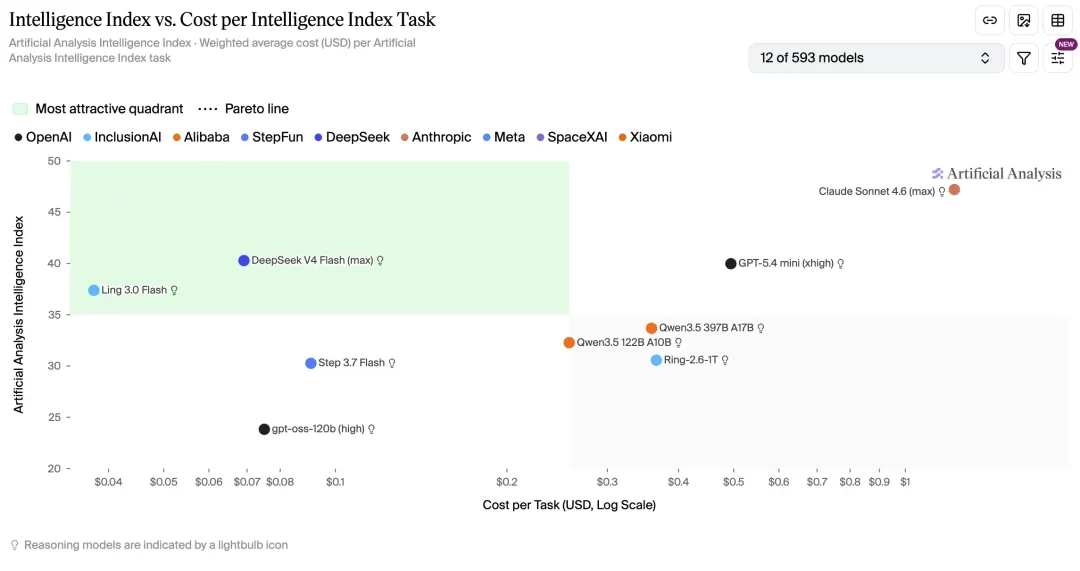
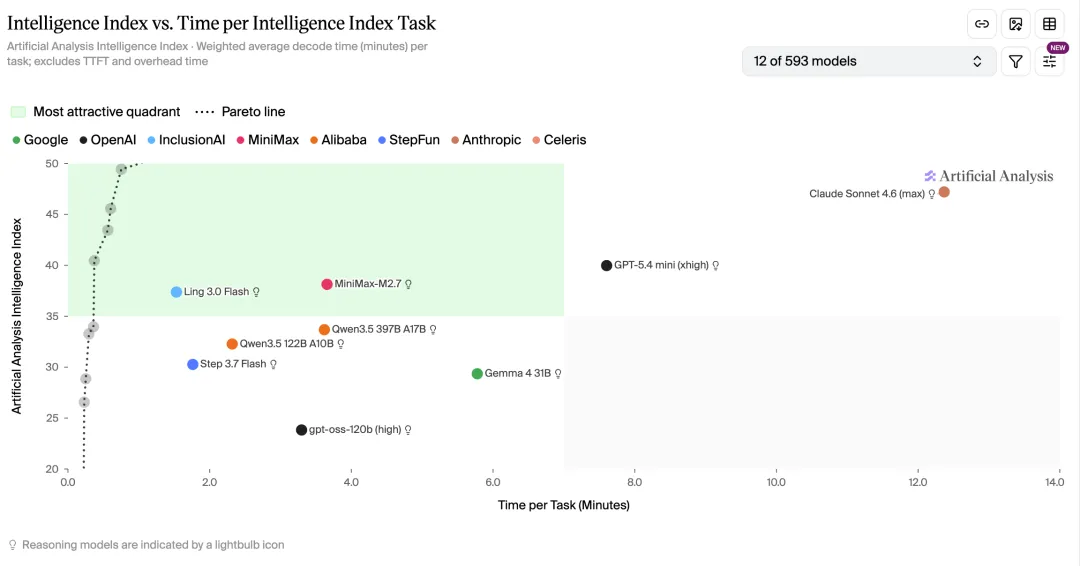
فترتيب AA Intelligence Index، كتوصل تكلفة الاستعمال المتوسط الموزون لكل مهمة فـ Ling-3.0-flash تقريباً لـ 0.04 دولار (أي ما يعادل تقريباً 0.27 يوان صيني بسعر الصرف الحالي)، بينما كيوصل وقت فك الترميز المتوسط الموزون لحوالي 1.4 دقيقة. وكيصنّف حتى هو ضمن المناطق المتفوقة فـ «مستوى الذكاء — تكلفة المهمة» و«مستوى الذكاء — مدة المهمة».
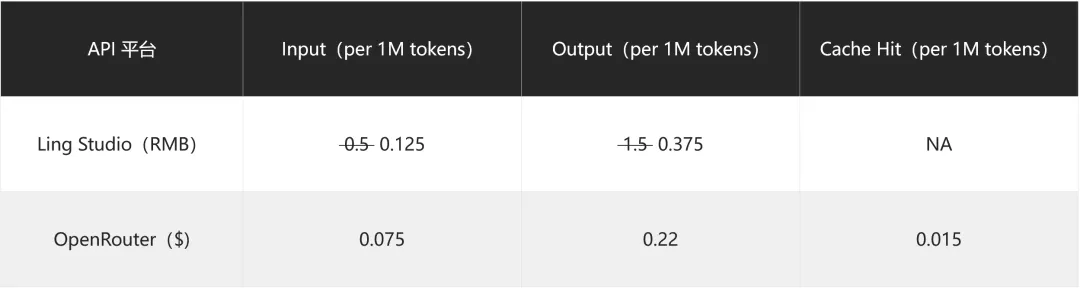
قالت الجهة الرسمية إن Ling-3.0-flash غادي يستافد من تخفيض مؤقت بنسبة 75% فـ Ling Studio من 00:00 نهار 7 غشت 2026 حتى لـ 24:00 نهار 31 غشت؛ ومن 00:00 نهار 1 شتنبر غادي يرجع للسعر الأصلي.
روابط المصدر المفتوح:
Hugging Face: https://huggingface.co/inclusionAI/Ling-3.0-flash
ModelScope: https://modelscope.cn/models/inclusionAI/Ling-3.0-flash