شركة الذكاء المتجسّد Dyna Robotics أطلقت مؤخراً الموديل الأساسي للروبوتات DYNA-2، المدرَّب على أكثر من مليون ساعة من فيديوهات البشر من منظور الشخص الأول، بنسبة نجاح فالمهام كتصل حتى لـ90%.
ومن ناحية التوجّه، كتوصّف Dyna Robotics رسمياً DYNA-2 بأنه موديل أفعال العالم (World Action Model)، والهدف ديالو هو يتعلّم، من خلال مراقبة الأنشطة البشرية، كيفاش كتبدّل الأفعال العالم المادي. هاهي لقطات الشاشة المرتبطة بالموضوع:
فما يخص التدريب، التدريب القبلي ديال DYNA-2 معتمد بالكامل على بيانات الفيديوهات البشرية، بأكثر من مليون ساعة من فيديوهات البشر من منظور الشخص الأول، وهو ما كيعادل 170 عام من التجربة البشرية.
وقال Jason Ma، الشريك المؤسس للشركة، إن الروبوتات العامة ظلت مدة طويلة محدودة بسبب عنق زجاجة البيانات، وإن جمع بيانات التحكم عن بُعد الفيزيائية يدوياً صعيب يتوسّع حتى يوصل للذكاء العام، بينما كيتعلّم موديل DYNA-2 كيفاش كتبدّل الأفعال العالم المادي من خلال مراقبة الأنشطة البشرية.
وكتشوف الشركة أن DYNA-2 كيتوقّع أولاً كيفاش غادي يتحرّك العالم المادي قبل ما ينفّذ أي فعل، وهاد الشي كيكمّل عند الروبوت القدرات ديال الاستدلال المكاني وفيزياء التلامس اللي كتنقص من نماذج الرؤية واللغة التقليدية (vision-language models).
كيعتمد الموديل على جوج أهداف تدريبية: التنبؤ بمحتوى الإطار التالي من الفيديو، والتنبؤ بالفعل اللي خاص يتدار، وبهذا كيكتسب معلومات على العلاقات المكانية، وطرق الحركة، وكيفاش كتستاجب الأشياء من بعد ما كتلامسها أفعال مختلفة.
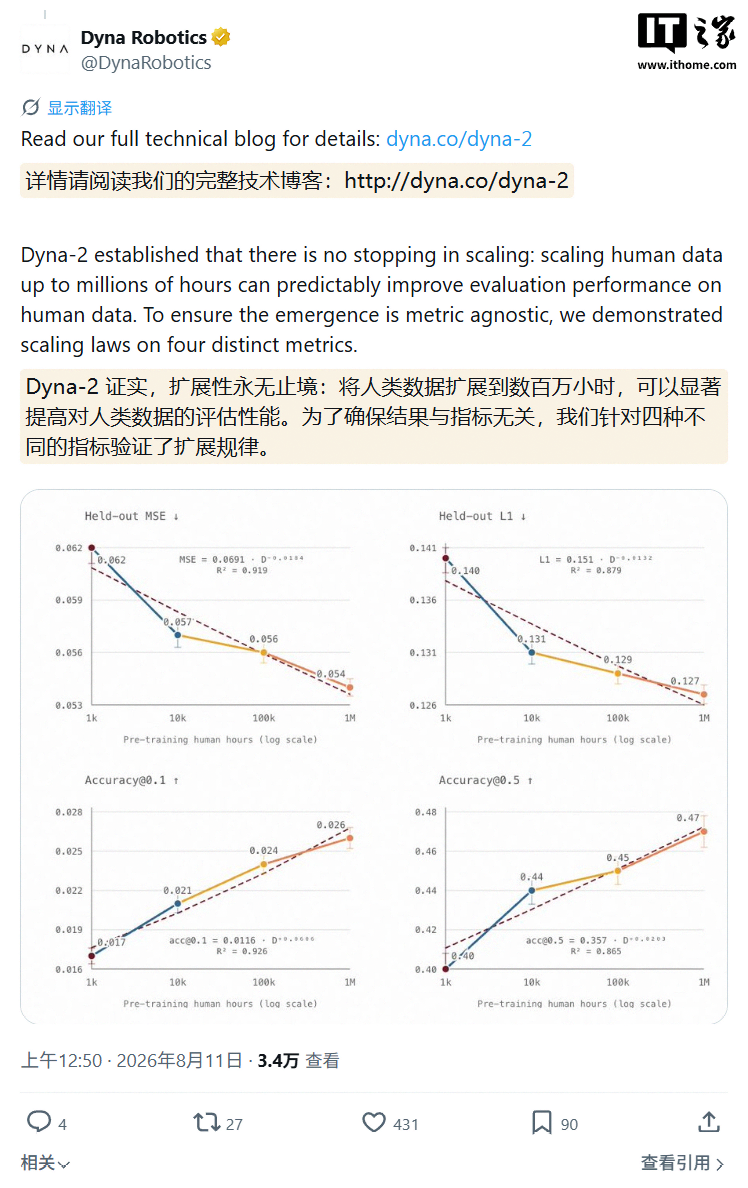
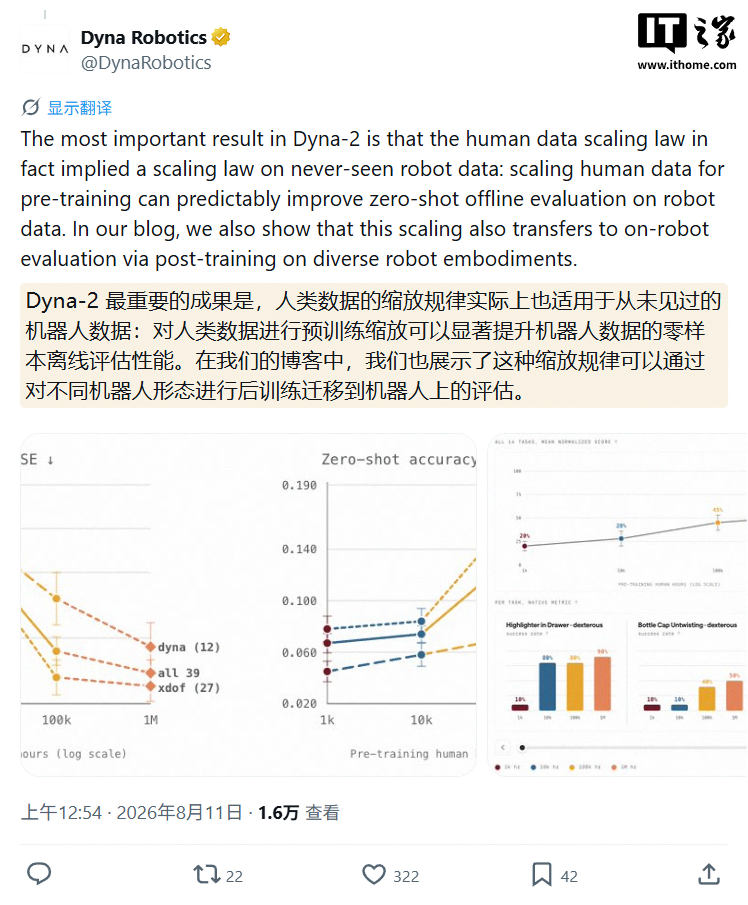
وكتبيّن النتائج اللي أعلنت عليها Dyna Robotics أن أداء الروبوتات فـ15 مهمة معيارية تحسّن مع إدخال المزيد من بيانات الفيديوهات البشرية فمرحلة التدريب القبلي. وسمّات الشركة هاد الظاهرة قانون التوسّع من الإنسان للروبوت، وقالت إن الأداء كيزيد بطريقة قابلة للتوقّع نسبياً مع توسّع حجم بيانات التدريب.
فواحدة من التجارب، كانت 13 دقيقة من البيانات الخاصة بالروبوتات كافية باش يتعلّمو جوج ديال الأيادي الروبوتية بخمسة أصابع يحلّو غطا قنينة. وفمهام التصنيع، ومع بقاء مجموعة بيانات ما بعد التدريب ثابتة، طلعات نسبة النجاح مع زيادة حجم التدريب القبلي من حوالي 20% حتى لـ80% إلى 90%.
وزادت Dyna Robotics وقالت إن Dyna-2 حقق فواحد النشر عند زبون نسبة 87% فاجتياز فحص الجودة، مقابل 46% للجيل السابق Dyna-1. وفالمهام اللي كتطلب تنفيذ أفعال مختلفة حسب تعليمات المستخدم، خلا التدريب التعاوني بالفيديو النقطة تطلع بنسبة 133%.