

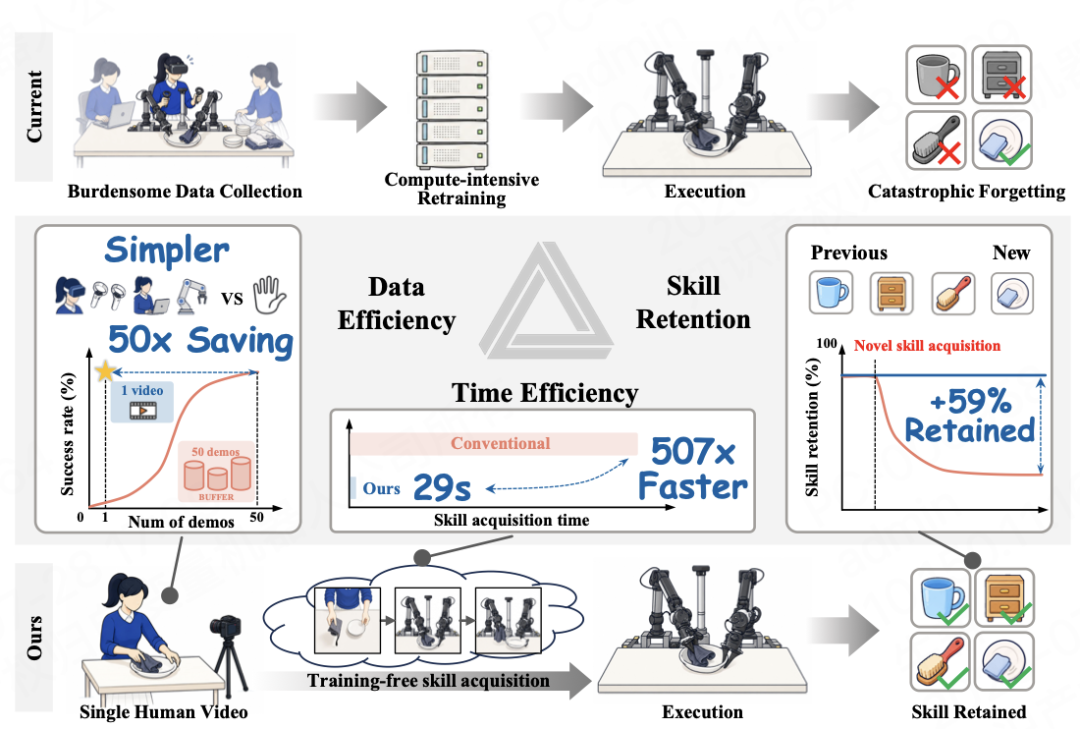
روبوتات زِیبيان أطلقت اليوم إطار HOST (Human-to-robot One-Shot Skill AcquisiTion، أي اكتساب المهارات من الإنسان للروبوت بعينة واحدة) وخلاته مفتوح المصدر، وكتقول باللي كيخلّي الروبوت يتعلّم مهارة جديدة غير من خلال مشاهدة فيديو ديال الإنسان مدتو عشرات الثواني، مع الاحتفاظ بالمهارات اللي سبق وتعلّمها.
HOST كيستعمل طريقة مبتكرة: عوض ما يترجم حركات الإنسان لحركات ديال الروبوت ويحاول يقلّدها، كيخلّي الروبوت يتخيّل أولاً النتيجة من بعد تنفيذ الحركة، ومن بعد كيفكّك هاد النتيجة باش يستخرج الحركات اللي خاصو ينفّذ. والنتائج ديال هاد الطريقة الجديدة مشجعة: نسبة نجاح الروبوت فتعلم مهارة من فيديو ديال إنسان مدتو 29 ثانية وصلات لـ 62%، متجاوزة خط الأساس ديال التعلم بلا أمثلة، اللي بلغ 45%. وبالمقارنة مع حل Pi-0.5 + الضبط الدقيق، كيحتاج HOST بيانات أقل بـ 50 مرة، وسرعة تعلّم المهارات كتزيد بـ 500 مرة.
فكرة HOST جاية من نظرية «التعلّم بالملاحظة» فعلم الإدراك: ملي كيواجه الإنسان مهمة ما مألوفاش، ما كيحتاجش يتعلّمها عن طريق التدريب الطويل ولا تجربة جميع الاحتمالات، بل كيستعمل القدرات اللي عندو من قبل باش يحاكي فدماغو النتيجة المتوقعة من الحركة، ومن بعد كينفّذ الحركة المناسبة. وبهذا الإلهام، بدّل فريق زِیبيان طريقة تعلّم HOST من «حلقة الضبط الدقيق أثناء التدريب» لـ «اكتساب المهارة أثناء الاستدلال»، باش يتعلّم الروبوت مهارات جديدة من خلال مشاهدة الإنسان وهو كينفّذ المهمة.
أول مشكل خاص الروبوت يحلّو هو: كيفاش يطابق بين التقدّم ديالو فتنفيذ المهمة والتقدّم اللي باين فالفيديو؟
مثلاً، إلا خدمو بجوج 10 ثواني، الإنسان اللي فالفيديو يقدر يكون سالا يقطّع الخضر وبدا كيطيب، بينما الروبوت باقي كيقطّع. وإذا تطابقو غير حسب الوقت، الروبوت غادي يضيّع تقدّم المهمة.
لهذا، HOST كيعتمد «المحاذاة حسب تقدّم المهمة». كيحوّل كل إطار من الفيديو وكل خطوة من خطوات تشغيل الروبوت لمتجهات داخل نفس الفضاء المتجهي؛ ومن بعد كيستعمل خوارزمية «التنظيم الديناميكي للوقت» باش يطابق أوتوماتيكياً بين «الإطار X من فيديو الإنسان والخطوة Y من تشغيل الروبوت». وبهذه الطريقة، فكل خطوة كينفّذها الروبوت، كيبقى كيشوف الإطار اللي متوافق مع تقدّم المهمة.
بفضل هاد الطريقة، نقص HOST خطأ الوقت فمحاذاة تقدّم المهمة بمرتبة كاملة، وقدر يحقّق تزامناً دقيقاً بين تنفيذ الروبوت والعرض الموجود فالفيديو.
الجزء الأساسي فـ HOST هو نموذج سياسات متسلسل فيه وظيفة التنبؤ البصري. وكيعتمد على بنية MoT بجوج خبراء، بحال جوج ديال العقول اللي كل واحد فيهم عندو دور واضح: «العقل البصري» (خبير الفيديو) كيتكلف بمعالجة صور الفيديو، وتحديد تقدّم المهمة، والتنبؤ بالمشاهد المستقبلية؛ و«عقل الحركة» (خبير الحركة) كيتكلف بتحويل المشاهد المتوقعة للحركات اللي خاص تنفيذها، والتحكم فالتنفيذ.
فتدريب النموذج، قسّم فريق زِیبيان العملية لجوج مراحل: «التدريب المسبق داخل نفس المجال» و«التدريب على فيديوهات الإنسان والروبوت». فمرحلة التدريب المسبق داخل نفس المجال، كيتعلّم الروبوت من فيديوهات ديال الروبوت وهو كينفّذ المهام، باش يتوقّع الحالة من بعد إكمال المهمة ويولّد الحركات المناسبة. وفمرحلة التدريب على فيديوهات الإنسان والروبوت، كيتعلّم الروبوت أكثر من فيديوهات العروض البشرية، وكيحوّل طريقة تنفيذ الإنسان للمهمة لنتيجة من منظور الروبوت، ومن بعد كيستنتج انطلاقاً من النتيجة المستهدفة الحركات اللازمة لإكمال المهمة، وبهذا كينقل المهارة من العرض البشري للروبوت.
حالياً، البحث العلمي والشفرة المصدرية ديال HOST كاملين مفتوحين المصدر. وفالمستقبل، يقدر الروبوت أثناء الخدمة فالدار يتخلّى على جمع البيانات والتدريب المتخصص، ويتعلّم مهارات جديدة غير من خلال عرض بشري واضح.
المراجع
الصفحة الرئيسية للمشروع
رابط البحث
رابط Github
رابط Huggingface