

فريق Qwen ديال علي بابا تونغي أعلن رسمياً الليلة على إطلاق Qwen3.8-Flash. وفنفس الوقت، نشر الفريق أوزان Qwen3.8-Flash-Next كمصدر مفتوح، بحيث إن المعمارية الجديدة ديال Next غادي تكون النموذج الأولي لجيل Qwen4 الجديد من الموديلات.
هاد الموديل هو MoE متعدد الوسائط، وفيه الموديل الرئيسي 125B بارامتر، وزايدين عليه 51B ديال N-gram Embedding، وكل token كيفعّل 6B بارامتر. كيدعم أصلاً سياق بـ262,144 tokens، ويمكن توسيعو عبر YaRN حتى لـ1M tokens.
حسب ما توضّح، دار Qwen3.8-Flash ترقية شاملة فـ4 اتجاهات:
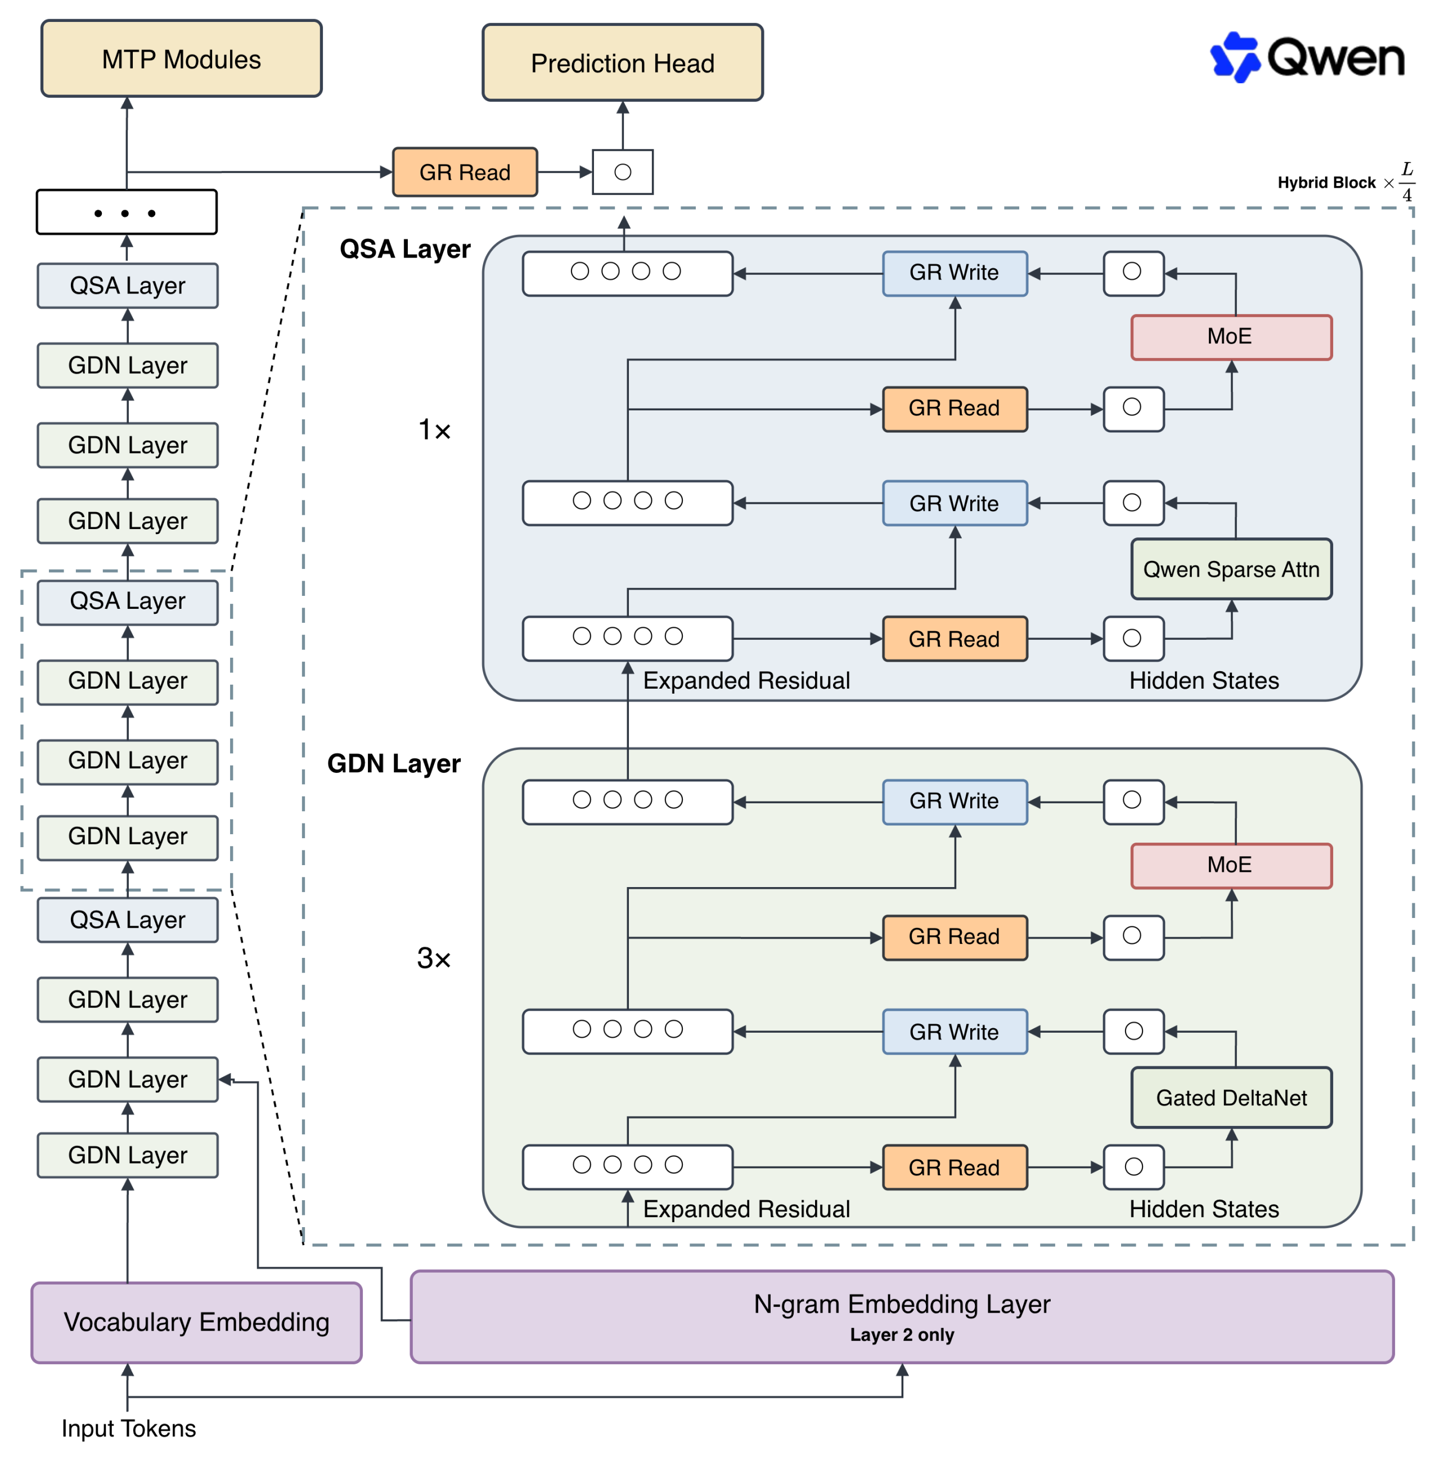
فـAttention، استعمل معمارية هجينة كتجمع GDN (Gated DeltaNet) مع QSA (Qwen Sparse Attention). GDN مسؤول على ضغط المعلومات التاريخية بكفاءة، بينما QSA كينتقي السياق المهم على مستوى micro-block باستعمال Indexer خفيف، وكيقلّل بشكل واضح من كلفة Attention فالسلاسل الطويلة. فمواجهة سياق طويل بزاف ديال 1M token، حقق Attention Kernel ديال QSA تسريعاً أقصى قدره 7.6 مرات و4.9 مرات فمرحلتي Prefill وDecode على التوالي.
فـResidual، دخلات آلية Gated Residual (GR)، اللي كتوسّع تدفق البقايا لـ4 فروع متوازية، وكتتحكم فقراءة وكتابة المعلومات عبر Gate ديناميكي. وحالة البقايا كتدعم التخزين بـFP8، وهادشي كيقلّل بزاف من كلفة الوصول للذاكرة.
فـEmbedding، تزادو 51B بارامتر ديال N-gram Embedding، باستعمال البحث فالجداول اعتماداً على السياق المحلي لتوسيع سعة الموديل. ويمكن تفريغ هاد البارامترات لذاكرة Host، ودمج Prefetch غير المتزامن مع حسابات الموديل، بلا ما تبقى محتلة لذاكرة GPU بشكل دائم.
فـOptimization، استُعمل Muon Optimizer، مع تحسينات موجهة لدقة التعامد، وتقسيم المهام بين البارامترات، وفصل المصفوفات المدمجة، وغيرها من الاستراتيجيات. كما تعاودت ملاءمة Scaling Law خصيصاً للمعمارية الجديدة.
مقارنة مع Qwen3.7-Plus، تكلفة تدريب Qwen3.8-Flash كتساوي تقريباً غير التسع ديال تكلفة الموديل السابق، ومع ذلك عندو قدرات أقوى فمهام البرمجة والعمل المكتبي.
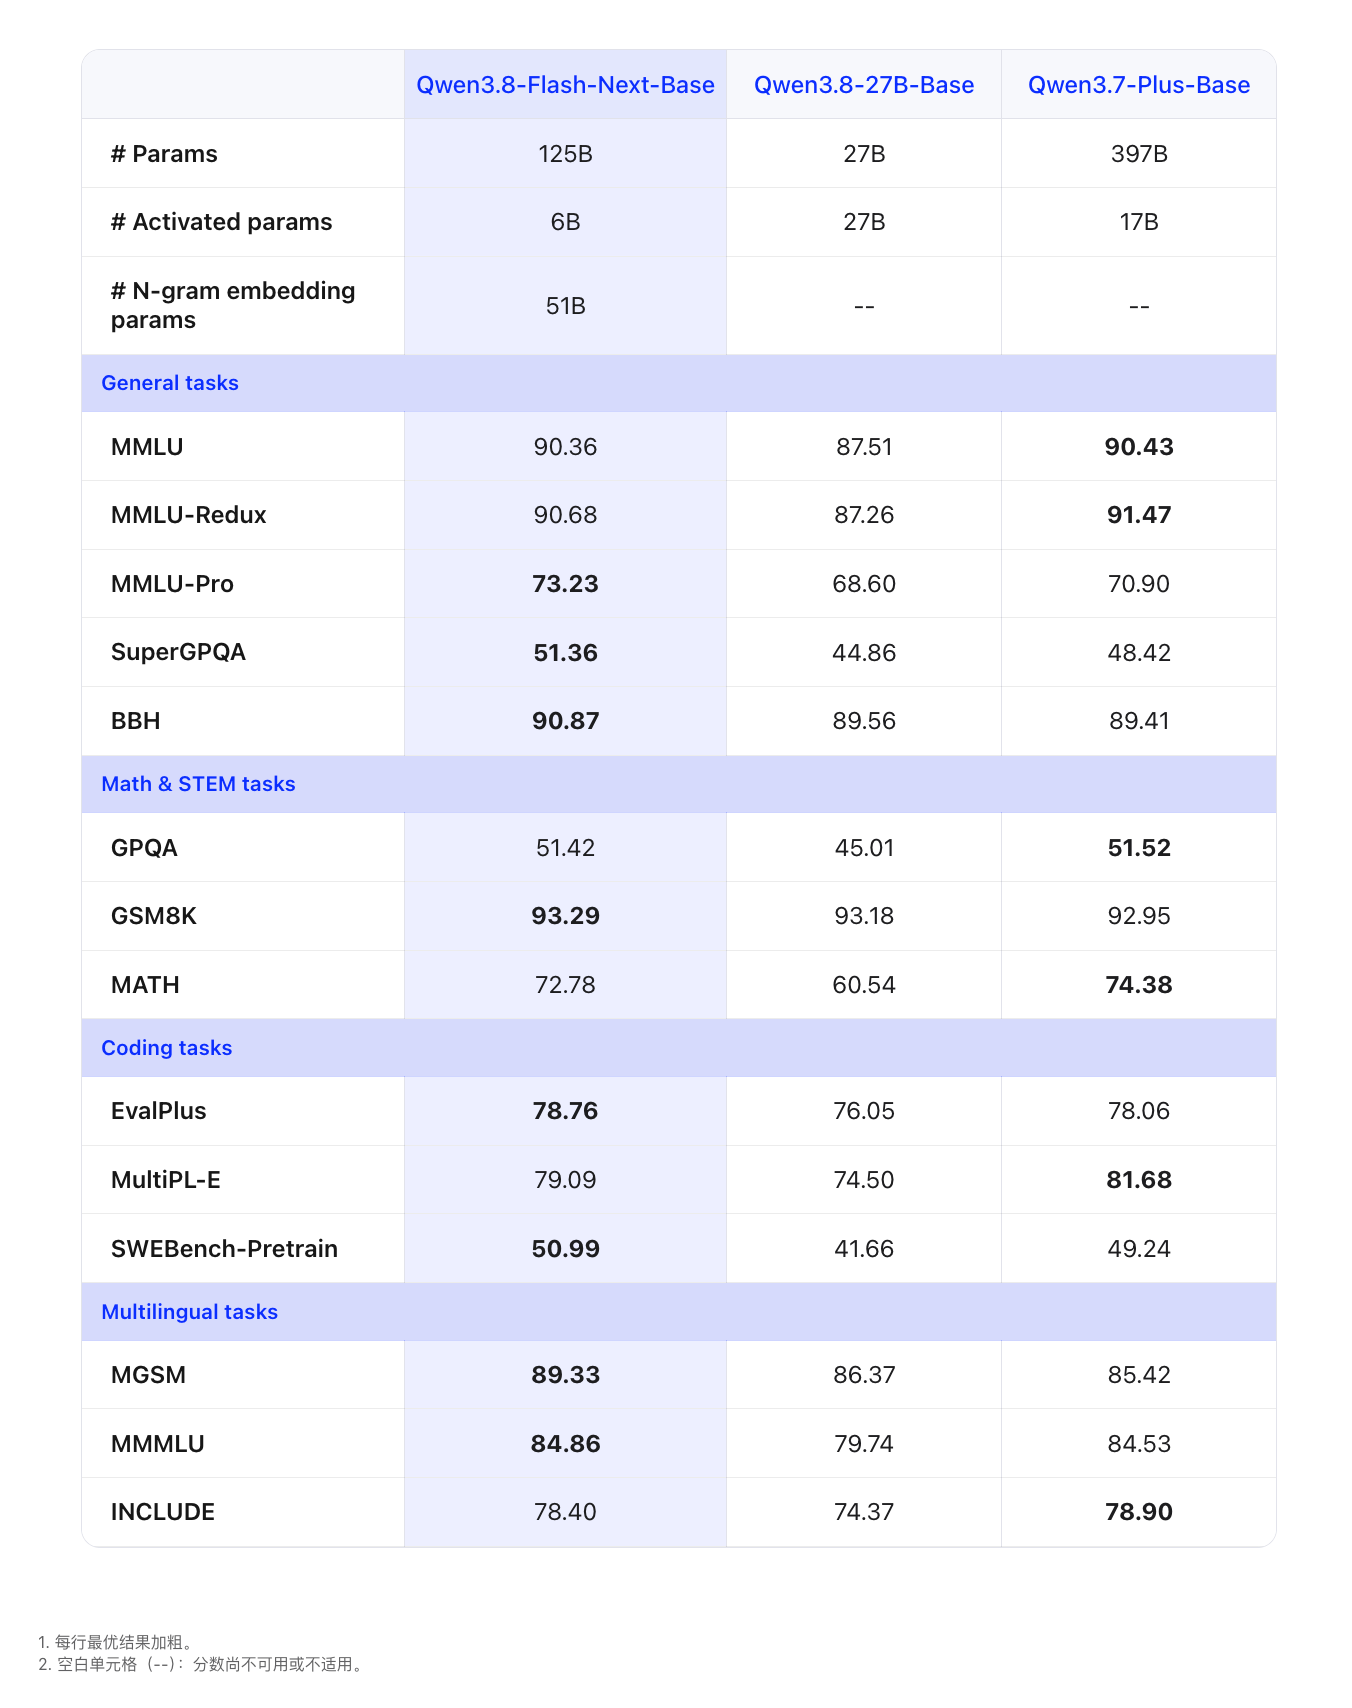
مع تفعيل 6B بارامتر، حقق Qwen3.8-Flash-Next-Base أحسن نتيجة فـ8 من أصل 14 benchmark، من بينها MMLU-Pro وSuperGPQA وBBH وSWEBench-Pretrain وMGSM وMMMU.
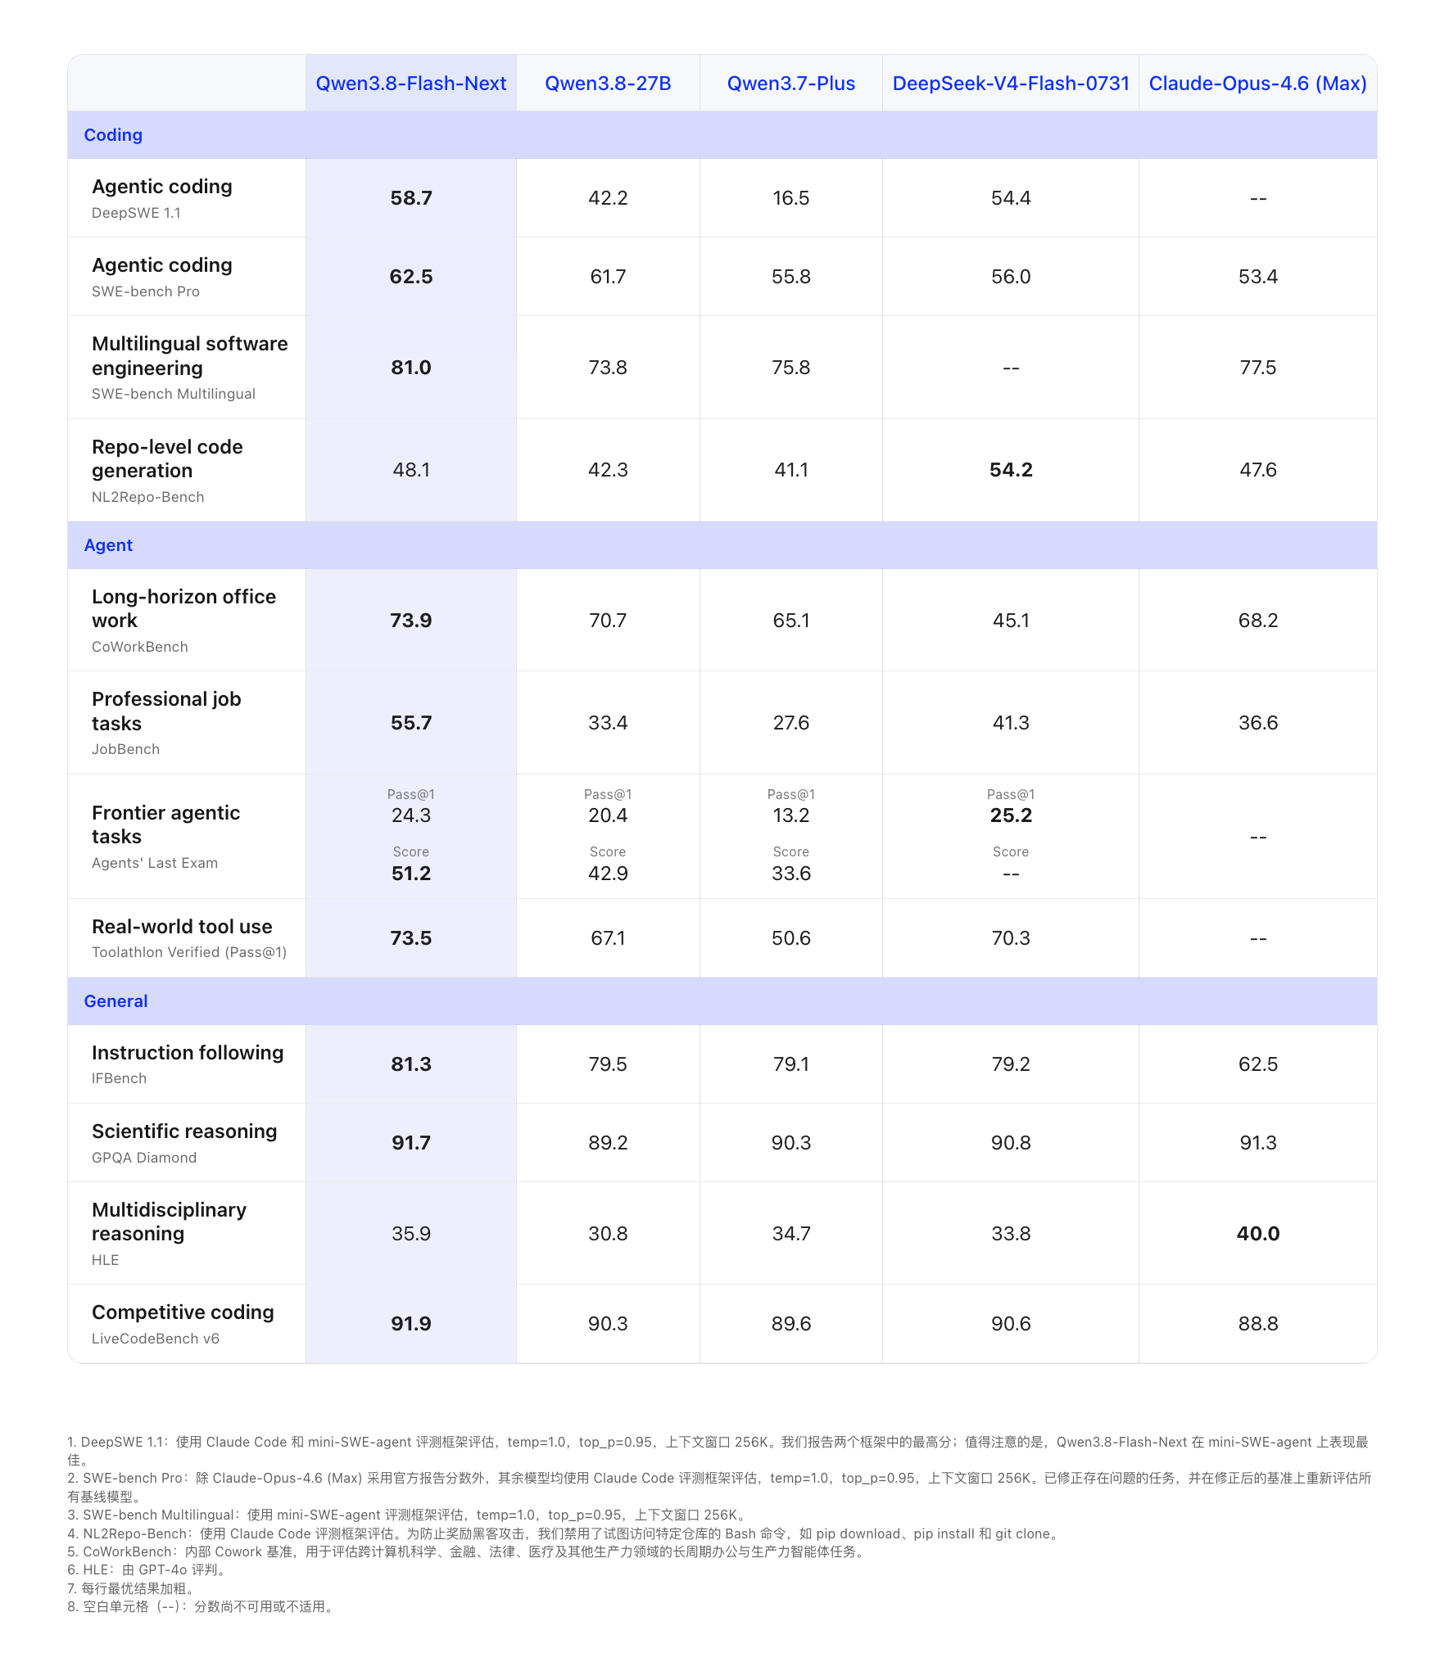
النص فقط:
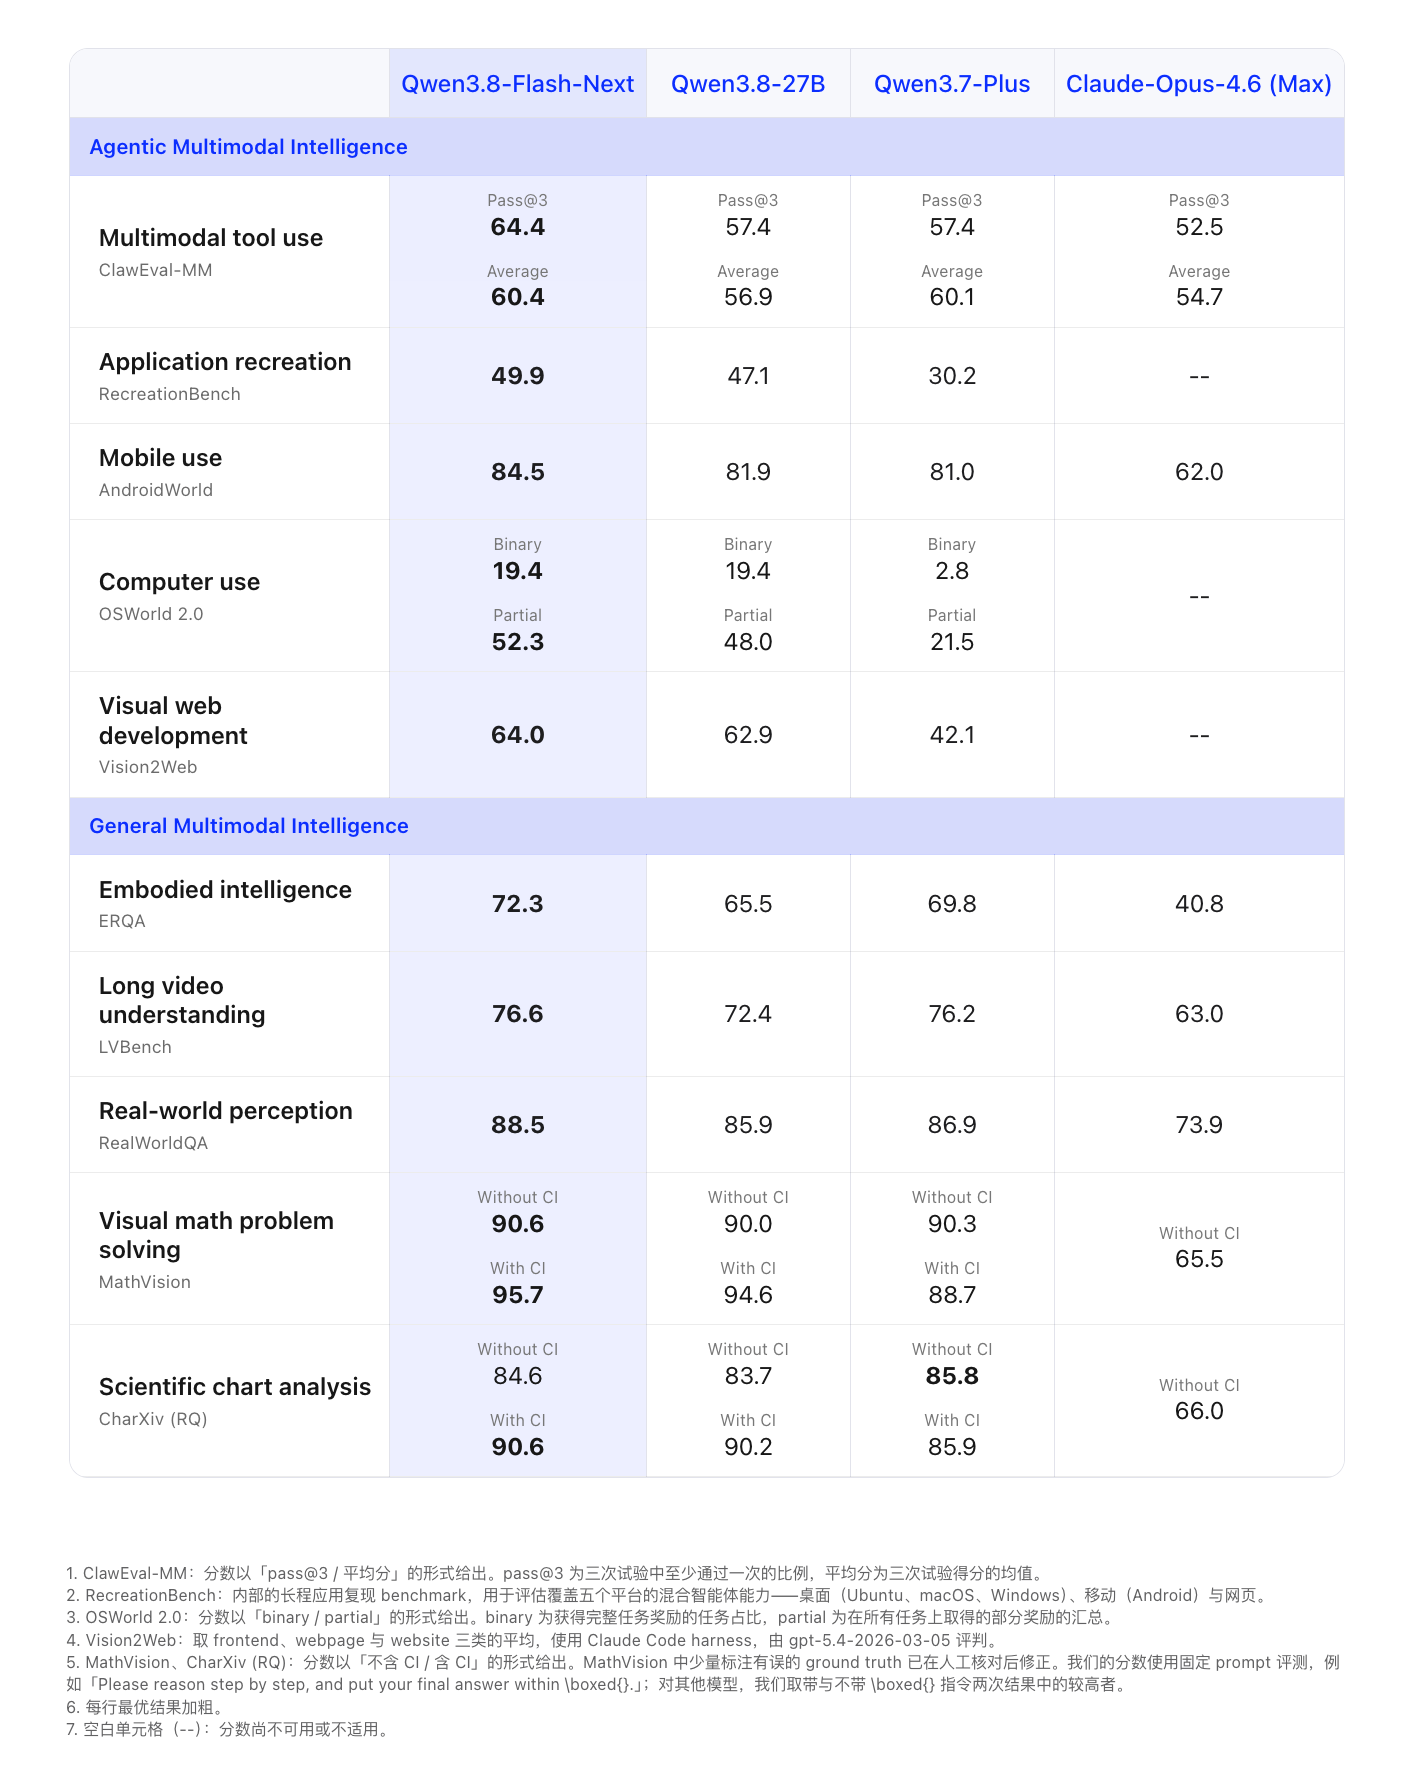
متعدد الوسائط:
بنية الموديل:
أداء موديل Base:
غادي يتوفر Qwen3.8-Flash قريباً فـمنصة Qwen AI، مع تقديم خدمات API للعموم، بثمن 1 يوان لكل مليون Tokens ديال الإدخال و3 يوان لكل مليون Tokens ديال الإخراج.
تفتحات أوزان الموديل كمصدر مفتوح فـمنصتي Hugging Face وModelScope نهار 26 غشت مع 23:00 بتوقيت بكين، وتطلقات فـنفس الوقت نسخة مكمّمة بـFP8. وQwen3.8-Flash-Next كيدعم افتراضياً سياق 1M، وفيه أدوات رسمية مدمجة.
المراجع:
التقرير التقني: https://github.com/ QwenLM / Qwen3.8-Flash-Next / blob / main / tech_report.pdf
المدونة التقنية: https://qwen.ai/ blog?id=qwen3.8-flash-next
Hugging Face: https://huggingface.co/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921FsyOPe& ;amp;amp;file=Qwen3.8-Flash-Next
ModelScope: https://modelscope.cn/models/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921XAP2dV& ;amp;amp;file=Qwen3.8-Flash-Next