

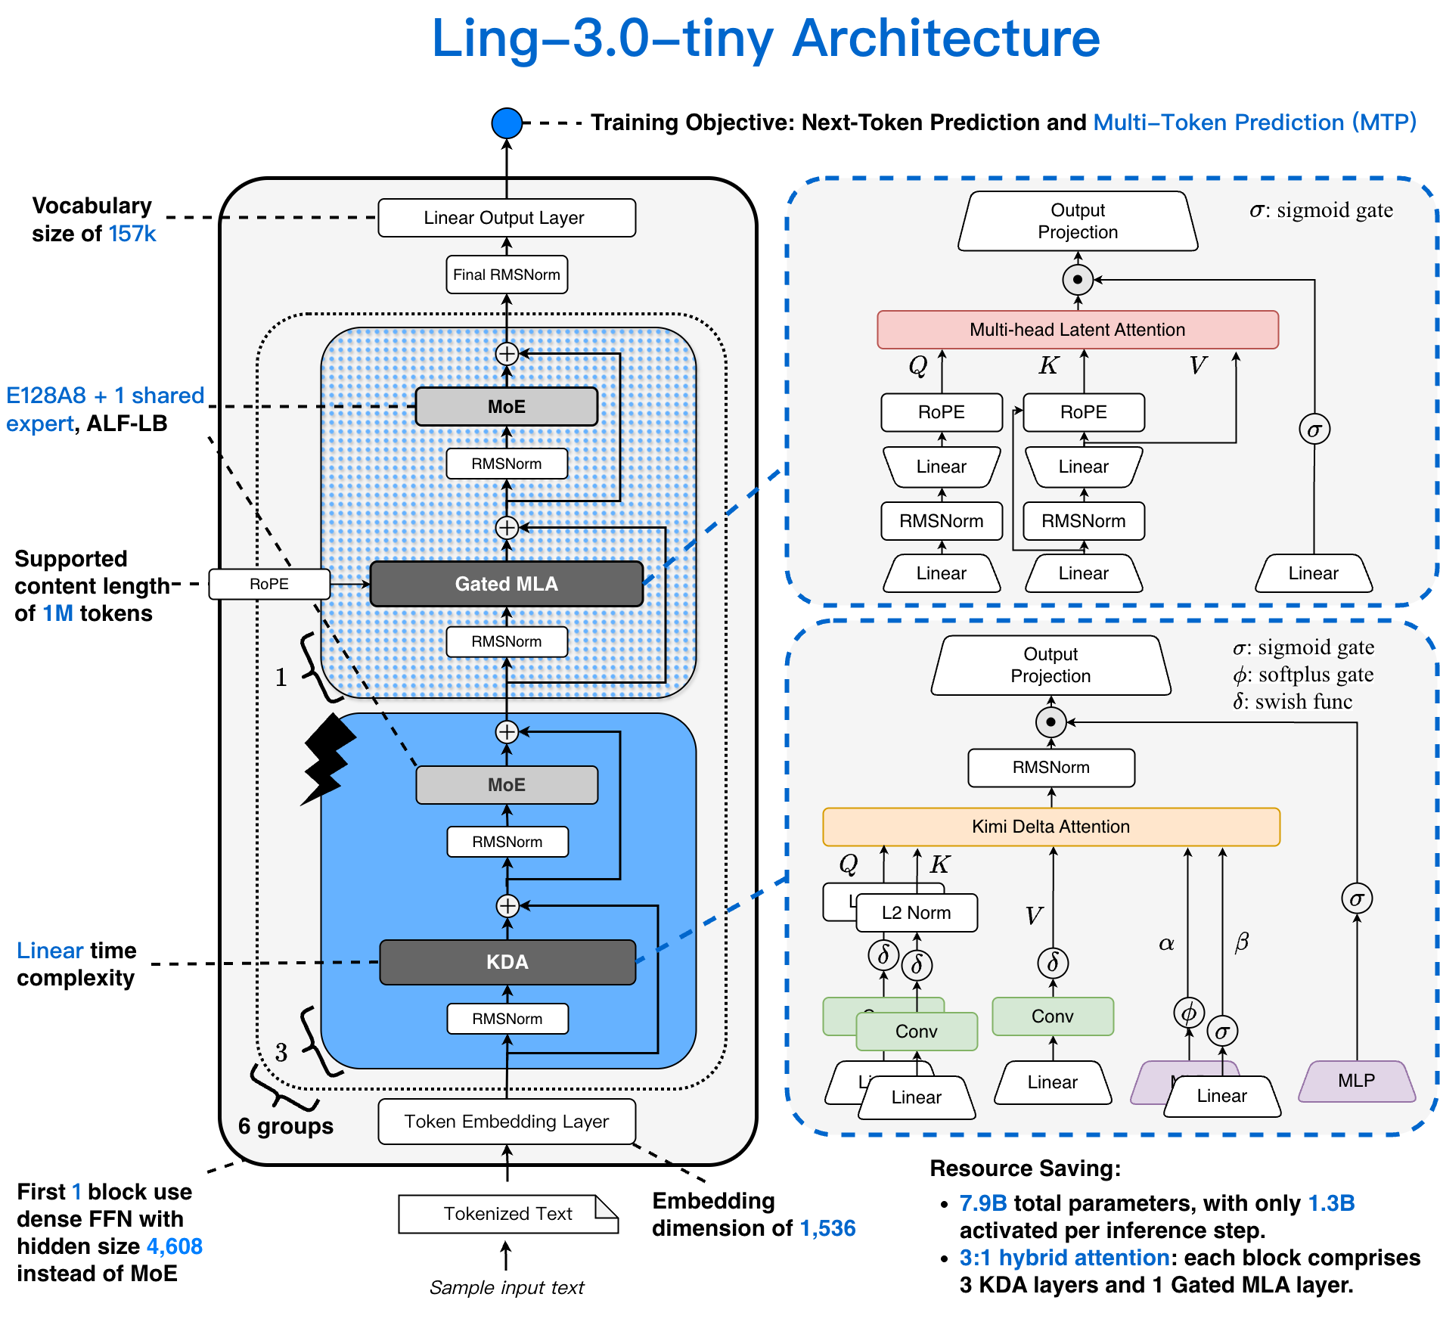
蚂蚁百灵 حلّات اليوم موديل Ling-3.0-tiny مفتوح المصدر على منصة Hugging Face. هاد الموديل مبني على بنية MoE خفيفة ومخلوطة للاستدلال، بإجمالي 7.9B من المعاملات، مع تفعيل 1.3B من المعاملات فكل Token. الفريق الرسمي وفر نسخ الأوزان BF16 وFP8 وINT4، باش تلائم احتياجات النشر على منصات مختلفة.
حسب المعطيات، Ling-3.0-tiny كيركز على الاستدلال بتكلفة منخفضة، وكيستعمل بنية خطية مخلوطة وفعالة، بحيث كيرصّ KDA (Kimi Delta Attention) وMLA (Multi-Head Latent Attention، الانتباه الكامن متعدد الرؤوس) بالتناوب بنسبة 3:1. وكيعتمد على شبكة أمامية متناثرة MoE (FFN) فيها 128 خبير موجّه (routed experts)، باش يوازن بين القدرة على معالجة السياق وتكلفة الحساب.
هاد الموديل كيدعم وضع الاستجابة السريعة ووضع الاستدلال متعدد المراحل، ومصمم خصيصاً للنشر المحلي. الفريق الرسمي تحقق من خدمتو على حواسيب بحال NVIDIA DGX Spark وApple Silicon MacBook وMac mini. وعلى MacBook بمعالج M4 Pro، كيقدر يوصل لسرعة استدلال تقريباً بين 86 و90 Token/s، ومع سياق بطول 8K، كتوصل ذروة استهلاك الذاكرة لحوالي 8.34 GiB.
المرجع:
inclusionAI/Ling-3.0-tiny · Hugging Face