

زيبو كتطلق اليوم رسمياً GLM-5.3، ومقارنةً مع GLM-5.2، الموديل الأساسي ما تبدلش، ولكن من خلال Scaling ديال ما بعد التدريب، تطوّر الحدّ الأعلى للذكاء ديال الموديل بشكل كبير: عشرات المرات أكثر من بيئات المهام طويلة المدى، أنواع أغنى وأكثر تنوعاً من البيئات، ومدة أطول بزاف ديال ما بعد التدريب.
مقارنةً مع الجيل السابق، القدرات الجديدة ديال GLM-5.3 كتضم:
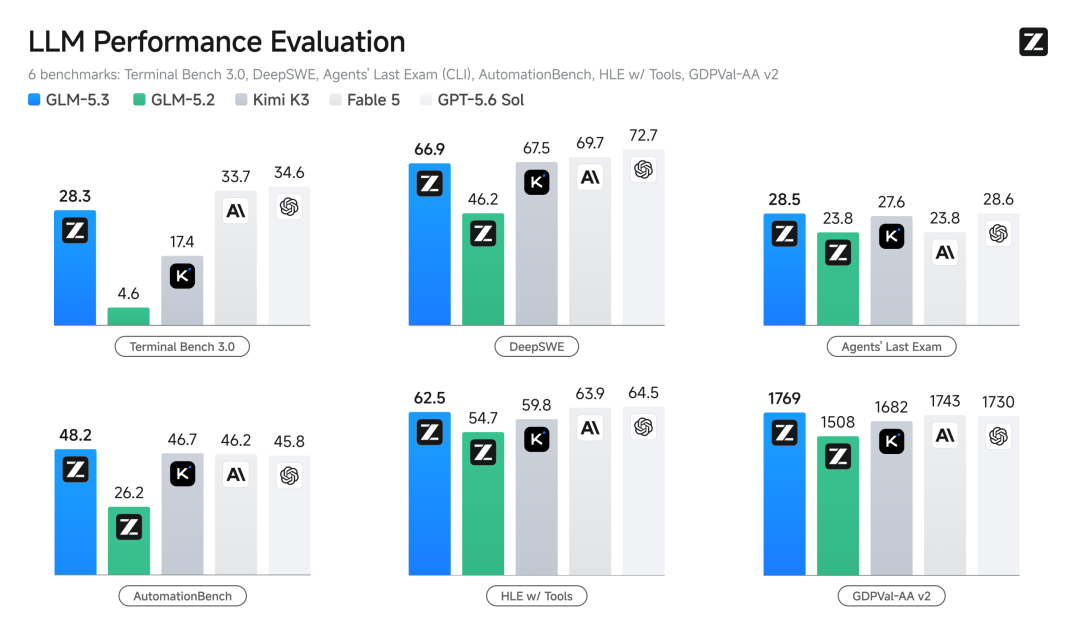
قدرات أقوى فالبرمجة. GLM-5.3 هو أقوى موديل مفتوح المصدر فالبرمجة، وحقق تحسناً بنسبة 50% مقارنةً مع GLM-5.2 فالتقييمات الداخلية المبنية على التجربة العملية، كما تصدّر النماذج المفتوحة المصدر فاختبارات الأداء العلنية، بما فيها Terminal Bench 3.0 وAgents' Last Exam (CLI).
قدرات فالأمن السيبراني. فمهام أمنية بحال مراجعة الكود بطريقة White-box واكتشاف الثغرات، كان أداء GLM-5.3 مماثلاً لـ Mythos 5، وبيّن إمكانيات قوية فسيناريوهات الدفاع فالأمن السيبراني.
Scaling ديال ما بعد التدريب. جميع التحسينات المذكورة جاية من ما بعد التدريب. وبالاعتماد على IndexShare وSAO، وعلى الجيل الجديد من إطار Slime اللي كيتطور باستمرار، دفعات زيبو بفعالية فالتعلم المعزز فوق نفس الموديل الأساسي تماماً ديال GLM-5.2، ومن المحتمل أن زيبو مازال ما استغلاتش كامل الحدّ الأعلى للذكاء ديال هاد الموديل الأساسي.
مفتوح المصدر. زيبو غتفتح أوزان الموديل بعد أسبوعين من الإطلاق، ومن قبل غتكمل تقييم السلامة وتقوية الموديل.
زيبو كتقول إن GLM-5.3 هو حالياً أعلى موديل مفتوح المصدر ترتيباً فعدد من اختبارات الأداء الرئيسية، وإن قدراتو فالبرمجة والوكالة قريبة من Claude Fable 5، بينما التجربة العملية ديالو فالبرمجة كتفوق باقي النماذج الصينية.
فـ Terminal-Bench 3.0، اللي كيقيس قدرة الموديل على إنجاز مهام معقدة فبيئات الأجهزة الحقيقية، ارتفعت النقطة ديال GLM-5.3 من 4.6 لـ 28.3؛
فـ DeepSWE v1.1، اللي كيركز على هندسة البرمجيات طويلة المدى والتعديلات المستمرة على الكود، طلعات النقطة من 46.2 لـ 66.9؛
فـ Agents' Last Exam، اللي كيغطي بزاف ديال السيناريوهات المهنية الحقيقية وكيشدد على التعاون بين الأدوات والمهام طويلة المدى، طلعات النقطة من 23.8 لـ 28.5؛
فـ GDPval-AA v2، اللي كيغطي 44 مهنة وكيقيّم المعرفة المهنية الحقيقية والعالية القيمة، حصل على 1,769 نقطة، وبيّن قدرة على تنفيذ المهام المهنية ناتجة عن القدرات اللي كتظهر بفضل البرمجة.
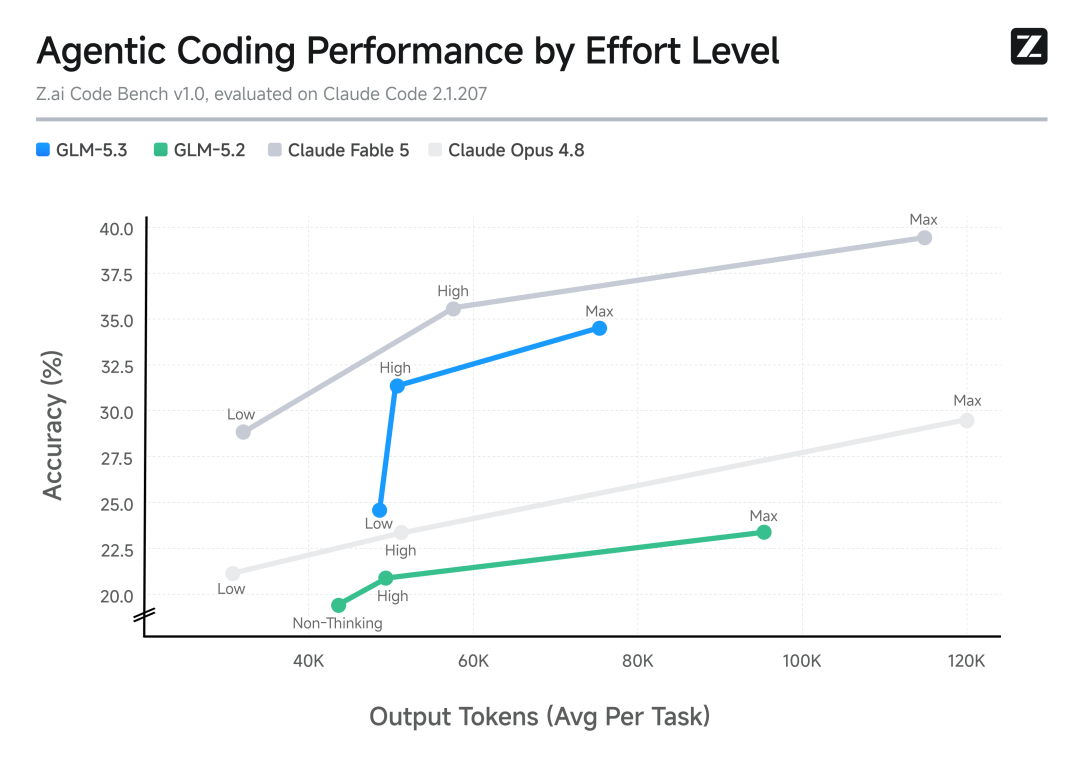
تقييم Z.ai Code Bench، اللي طوّراتو زيبو داخلياً، كيقيس التجربة العملية الشاملة ديال الموديل فسيناريوهات البرمجة الحقيقية. كيتحط الموديل فبيئة تطوير محلية معقدة، وكيخدم مهام من البداية للنهاية فمستويات مختلفة ديال التفكير، باش تكون التجربة أقرب للاستعمال الفعلي ديال Coding Agent من طرف المطورين.
كتبيّن نتائج الاختبار أن GLM-5.3 حقق توازناً أحسن بين الفعالية واستعمال الـToken. فالمستوى High، وصل GLM-5.3 لدقة 31.4%، متجاوزاً أعلى مستوى ديال Claude Opus 4.8 اللي وصل لـ29.5%. وكل مهمة كتخرج فالمتوسط حوالي 5 آلاف tokens، بينما Opus 4.8 كيحتاج تقريباً 12 ألف tokens، وهاد الشي كيعني أن GLM-5.3 يقدر يكمل المهام بمسار تنفيذي أقصر.
ابتداءً من اليوم، ولات أدوات البرمجة الرسمية ديال زيبو ZCode وأداة رفع الإنتاجية AutoClaw متاحة، كما تفتح الاشتراك والاستفادة لجميع المستخدمين ديال GLM Coding Plan.
منصات البرمجة TraeWork / TraeCode / 扣子، WorkBuddy / CodeBuddy، Qoder / QwenWork، CatPaw، JoyCode وOpenCode وغيرها، فتحت تجربة مبكرة.
الـAPI غتكون متاحة قريباً، وأوزان الموديل كاملة غتتحلّ كمصدر مفتوح فغضون أسبوعين. وقبل ذلك خاص استكمال تقوية السلامة الضرورية، للحد قدر الإمكان من قدراتو المحتملة على الهجوم والحفاظ على قيمتو الدفاعية.
اليوم مع 13:00، غيتعاود يتصفّر رصيد GLM Coding Plan لجميع المستخدمين، وغيبان الرصيد كامل راجع فخلفية جميع المستخدمين ضمن «إحصائيات الاستعمال».