

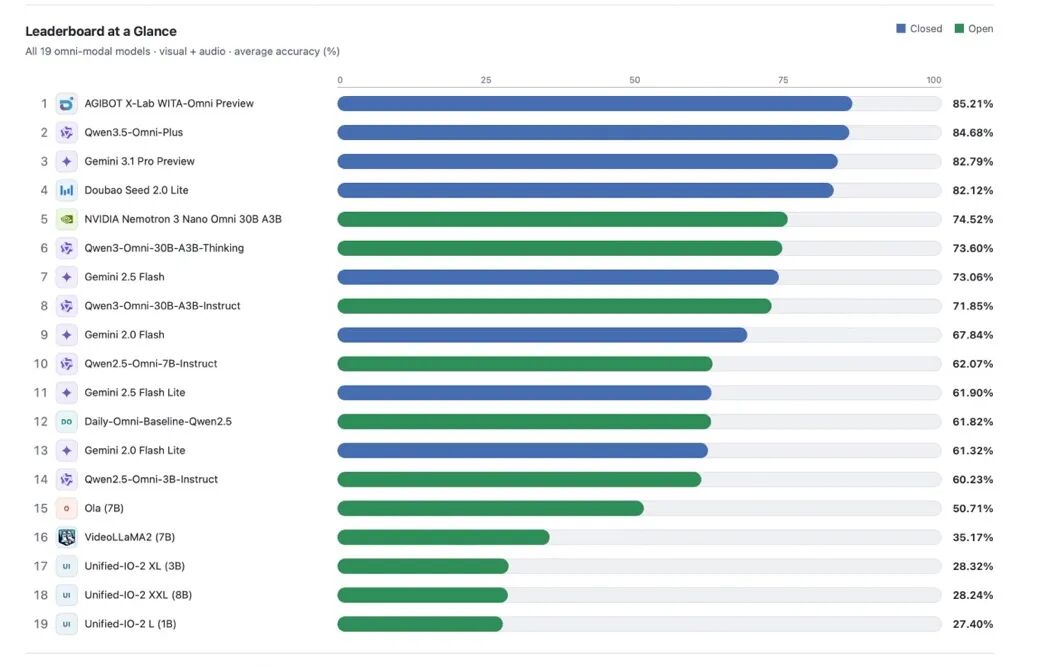
حسب ما جا فالحساب الرسمي ديال AGIBOT التابع لـ Zhiyuan على WeChat، مؤخراً تعلنات نتائج آخر تقييم للترتيب الموثوق DailyOmni الخاص بالفهم متعدّد الوسائط فالعالم المجسّد. النموذج المجسّد الأصلي متعدّد الوسائط WITA-Omni Preview، اللي طوّراتو Zhiyuan، تصدّر الترتيب بنتيجة إجمالية قدرها 85.21 نقطة، بفضل القدرات المتقدمة ديالو فالفهم المشترك للصوت والصورة والاستدلال الزمني، وتفوّق على نماذج رائدة فالصين والعالم بحال Qwen وGemini وDoubao وNVIDIA، كما جا الأول فـ6 مؤشرات من أصل 8 مؤشرات فرعية.
وحسب المعلومات اللي حصلات عليها IT之家، DailyOmni هو ترتيب موثوق من طرف القطاع لاختبار التزامن الزمني بين الصوت والصورة وقدرة الاستدلال المشترك بين الوسائط. وبخلاف مهام التقييم العادية اللي كتستهدف الصور والنصوص أو الفيديوهات القصيرة، كيستعمل هاد الترتيب بزاف ديال المواد السمعية البصرية من بيئات حقيقية ومفتوحة. والاختبار الأساسي كيركّز على قدرة النموذج يدمج الصورة البصرية مع المعلومات الصوتية ديال المحيط، ويحدّد بدقة العلاقة بين الصوت والصورة، وترتيب الأحداث، والدلالات المشتركة بين الوسائط، وهي قدرات إدراكية كتوافق بشكل كبير المتطلبات الأساسية ديال تفاعل الروبوتات الشبيهة بالبشر مع الناس ففضاءات مادية حقيقية.
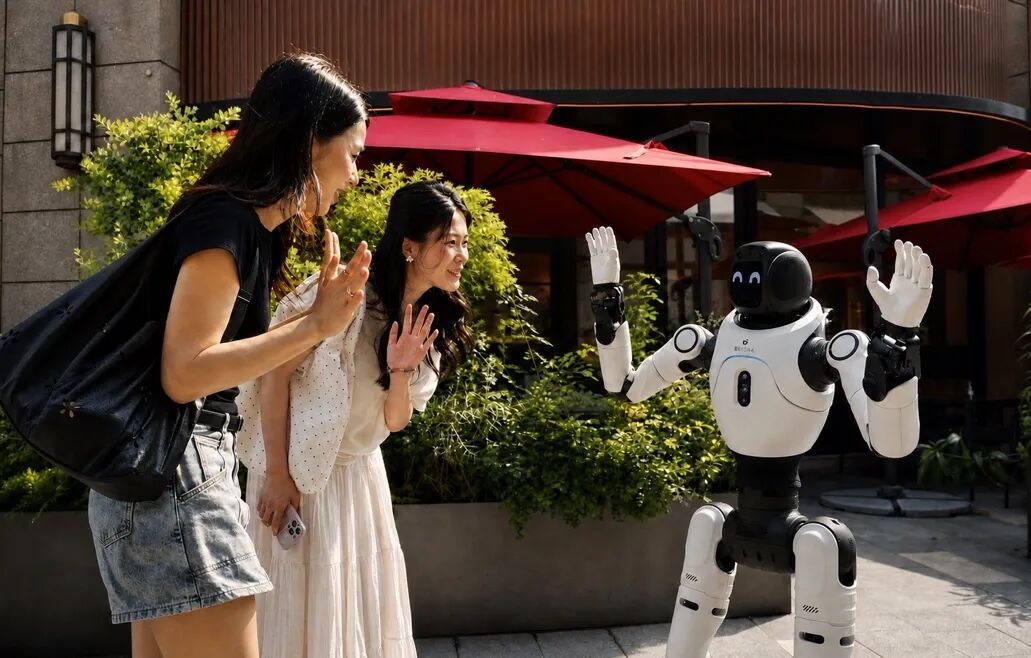
وأكدات الجهة الرسمية أن السرّ الرئيسي فتميّز WITA-Omni هو أنه ماشي غير نموذج محادثة تدار داخل روبوت، بل كيرفع الحركات والتعابير الجسدية لمستوى مخرجات أساسية موازية للصوت، وكيستعمل نموذج أصلي شامل من البداية للنهاية باش يحرّك الإدراك واتخاذ القرار والتعبير بشكل موحّد. وبهذا، كتتوسّع صيغة Thinker–Talker أكثر عبر بنية Thinker–Talker–Actor الموجّهة للمخرجات المجسّدة.
تميّز WITA-Omni ما كيعتمدش غير على حجم النموذج، بل نابع من منظومة بيانات متعددة المستويات وطرق تدريب مخصّصة، مبنية حول التفاعل المجسّد متعدّد الوسائط. فمرحلة التدريب المتوسط، استعمل WITA-Omni ما مجموعه عشرات الملايين من الساعات ديال البيانات متعدّدة الوسائط المفتوحة والخاصة، وطور القاعدة النصية والبصرية القوية إلى نموذج شامل متعدّد الوسائط قادر على أنه «يسمع، يفهم اللي كيشوف، ويدير استدلالاً مشتركاً بين الصوت والصورة».
وفوق هاد الشي، غالباً ما كتكون بيانات الصوت والصورة المتاحة للعموم ناقصة من ناحية تبديل الأدوار فالتفاعل الحقيقي، وتوقيت الاستجابة، والمعلومات المتعلقة بالحركات والتعابير، وهاد الشي كيصعّب تدريب نموذج للتفاعل المجسّد من البداية للنهاية بشكل مباشر. ولهذا، بنت Zhiyuan مجموعة بيانات شاملة متعدّدة الوسائط، كبيرة وعالية الجودة، متمحورة حول الإنسان وموجّهة لسيناريوهات التفاعل الحقيقية، مع الحفاظ الكامل على العلاقات الزمنية الطبيعية بين الصوت والصورة واللغة والحركة والتعبير.