

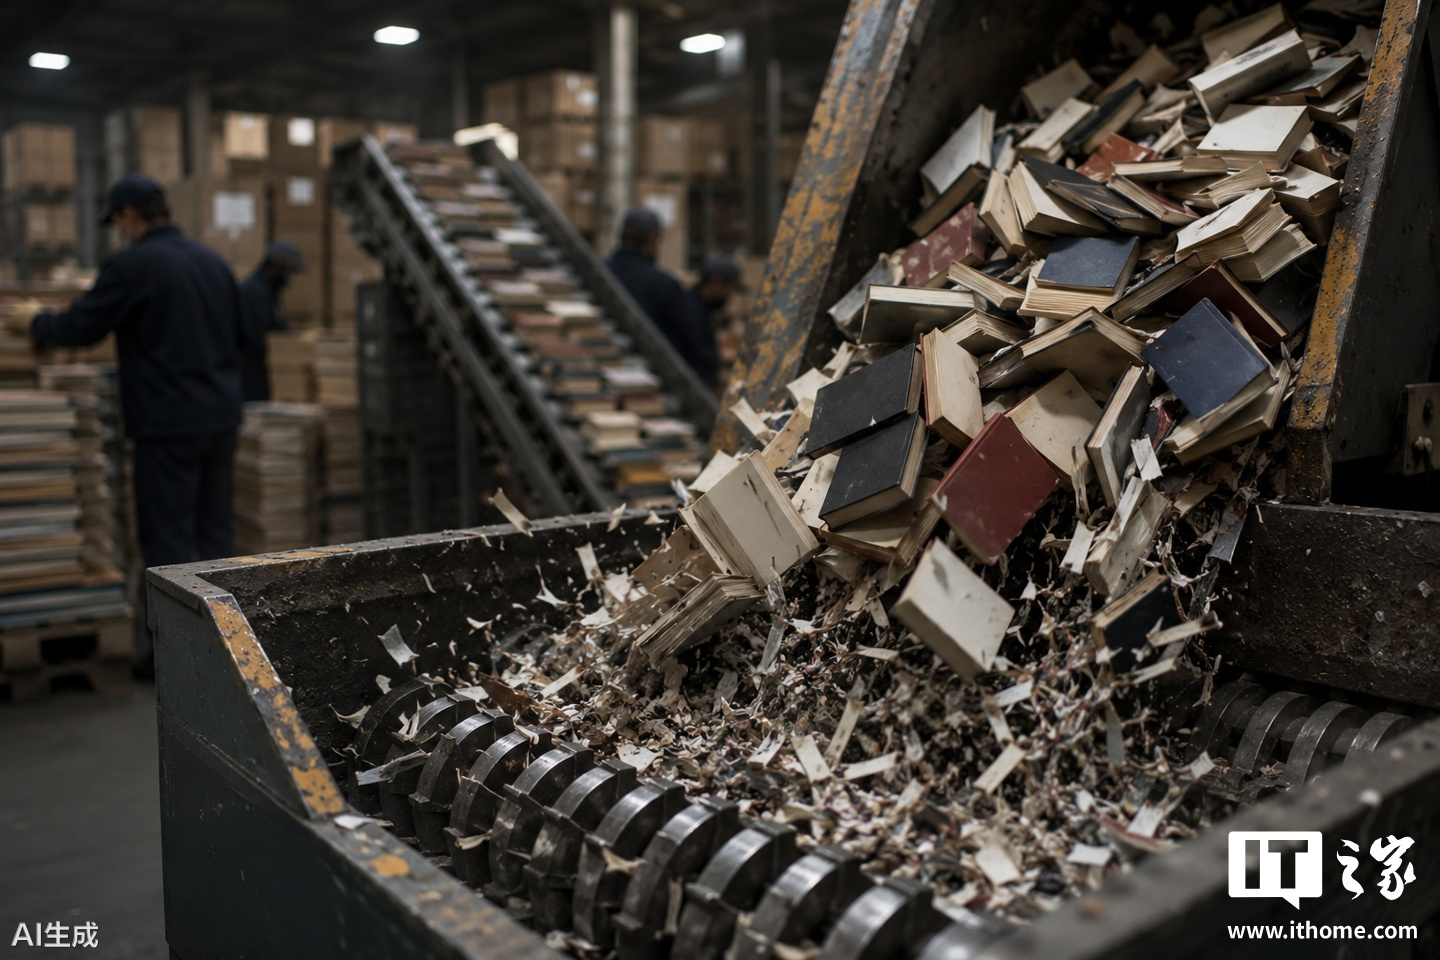
من بعد ما ساهمات شركات الذكاء الاصطناعي فتصعيد الضغط على موارد الذاكرة والتخزين، باين أنها دابا ولات كتشوف حتى فالتراث الأدبي ديال البشرية. وذكرت وسيلة التحقيق 404 Media مؤخراً أن بزاف ديال شركات الذكاء الاصطناعي كتشري الكتب المستعملة بكميات كبيرة عن طريق وسطاء، باش تحصل على بيانات تدريب عالية الجودة لتدريب نماذج الذكاء الاصطناعي، وفنفس الوقت تتفادى ردود الفعل السلبية من الرأي العام.
تطور الذكاء الاصطناعي ما يقدرش يستغنى على كميات هائلة من البيانات، ولكن ماشي جميع البيانات عندها نفس القيمة؛ العامل الحاسم هو الجودة. فالسّنين الأخيرة، عامر الإنترنت بمحتوى رديء مولّد بالذكاء الاصطناعي، واللي كيتسمى عادةً «الزبال ديال الذكاء الاصطناعي». هاد الشي ما لوّثش غير بيئة البيانات، بل نقص حتى من فعالية التعلم المستمر ديال الذكاء الاصطناعي. وبهذا السبب، بدات الشركات الرائدة فالذكاء الاصطناعي كتقلب من جديد على محتوى من إبداع البشر، خصوصاً الكتب الورقية المنشورة قبل 2022، حيث من المحتمل أكثر تكون أعمال أصلية وما وصلهاش تلوث المحتوى المولّد بالذكاء الاصطناعي.
فالحقيقة، استعمال الشركات ديال الذكاء الاصطناعي للكتب الورقية فتدريب النماذج ماشي جديد. فشركة Anthropic، اللي كتعتبر من الشركات الرئيسية ديال الذكاء الاصطناعي المتورطة حالياً فدعاوى حقوق النشر، صرفات ملايين الدولارات فشراء كميات كبيرة من الكتب الورقية، باش تستخرج منها المحتوى وتدرّب نموذج Claude AI، ومن بعد دمّرات هاد الكتب. وحسب المعطيات، الشركة شرت كميات كبيرة من الكتب من Better World Books. ورغم أن المحكمة اعتبرات استعمال الكتب الأصلية فتدريب الذكاء الاصطناعي «استعمالاً عادلاً» بموجب قانون حقوق النشر، إلا أن Anthropic انتهكات حقوق المؤلفين والناشرين بسبب احتفاظها لمدة طويلة بقاعدة بيانات فيها 700 مليون كتاب مقرصن، وتحكم عليها فالنهاية بتعويض وصل حتى لـ 15 مليار دولار (ملاحظة: كيساوي تقريباً 101.62 مليار يوان صيني حسب سعر الصرف الحالي).
ووقع جدل مشابه حتى مع Google. فمؤخراً، رفع تحالف ديال الناشرين دعوى قضائية ضد Google، واتهمها باستعمال ملايين الكتب المحمية بحقوق النشر بلا ترخيص لتدريب نموذج Gemini AI.
قاعدة البيانات الإلكترونية ISBNdb، اللي فيها معلومات على فهرس كيتجاوز 1.11 مليار كتاب، كانت منذ مدة طويلة منصة مهمة للباعة ديال الكتب والمكتبات والموزعين. ومع التطور السريع لقطاع الذكاء الاصطناعي، بدات ISBNdb حتى هي كتبدل اتجاه أعمالها، وطلقت خدمة خاصة موجهة للشركات ديال الذكاء الاصطناعي لشراء الكتب بكميات كبيرة.
وقالت 404 Media إن حجم الطلبات كيتراوح بين شراء 1000 كتاب فمرة وحدة وشراء 1 مليون كتاب فمرة وحدة.
وقال بائع كتب مهني فضّل ما يكشفش على سميتو إن مبيعات الكتب عرفات نمواً غير مسبوق من شهر 4 هاد العام. فالأوقات اللي كانت فيها التجارة مزيانة، كان كيبيع غير حوالي 20 كتاب فالأسبوع؛ أما فالشهور الأخيرة، فقد قفزات المبيعات الأسبوعية لمئات الكتب، أي حوالي خمسة أضعاف المبيعات العادية.
وباعة آخرون فالمنصات ديال تجارة الكتب المستعملة، بحال Alibris وBiblio، قالو حتى هما إنهم لاحظو ظاهرة مشابهة ديال الشراء بالجملة.
ورغم أنه ما كاين حتى دليل قاطع كيأكد أن هاد المشتريات جاية بالضرورة من ISBNdb أو من شي شركة معينة ديال الذكاء الاصطناعي، إلا أن فيها بزاف ديال الأمور غير العادية. فمثلاً، الكتب اللي كيتشراو بكميات كبيرة كلها تقريباً فيها الرقم الدولي المعياري للكتاب (ISBN)، وهو رمز مكوّن من 13 رقم وكيعتبر المعرّف الفريد للكتب على الصعيد العالمي.
وزيد على هاد الشي، هاد المشتريات ما فيها تقريباً حتى تفضيل للموضوع أو النوع أو المؤلف؛ فالروايات والكتب الدراسية والكتب المتخصصة كاملين داخلين فنطاق الشراء. والأكثر إثارة للاستغراب هو أن المشترين باين ما كيهتموش نهائياً بالثمن؛ حتى إلى كان شي كتاب أغلى بوضوح من ثمن السوق، كيشريوه مباشرة.
وخلال دعوى حقوق النشر ضد Anthropic، أكد توم هارفي (Tom Harvey)، اللي سبق ليه شارك فمشروع Google Books ومن بعد تولّى مشروع الرقمنة «Project Panama» ديال Anthropic، أن Anthropic عيّنات عدة شركات متخصصة فمسح الوثائق باش ترقمن الكتب الورقية.
ومن بين الشركات المتعاونة كانت Datamation Information Services، اللي كتقدم جوج أنواع من خدمات رقمنة الكتب: المسح غير التخريبي والمسح التخريبي.
المسح غير التخريبي كيستعمل عادةً ماسحات كتتصوّر من الفوق، أو ماسحات مسطحة، أو أجهزة مسح على شكل V، وكيتم فيه تحويل الكتاب إلى صيغة رقمية بلا ما يتفكك. أما المسح التخريبي، فكيتم فيه تفكيك الكتاب مباشرة، ومن بعد كتدوز كل صفحة فماسح صناعي سريع.
وحيث إن المسح التخريبي أسرع وأقل تكلفة، فشركات الذكاء الاصطناعي كتختار هاد الطريقة غالباً، والنتيجة هي تدمير ملايين الكتب الورقية بعد تفكيكها.
ما كاين حتى شك أن الكتب الورقية بالنسبة للذكاء الاصطناعي عبارة عن خزينة ضخمة ديال المعرفة. ولكن هاد الممارسة حتى هي بدات كتثير مزيداً من الجدل الأخلاقي.
كيشوف المنتقدون أنه مازال ما واضحش واش شركات الذكاء الاصطناعي كتميز أثناء الرقمنة بين الكتب العادية والكتب الثمينة أو الكتب اللي سالات طبعتها. وإذا تدمّرات هاد الكتب النادرة، ممكن تخرج نهائياً من التداول.
والمشكل الأكبر هو أن المحتوى اللي كيتسكانا من بعد كيدخل كامل لقواعد البيانات الخاصة بشركات الذكاء الاصطناعي، وكيستعمل غير فالتدريب ديال الذكاء الاصطناعي، بينما عامة الناس ما عندهاش إمكانية الولوج ليه.
وهذا كيعني أن الناس يمكن يقدرو يحصلو على ذكاء اصطناعي أكثر ذكاءً، ولكن الثمن ممكن يكون هو أن جزءاً كبيراً من الموارد المعرفية اللي جمعتها البشرية ما يبقاش متاحاً ومفتوحاً للأجيال المقبلة.