

حساب مجتمع ModelScope ديال «魔搭 ModelScope 社区» التابع لعلي بابا كلاود علن البارح فالليل (نهار 12) أن فريق Qwen ديال علي بابا حلّ رسمياً أوزان موديل Qwen3.8-2.4T-A95B.
هاد المرة هي الأولى اللي كيتحلّو فيها أوزان موديل من مستوى Qwen-Max: الموديل فيه 2.4T من المعاملات فالمجموع، وكيفعّل 95B من المعاملات مع كل Token، وكيدعم أصلياً سياقاً فيه 262,144 Token، ويمكن توسيعو حتى لـ 1,010,000 Token.
Qwen3.8 كيكمل المعمارية الهجينة ديال Qwen3.5، مع تركيز على الرفع من القدرة على إنجاز المهام كاملة من البداية للنهاية فـ البرمجة، والخدمة المكتبية، والبحث العلمي، ومهام الوكلاء طويلة المدة. والنسخة السحابية الرسمية Qwen3.8-Max مبنية على هاد الموديل المفتوح الأوزان، ومضاف ليها قدرات أكثر لبيئات الإنتاج.
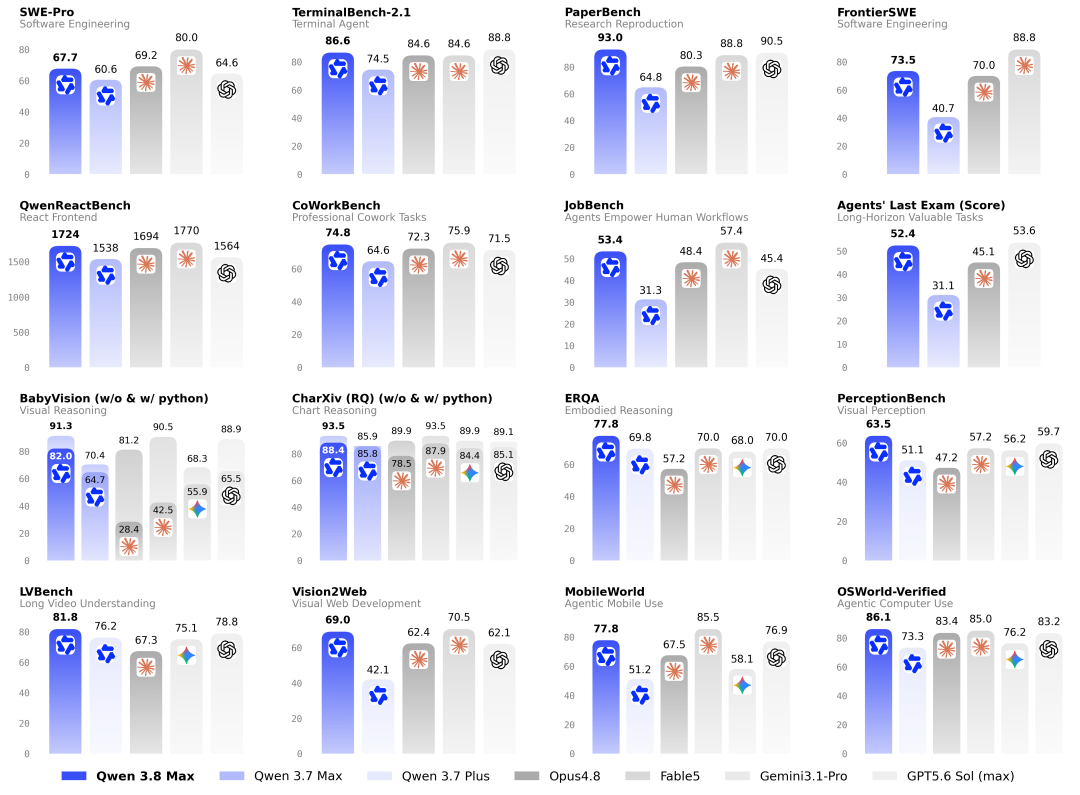
التقييمات الرسمية شملت برمجة الوكلاء، والوكلاء العامّين، والخدمة المتخصصة، والسياق الطويل؛ وبالمقارنة مع موديلات بحال Opus 4.8 وFable 5 وGPT 5.6 Sol، النتائج كانت متفاوتة من اختبار لآخر، مع تسجيل نتائج مرتفعة ضمن الموديلات المذكورة فـ Benchmarkات بحال PaperBench وIFBench.
الروابط المشار ليها لفوق هي:
الموديل: https://modelscope.cn/models/Qwen/Qwen3.8-2.4T-A95B
المدونة: https://qwen.ai/blog?id=qwen3.8
Qwen Studio: https://chat.qwen.ai
Qwen3.8-2.4T-A95B هو موديل لغوي سببي، فيه 2.4T من المعاملات فالمجموع، وكيتم تفعيل 95B مع كل Token. كل طبقة MoE فالموديل فيها 512 خبير، وكل Token كيختار 10 خبراء موجّهين، وكيتم تفعيل خبير مشترك واحد فالنفس الوقت.
الموديل داز حتى من تدريب MTP متعدد المراحل (Multi-Token Prediction)، باش يوفّر لمحركات الاستدلال اللي كتدعم هاد الآلية القدرة على التنبؤ بعدة Tokenات لاحقة.
وحسب التقديم، التدريب اللاحق المكتبي وتدريب الوكلاء ديال Qwen3.8-Max كيتلخّص فثلاث مراحل:
التوسيع المستمر للبيئات الحقيقية، مع الفصل بينها حسب هاد الأبعاد المستقلة: المهمة (Task) (مهمة وحدة → مهام متعددة → مهام كتمتد على أيام)، وفضاء العمل (Workspace) (ملفات متعددة → مجلدات هرمية → مجلدات معقدة وغير متجانسة)، وHarness (فئات وإصدارات ومهارات مختلفة). وبهذا كيقدر عدد البيئات يكبر بشكل تركيبي وطبيعي، بلا الاعتماد على دمج مخصص لكل وحدة.
بناء نظام موحّد للمكافآت كيدمج داخلو طرق التحقق غير المتجانسة ديال المهام الحقيقية. هاد النظام كيشمل التحقق المبني على التنفيذ، وتقييم النصوص والمخرجات البصرية المَرْندَرة باستعمال rubric، وزيد عليها الفحوصات الوكيلة. وحّدنا أشكالاً وأنماطاً متعددة داخل نظام مكافآت واحد، ووفّرنا إشارة مكافأة موحّدة وموثوقة لجميع البيئات، مع إزالة عدم الاتساق الملازم لصيانة أدوات تحقق خاصة بكل مهمة.
بناء موازن بيانات online كيعيد تركيب كل batch، باش يكون التوزيع ديالو متوازناً بدرجة كبيرة حسب المهمة، والصعوبة، وفضاء العمل، وHarness، وكيقلل من تفاوت التدرجات بين batches، وبهذا كيدعم توسيع القدرة الحاسوبية لتدريب التعلم المعزز بشكل مستقر ومستمر.