أعلنت Mistral AI أمس (4 غشت) عن إطلاق نموذج الذكاء الاصطناعي لمراجعة المحتوى Shieldstral، بإجمالي 3B (3 مليارات) من المعلمات، مع أوزان مفتوحة، وبموجب ترخيص Apache 2.0.
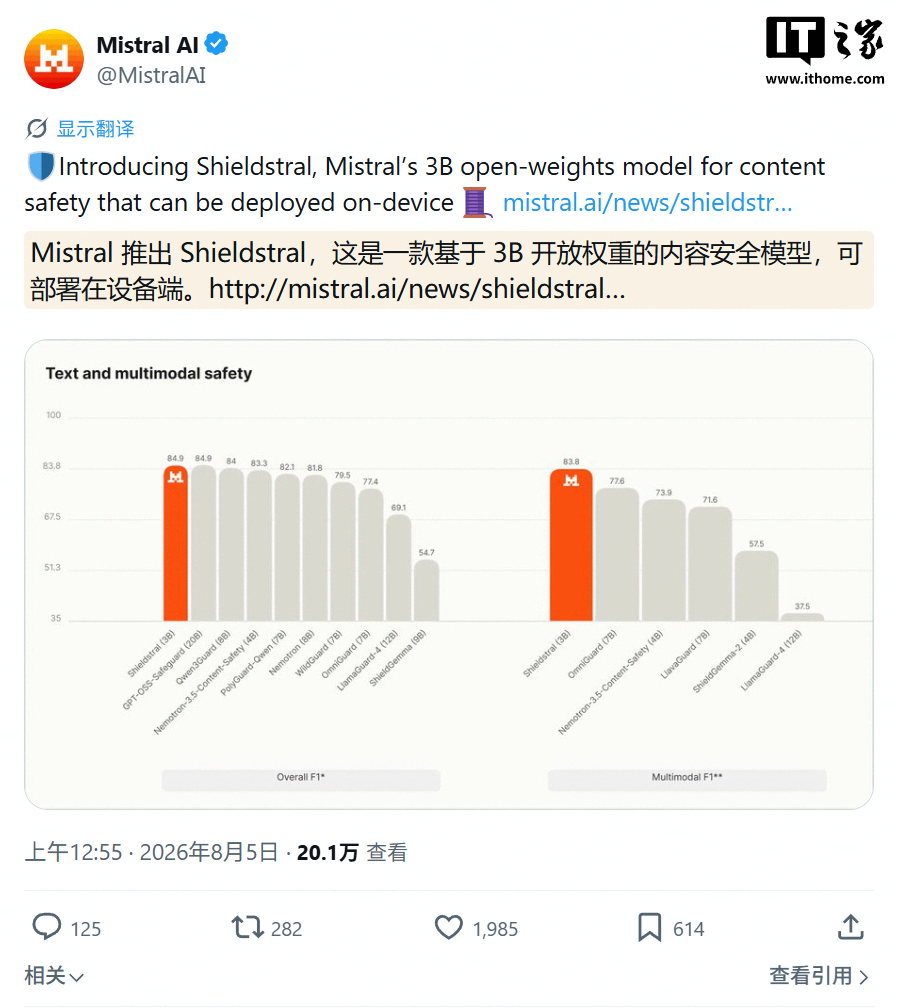
النموذج متوفر على منصة Hugging Face، وكيَدعم 12 لغة، ويقدر يخدم على وحدة GPU وحدة بسعة 16GB. وكتقول Mistral إن أداء هاد النموذج فمجال أمان المحتوى كيقارب أداء نماذج مفتوحة أكبر منو بـ 7 مرات، وحقق كذلك مستوى SOTA فمجال مراجعة المحتوى متعدد الوسائط.
ملاحظة: SOTA هي اختصار لـ state-of-the-art، وكتعني مجموعة النماذج أو الخوارزميات اللي كتقدم أفضل أداء وأعلى مستوى فمهمة محددة من مهام الذكاء الاصطناعي أو فاختبار معياري. وكيستمر هاد المستوى فالتغير مع تطور التكنولوجيا وصدور أبحاث جديدة.
وأشارت Mistral إلى أن أغلب نماذج الحماية كتثبت تصنيفات الأضرار داخل أوزان النموذج. ومنين كيتبدل سيناريو استعمال المنتج، كيحتاج المطورون غالباً يعاودو يدربو النموذج.
أما Shieldstral، فكيحط سياسة المراجعة داخل المحتوى المدخل: يقدر المشغّل يكتب سؤالاً بصيغة «نعم أو لا»، ويضيف وصفاً لسيناريو التقييم ودرجة الصرامة، ومن بعد كيولد النموذج درجة أمان معايرة انطلاقاً من رمز إخراج واحد.
كيحوّل النموذج كل مهمة مراجعة لسؤال ثنائي، والمدخلات كتضم 3 حقول معنونة:
<Instruct>: كيشرح سيناريو التقييم ودرجة الصرامة.
<Query>: كيطرح سؤالاً واحداً بصيغة «نعم أو لا»، بحال: «واش هاد المحتوى كيروج للعنف الجسدي؟»
<Document>: كيقدم المحتوى اللي خاصو المراجعة، وقد يكون مطالبة، أو جواباً، أو مزيجاً من المطالبة والجواب، أو صورة مرفقة بنص اختياري.
أثناء الاستدلال، كيقرأ النموذج غير القيم المنطقية للرمزين «نعم» و«لا»، ومن بعد كيطبعها بواسطة softmax باش يحولها لدرجة مستمرة، وكيصدر حكماً ثنائياً باعتماد 0.5 كعتبة. وكيقدر هاد الأسلوب يغطي تصنيف المطالبات، ومراجعة الأجوبة، واكتشاف رفض الإجابة، واكتشاف السمية.