

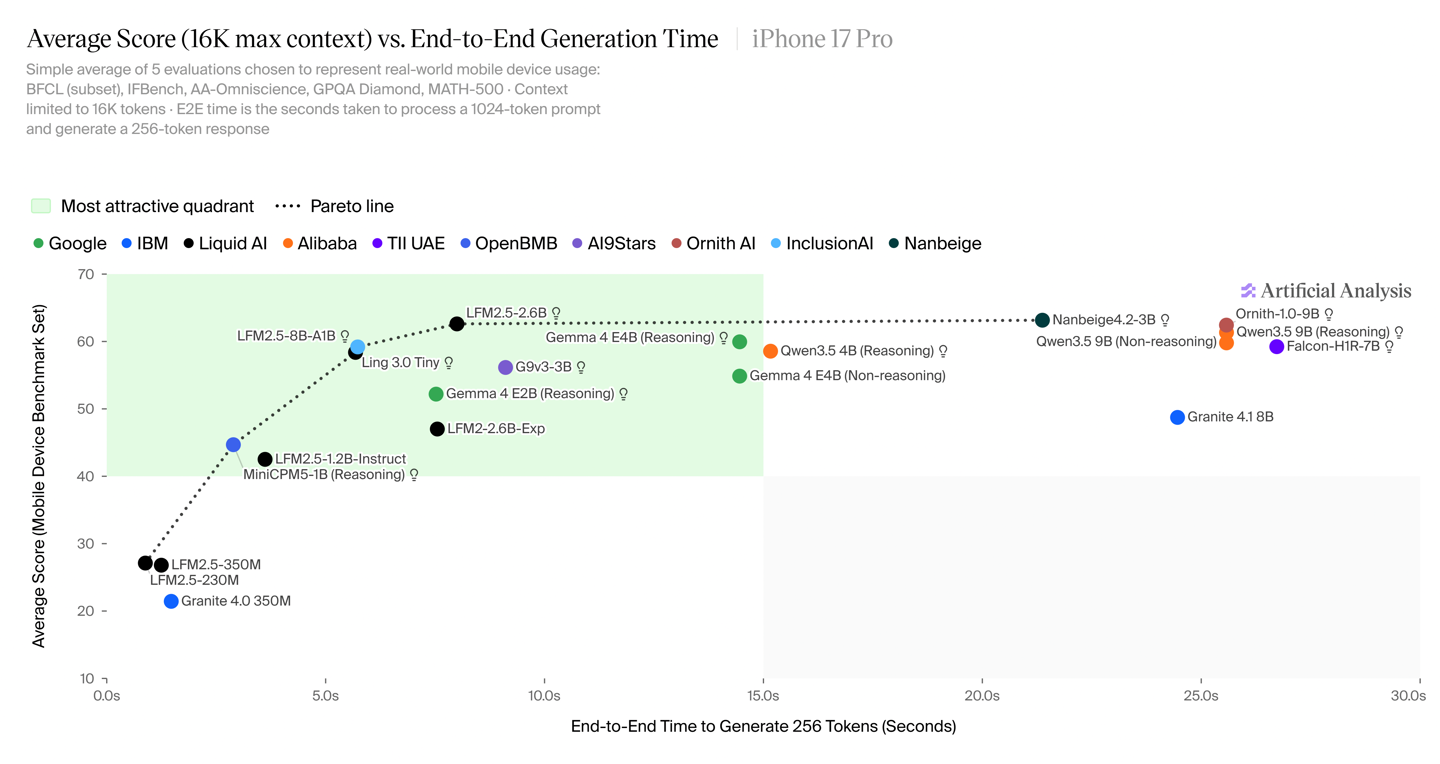
نشرت Artificial Analysis تدوينة نهار 24 غشت، أعلنت فيها على تعاونها مع Liquid AI لإطلاق معيار لقياس أداء الذكاء الاصطناعي فالهواتف، مع التركيز على أداء نماذج الذكاء الاصطناعي فـ Apple iPhone 17 Pro.
Artificial Analysis تكلفات بنظام اختبار مستوى الذكاء، بينما Liquid AI تكلفات بنظام اختبار أداء الاستدلال، واختارو بجوج 5 اختبارات معيارية:
BFCL (ترتيب Berkeley لاستدعاء الوظائف)
IFBench (اختبار اتباع التعليمات)
AA-Omniscience (اختبار متعلق بالمعرفة والإدراك)
GPQA Diamond (اختبار الأسئلة والأجوبة الصعيبة)
MATH-500 (اختبار المسائل الرياضية).
النماذج اللي تختابرو هي نماذج من بعد التكميم بـ 4 bit، والحجم ديالها ما كيتجاوزش 8GB، ومن بينها Gemma 4 E2B وLFM2-2.6B-Exp.
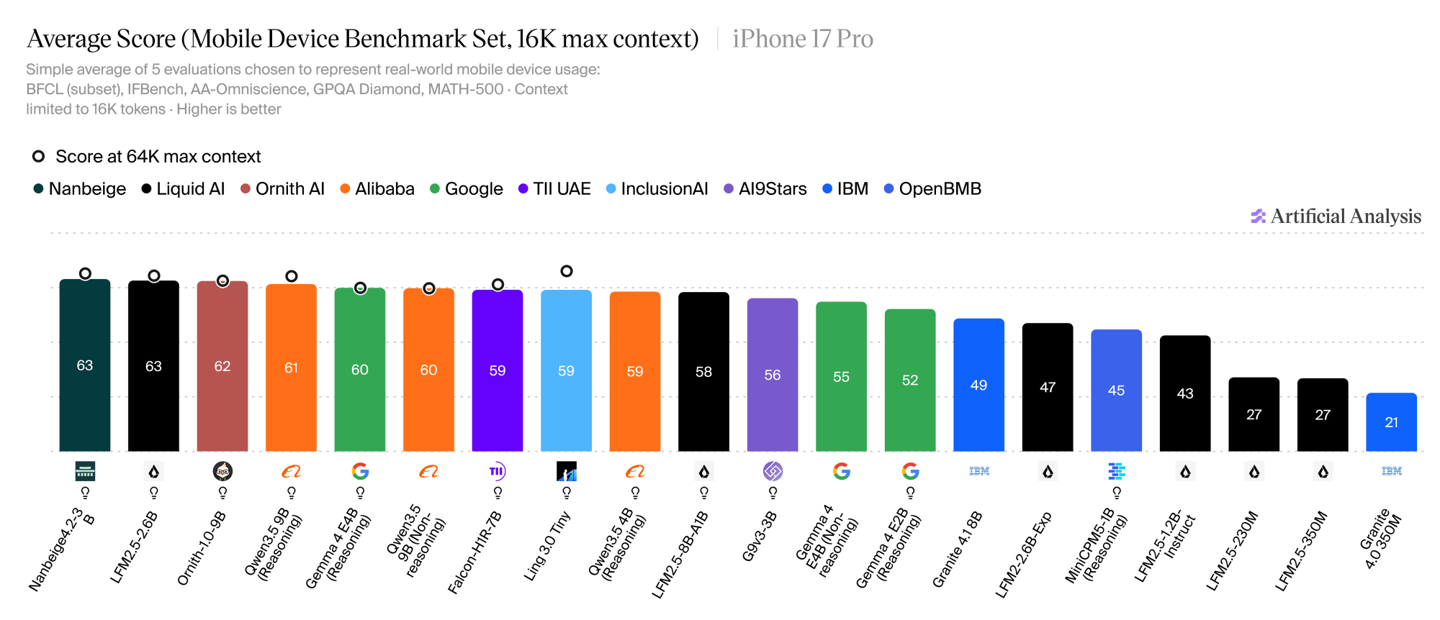
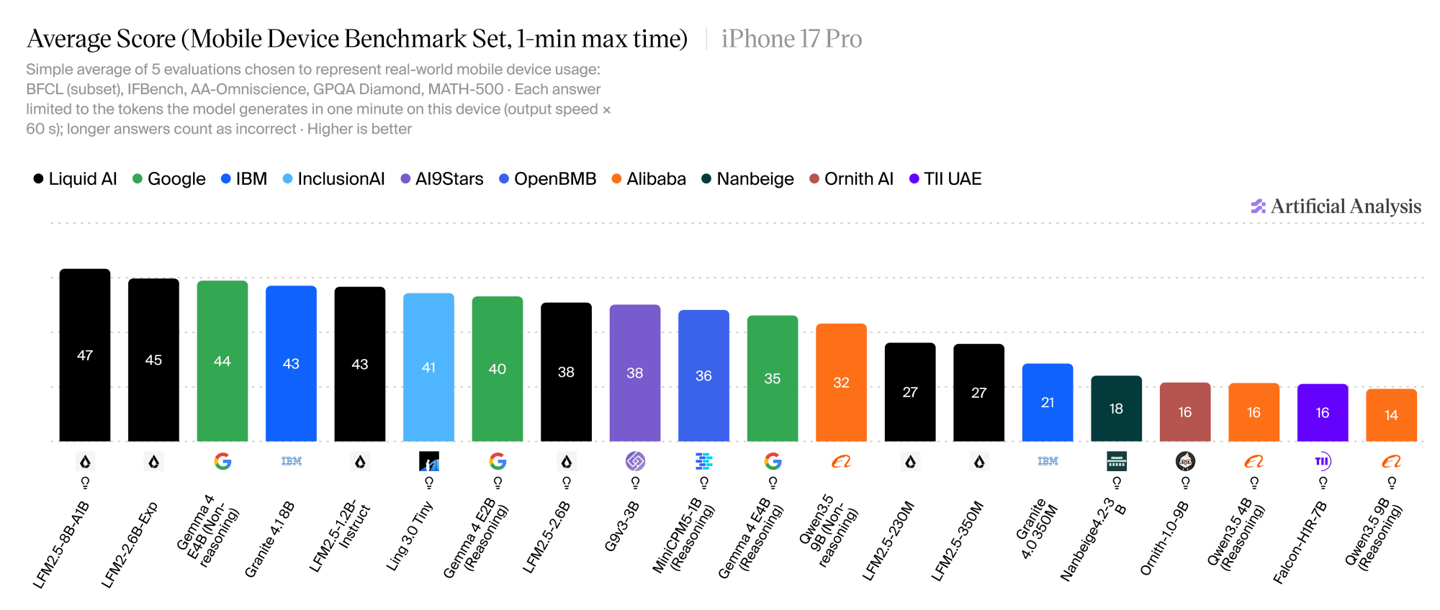
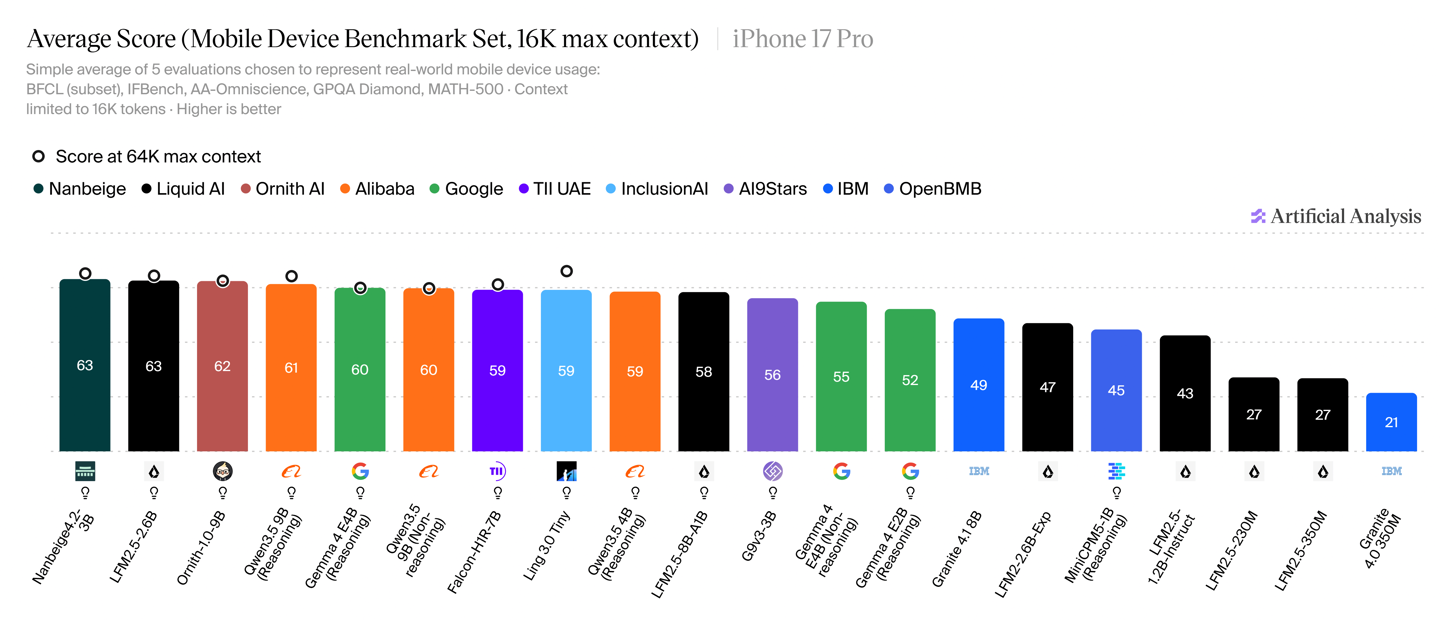
منين تحدد طول السياق فـ 16K tokens، جابو أعلى متوسط فالنقط ديال الاختبارات المعيارية Nanbeige4.2-3B وLFM2.5-2.6B. ومنين تحدد وقت الاستجابة فحد أقصى دقيقة وحدة، جا LFM2.5-8B-A1B فالرتبة الأولى، ومن بعدو LFM2-2.6B-Exp وGemma 4 E4B (Non-reasoning) وGranite 4.1 8B.
Nanbeige4.2-3B طوّراتو مختبرات Nanbeige التابعة لـ BOSS Zhipin، وكيحتوي غير على 3 مليارات ديال المعاملات غير المضمّنة (والمجموع تقريباً 4 مليارات)، وكيستعمل بنية Looped Transformer، بحيث كيعيد استعمال طبقات Transformer (جوج دورات) بلا ما يزيد فعدد المعاملات، وهادشي كيرفع العمق الفعلي ديال الحساب والسعة ديال النموذج.
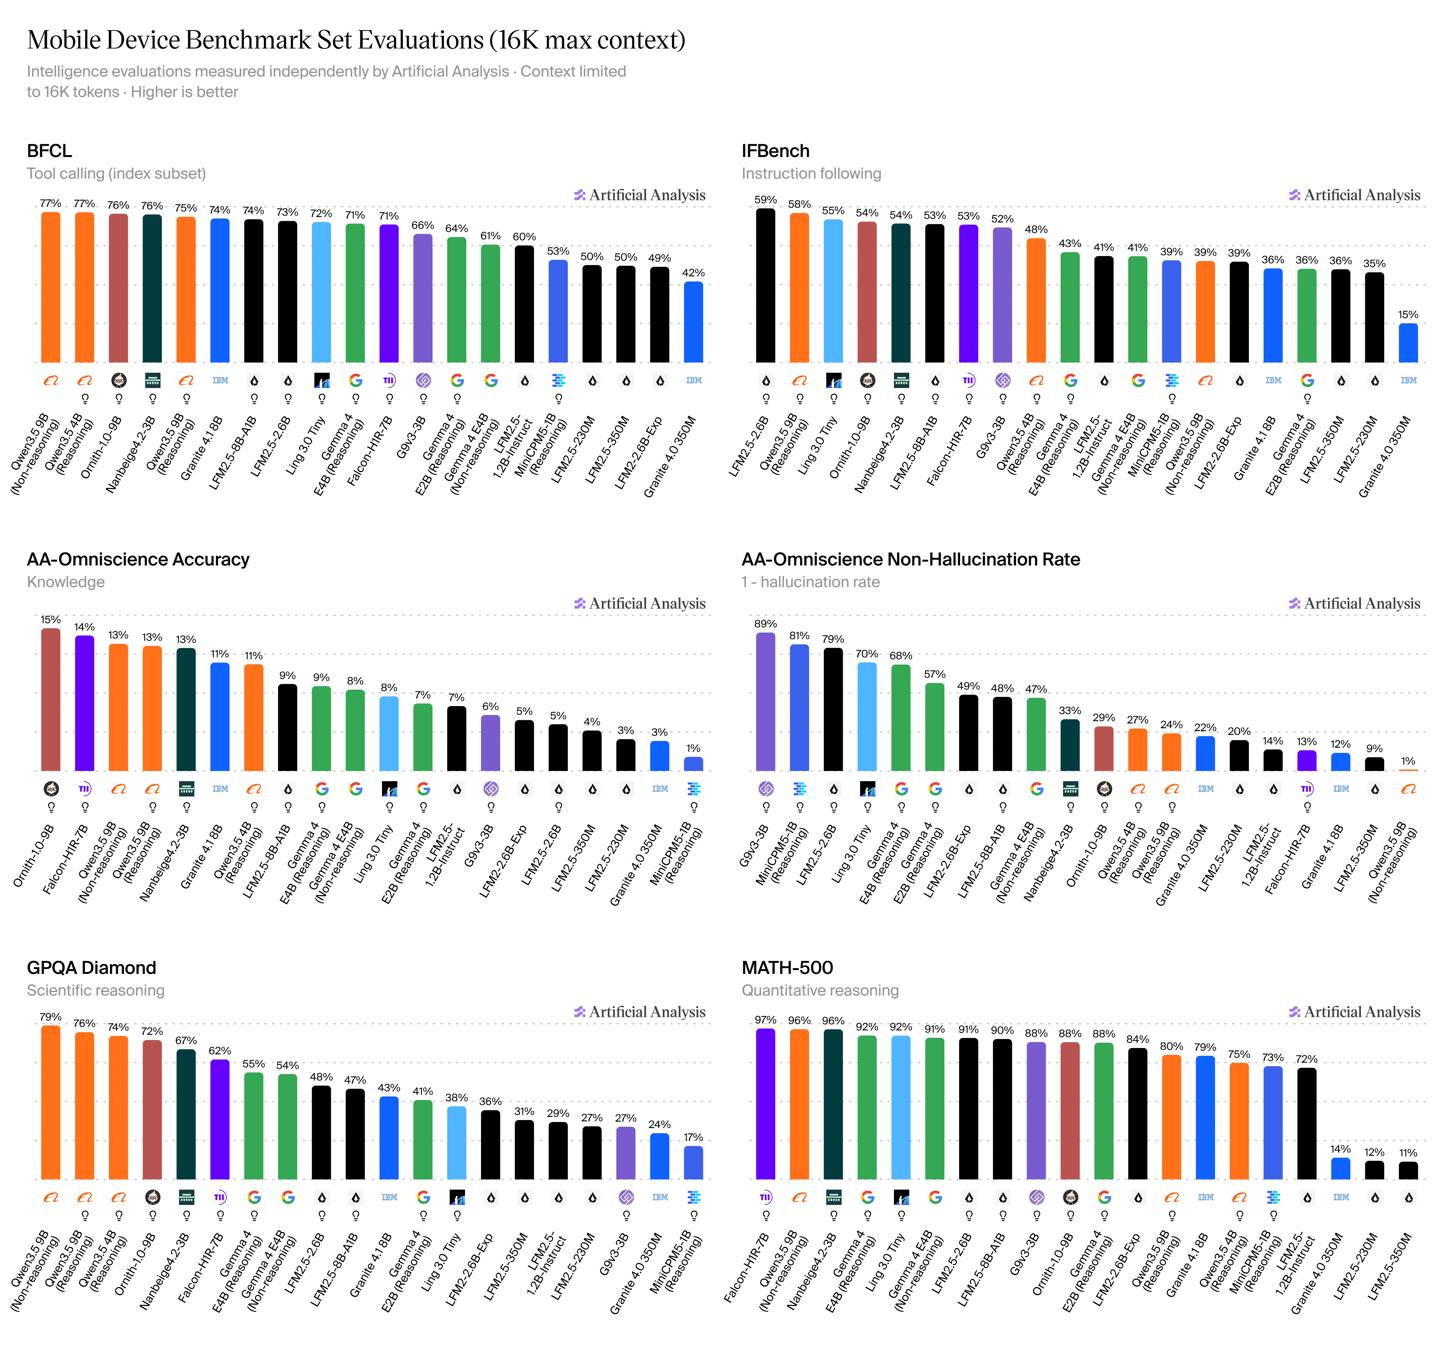
هادي هي لقطات الشاشة المرتابطة:
