
- الزيارات الشهرية
- 0
- الأسعار
- ما تحددش
- مدرج
- —
- تحدّث
- 2026-10-08
01شنو هو VoxMem؟
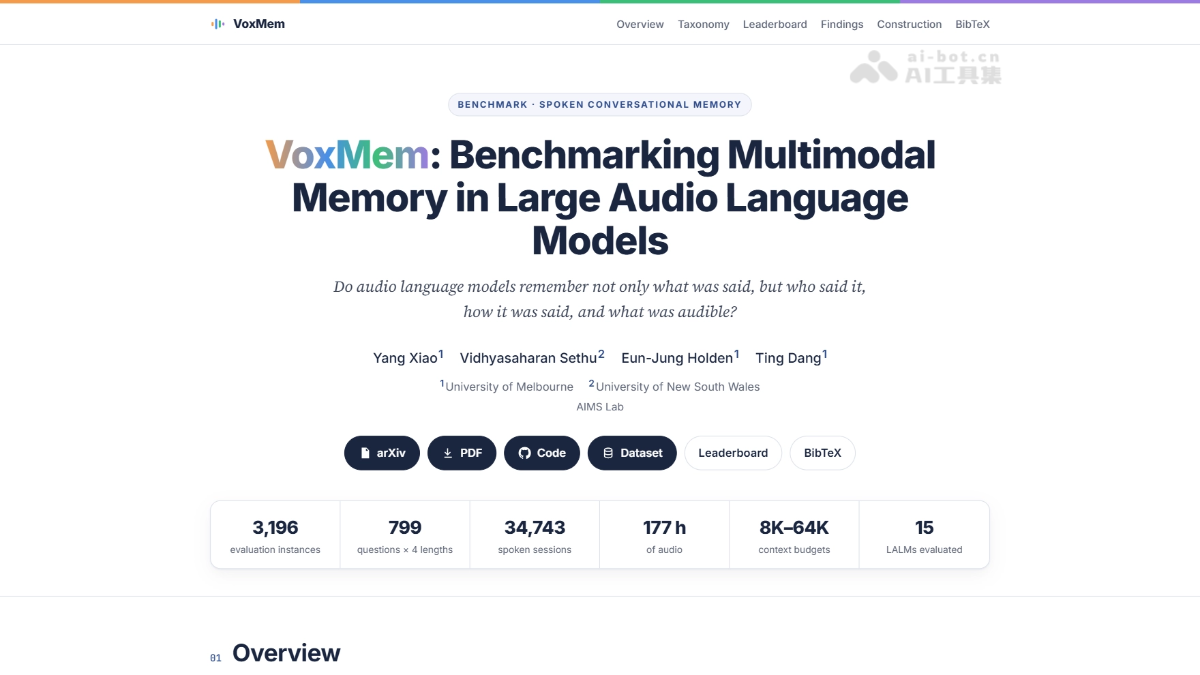
VoxMem هو معيار لقياس ذاكرة النماذج الصوتية الكبيرة، طوّراتو فرق من جامعة ملبورن وجامعة نيو ساوث ويلز. كيقدّم لأول مرة 4 أنواع ديال الأدلة الصوتية: المعنى، المتكلم، النبرة، وصوت البيئة × 4 عمليات ديال الذاكرة: الاستخراج، الاستدلال عبر الجلسات، التتبع الزمني، والامتناع عن الجواب، ضمن إطار تقييم ثنائي الأبعاد كيغطي تاريخاً متعدد الجلسات من 8K حتى 64K token. الاختبارات على 15 نموذج بيّنات أنه حتى فـ32K ما كاين حتى نموذج فاتت الدقة الإجمالية ديالو 40%. النماذج كتقدر تفتكر شنو تقال، ولكن كتصعاب عليها تفتكر شكون قالو وكيفاش تقال؛ وتمديد السياق الصوتي بوحدو ما كافيش باش يحقق تفاعل صوتي مستمر.
02الوظائف الرئيسية ديال VoxMem
تقييم ذاكرة الصوت عبر جلسات متعددة: كيختبر النظام، فإعدادات فيها تاريخ صوتي متعدد الجلسات وبمدد مختلفة، واش النماذج اللغوية الصوتية الكبيرة كتقدر تفتكر وترجع لمحتوى المحادثات السابقة.
تغطية أربعة أنواع ديال الأدلة الصوتية: كيدرس فآن واحد معنى الكلام، هوية المتكلم، الإشارات شبه اللغوية، وصوت البيئة؛ والأنواع الثلاثة الأخيرة هي معلومات “أصلية فالصوت” ما كيمكنش استرجاعها من التفريغ النصي.
تصنيف أربعة عمليات ديال الذاكرة: كيشمل استخراج المعلومات، الاستدلال عبر جلسات متعددة، تتبع تطور الحالة مع الوقت، والامتناع عن الجواب ملي كتكون الأدلة ناقصة؛ والتقاطع بيناتهم كيعطي 15 خلية تقييم فعّالة.
التحكم فطول التاريخ: نفس السؤال كيبقى بنفس الأدلة فـ4 أطوال للتاريخ: 8K/16K/32K/64K token، وكيتم غير زيادة جلسات مشتتة، باش يتعزل تأثير الطول على الذاكرة.
منظومة تقييم مفتوحة: الكود والبيانات كاملين مفتوحين المصدر، مع سكريبتات موحّدة للتشغيل والتنقيط وLeaderboard، وكتدعم ربط نماذج API والنماذج المحلية وإعادة التجارب.
03المبدأ التقني ديال VoxMem
تابعونا فـ微信 وردّو بكلمة “开源” باش تنضمو لمجموعة مشاريع الذكاء الاصطناعي مفتوحة المصدر
إطار تصنيف ثنائي الأبعاد: التصميم الأساسي ديال VoxMem هو جدول تصنيف ثنائي كيربط بين الأدلة الصوتية وعمليات الذاكرة. الأدلة الصوتية كتجاوب على شنو خاصو يتفتكر، وكتقسم المعلومات الصوتية لأربعة أنواع: المعنى، المتكلم، شبه اللغة، وصوت البيئة؛ وعمليات الذاكرة كتجاوب على كيفاش تستعمل هاد المعلومات، وكتشمل استرجاع المعلومات من جلسة وحدة (IE)، ودمج الأدلة عبر جلسات متعددة (MSR)، وتتبع تطور الحالة حسب الترتيب الزمني (TET)، والامتناع عن الجواب ملي ما كافياش الأدلة (AR). تركيبة المعنى×IE تحيدات عمداً حيث كتولي مجرد استرجاع نصي، وكتشكّل الخلايا الـ15 الباقية فضاء تقييم كامل، باش تتقاس قدرة الذاكرة الصوتية بطريقة منهجية وماشي متفرقة.
بناء البيانات على ثلاثة مراحل: توليد البيانات كيدوز من خط أنابيب “التخطيط—كتابة الحوار—تركيب الصوت”: فاللول كيتولد مخطط منظم لكل سؤال، كيحدد السؤال والجواب وتوزيع الأدلة وقيود الصلاحية؛ من بعد كيتكتبو نصوص الحوار ديال المستخدم والمساعد كل واحد بوحدو، بلا ما يذكرو المتكلم أو النبرة أو صوت الخلفية، باش ما يتسرّبش الجواب من النص؛ وفالأخير كيتصاوب الصوت باستعمال TTS، مع تثبيت نفس الصوت لكل مستخدم، وإدخال إشارات النبرة بالتحكم فالأسلوب، وخلط صوت البيئة بنسبة إشارة إلى ضجيج 10dB، مع الاحتفاظ بنسخة مقابلة منزوعة الإشارات لكل دور فيه دليل، من أجل مراقبة الجودة.
الجلسات المشتتة والتحكم فالحجم: كل تاريخ كيتكوّن من جلسات الأدلة، والجلسات المشتتة، وجلسات الملء. الجلسات المشتتة كتكون قريبة فالموضوع من موضوع الدليل ولكن بقيم مختلفة، ومعاها تصنيف نصي كيشوف النص فقط وكيحقق دقة بين 51–56%، باش يتأكد أن النموذج ما يقدرش يلقى الجواب غير بمطابقة الموضوع الظاهري. وبالنسبة للتحكم فالحجم، فالأطوال الأربعة ديال التاريخ متداخلة بشكل صارم، وكيتم تطويل التاريخ غير بجلسات ملء ما عندهاش علاقة، باش يبقاو السؤال والجواب والأدلة نفسهم فالمستويات الأربعة؛ وبالتالي أي تغير فالدقة كيرجع غير لطول التاريخ، بلا خلط مع صعوبة السؤال.
04كيفاش تستعمل VoxMem
نسخ المستودع: جرّ الكود من GitHub بالأمر git clone https://github.com/swagshaw/voxmem ودخل لمجلد المشروع.
تثبيت الاعتماديات: شغّل pip install -r requirements.txt، ويمكن اختيارياً تثبيت pip install "datasets" باش يتحوّل الصوت تلقائياً لمصفوفات.
إعداد مفاتيح API: إلا كنت غادي تقيّم نموذج API، ثبّت SDK المناسب وعيّن المفتاح، مثلاً pip install openai ومن بعد export OPENAI_API_KEY=.
تشغيل اختبار سريع: بدا بـ python run_voxmembench.py --config 8k_speaker_information --model abstain --allow-abstention --limit 25 --out predictions_smoke.jsonl للتحقق من المسار، ومن بعد استعمل score_voxmembench.py --judge exact-match للتنقيط، وتأكد أن طبقة الامتناع كتجيب 1.0 فأسئلة الامتناع و0.0 فالأسئلة اللي قابلة للجواب.
التقييم الرسمي: اختار الإعداد، بحال المجموعة الكاملة ديال 32k أو المجموعة الفرعية 32k_speaker_information، والنموذج المستهدف، وشغّل مثلاً python run_voxmembench.py --config 32k --model openai:gpt-4o-audio-preview --allow-abstention --out predictions_32k.jsonl؛ النماذج المحلية خاصها --adapter لتحديد دالة التكييف المخصصة و--model-dir للإشارة لمجلد الأوزان.
التنقيط بحَكَم LLM: شغّل python score_voxmembench.py --predictions predictions_32k.jsonl --judge openai:gpt-4o-mini --out metrics_32k.json، والحَكَم كيشوف غير السؤال والجواب المعياري والإجابة، وكيحدد واش الإجابات المفتوحة متكافئة.
05المزايا الأساسية ديال VoxMem
أول تغطية منهجية لذاكرة أصلها صوتي: كيتجاوز محدودية المعايير الحالية اللي كتركز غير على محتوى الكلمات، وكيُدخل لأول مرة معلومات صوتية غير نصية بحال شكون قال، وكيفاش قال، وشنو تسمع، ضمن إطار تقييم موحّد.
تصميم التصنيف الثنائي دقيق: كيستعمل 15 خلية فعّالة ناتجة عن 4 أنواع ديال الأدلة الصوتية×4 عمليات ديال الذاكرة، عوض اختيار أسئلة متفرقة، باش تتفكك قدرة الذاكرة الصوتية وتتقاس بشكل شامل ومستقل.
إعداد الجلسات المتعددة قريب من الواقع: كيحاكي جلسات متكررة عبر الوقت فالتفاعل الصوتي بين الإنسان والآلة، وماشي مونولوغ طويل واحد، وكيختبر الذاكرة الطويلة للنموذج مع تكرار المتكلمين وتحديث الحالات.
عزل تأثير الطول بشكل كامل: نفس السؤال كيبقى بنفس الأدلة وبشكل متداخل بصرامة فالأطوال الأربعة من 8K حتى 64K، وكيتم فصل تأثير “طول التاريخ” لأول مرة عن صعوبة السؤال ونوع الدليل بطريقة واضحة.
بناء مضاد للتسريب ومراقبة مزدوجة للجودة: الطرفان فالحوار ما كيشيروش للإشارات الصوتية، وكاينة مقارنة بين النسخ المتقابلة، ومراقبة على جوج مستويات كتحيد الأسئلة اللي يمكن الجواب عليها غير بالاعتماد على التفريغ النصي، باش يتأكد أن السؤال كيحتاج “الاستماع” وماشي “القراءة”.
تصميم المشتتات كيصعّب التحايل: جلسات مشتتة قريبة فالموضوع ولكن مختلفة فالقيم، مع تحقق بواسطة مصنف نصي دقته غير 51–56%، كيسد الطريق على إيجاد الجواب بمطابقة الكلمات المفتاحية.
06عنوان مشروع VoxMem
الموقع الرسمي للمشروع: https://swagshaw.github.io/voxmem/
مستودع GitHub: https://github.com/swagshaw/voxmem
مستودع نماذج HuggingFace: https://huggingface.co/datasets/AudioMemory/voxmembench
البحث التقني فـarXiv: https://arxiv.org/pdf/2609.32607
07مجالات استعمال VoxMem
اختيار الذاكرة طويلة المدى للمساعدات الصوتية ومكبرات الصوت الذكية: يقدرو المصنعين يستعملو VoxMem باش يختبرو بشكل موحّد واش النماذج المرشحة كتقدر تفتكر تفضيلات المستخدم، وأصوات أفراد العائلة، والوعود السابقة عبر الجلسات، وتفادى أنها “تنسى دابا شنو تقال ليها السيمانة اللي فاتت”.
تقييم التفاعل الصوتي داخل السيارات والأجهزة القابلة للارتداء: صوت البيئة داخل السيارة كيكون مشوش، ونبرة المستخدم كتتبدل، وبُعد صوت البيئة والإشارات شبه اللغوية فـVoxMem كيقدر يختبر موثوقية الذاكرة فمشاهد الضجيج الواقعية.
مراقبة الجودة فأنظمة خدمة الزبناء والاجتماعات متعددة المتكلمين: فمراكز الاتصال وتلخيص الاجتماعات، خاص النظام يربط “شنو تقال وشكون قالو” بشكل صحيح، وخاصية ربط المتكلم فـVoxMem واكتشاف نسبة الكلام للشخص الخطأ تقدر تستعمل مباشرة لتشخيص مشكل “خلط الأشخاص”.
التحقق من الذاكرة العاطفية فالروبوتات المرافقة ومنتجات رعاية كبار السن: الحاجة اللي قالها المسن وهو كيتنهّد السيمانة اللي فاتت، والتعب اللي باين فالنبرة ديالو، ما كيقدروش يحملوهم غير الإشارات شبه اللغوية؛ وبُعد التتبع الزمني فـVoxMem كيختبر واش المنتج يقدر يلاحظ تبدل الحالة مع مرور الوقت.
© إخلاء المسؤولية: النطاقات والمحتوى المرتبط يقدرو يتبدلو مع الوقت. AIEZZ ما كيتحكمش فالمواقع التابعة لجهات أخرى. راجع المحتوى الخارجي والمخاطر بشكل مستقل.
تقييمات المستخدمين0