
- الزيارات الشهرية
- 0
- الأسعار
- ما تحددش
- مدرج
- —
- تحدّث
- 2026-10-09
01شنو هو Mellum2.1؟
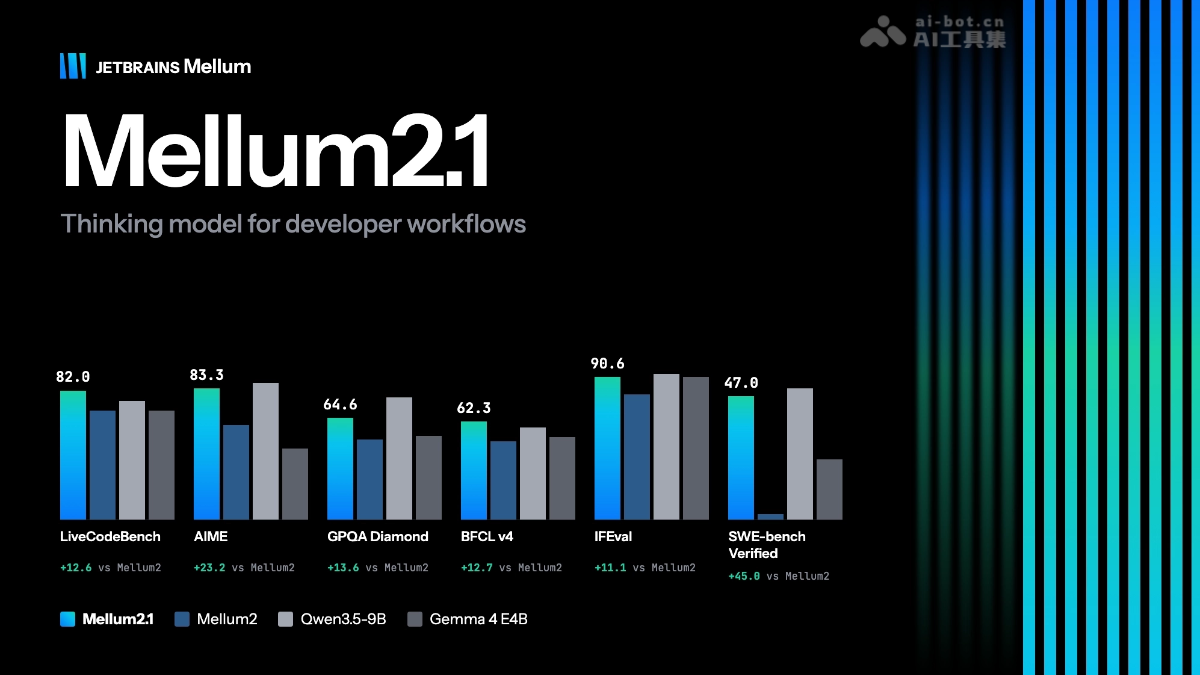
Mellum2.1 هو موديل مفتوح المصدر للبرمجة بالذكاء الاصطناعي من تطوير JetBrains، مبني على بنية 12B بمزيج الخبراء. ولى التعلم بالتعزيز فـ Mellum2.1 هو المكوّن الرئيسي فالتدريب بدل ما يكون غير مرحلة ختامية، ومع ملايين التجارب فبيئات معزولة، كيقدر الموديل يستكشف مستودعات الكود، يحرر الملفات، ويدقق التعديلات ديالو، الشي اللي كيرفع بزاف من قدرات البرمجة بالوكيل. فالأحمال العالية، كيقرب معدل المعالجة ديال Mellum2.1 لجوج مرات معدل Qwen3.5-9B، وكيدعم النشر الخاص، وهو متوفر دابا فـ Hugging Face.
02الوظائف الرئيسية ديال Mellum2.1
البرمجة بالوكيل: استكشاف مستودعات الكود، تحرير الملفات، والتدقيق فالتعديلات، مع القدرة على تحديد السبب الجذري للاختبارات الفاشلة، وصياغة حلول الإصلاح والتحقق منها.
إكمال وتوليد الكود: كيواصل توجه Mellum2، وكيقدم توليد سريع للكود وقدرات ديال السؤال والجواب ضمن سير عمل البرمجة.
استدعاء الأدوات: كيقدر ينسق مع أدوات خارجية باش يكمل المهام، وكيصلح لبناء أنظمة الوكلاء الذكية.
الاستدلال العام: كيقدر يعالج الأسئلة اليومية، وكيستنتج خطوة بخطوة حلول المسائل الرياضية والمنطقية الصعيبة.
النشر الخاص: كيدعم التشغيل محلياً أو فوق البنية التحتية الخاصة، مع بقاء الكود والبيانات كاملين داخل المؤسسة.
03المبدأ التقني ديال Mellum2.1
تابعنا فـ WeChat وردّ بـ “开源” باش تنضم لمجموعة مشاريع الذكاء الاصطناعي مفتوحة المصدر
بنية مزيج الخبراء (MoE): كيستعمل Mellum2.1 بنية بمزيج الخبراء فيها 12B من المعاملات، ولكن فكل عملية استدلال كيتفعّل غير 2.5B منها. كيتكوّن الموديل من عدة شبكات فرعية ديال “الخبراء”، والمدخلات كيتوزعو عبر آلية التوجيه غير على جزء من الخبراء باش يعالجوها. هاد الشي كيحافظ على سعة الموديل وكيهبط الحسابات بشكل كبير، وكيحقق استدلال بتكلفة قليلة ومعدل معالجة مرتفع.
التعلم بالتعزيز واسع النطاق (RL): الترقية الأساسية فهاد الإصدار كاينة فمسار التدريب؛ بحيث توسع RL من مرحلة ختامية قصيرة من بعد التدريب القبلي وولى هو المكوّن الرئيسي فالتدريب. زاد الفريق مهام فمجالات الرياضيات، البرمجة التنافسية، العلوم، استعمال الأدوات، وهندسة البرمجيات. وخلال التدريب، شغلات البنية التحتية الخاصة ملايين البيئات المعزولة، وغطات آلاف البيئات الحقيقية، باش يتعلم الموديل، من خلال التفاعل مع سيناريوهات البرمجة الواقعية والتجربة والخطأ وإشارات المكافأة، مهارات الاستكشاف والتحرير والتحقق اللازمة للوكيل الذكي.
انتقاء صارم للبيانات: جميع مجموعات البيانات المفتوحة المستعملة فالتدريب كتدوز من التصفية قبل الإدماج، وكيتم حذف المهام اللي فيها عيوب فالاختبارات، أو أجوبتها ما قابلاش للتحقق، أو مستوى الصعوبة ديالها غير مناسب. هاد الشي كيضمن موثوقية إشارات تدريب RL وكيمنع الموديل يتعلم من ملاحظات خاطئة.
التنبؤ بعدة Tokens (MTP): كيخلي MTP الموديل يتنبأ بعدة Tokens لاحقة فانتشار أمامي واحد. فحالة الطلب الواحد، كتطلع السرعة بحوالي 1.6 مرة. ومع تصميم MoE اللي فيه عدد قليل من المعاملات المفعّلة، كيولي معدل معالجة Mellum2.1 فالأحمال العالية قريب لجوج مرات معدل Qwen3.5-9B.
04كيفاش تستعمل Mellum2.1
دخل لصفحة الموديل: حل صفحة المنظمة الرسمية ديال JetBrains فـ Hugging Face، وقلب على مستودع موديل Mellum2.1.
نزّل أوزان الموديل: من صفحة بطاقة الموديل، كليك على التنزيل أو جيب ملفات الموديل حسب شروط الترخيص (إلا كان كاين شرط، خاصك توافق الأول على اتفاقية الاستعمال).
اختار إطار النشر: استعمل Transformers أو vLLM للنشر؛ الأول مناسب للتحقق البسيط، والثاني مناسب للخدمات الإنتاجية ذات التزامن العالي.
وجد بيئة الاستدلال: حضّر بيئة GPU (المعيار الرسمي مبني على H200 وحدة)، وحمّل الموديل وضبط سياق بـ 131K من المعاملات.
فعّل خيارات التسريع: تبع التوجيهات الرسمية وضبط التنبؤ بعدة Tokens (MTP) باش تزيد سرعة الطلب الواحد بحوالي 1.6 مرة.
بدا استدعاء الاستدلال: صيفط عبر API مطالب توليد الكود، أو تحرير على مستوى المستودع، أو مهام الوكيل، وخذ مخرجات الموديل.
05المزايا الأساسية ديال Mellum2.1
قدرات قوية فالبرمجة بالوكيل: من بعد تدريب RL واسع فبيئات حقيقية، كيقدر يستكشف مستودعات الكود بوحدو، ويحرر الملفات ويتحقق من التعديلات، ويحدد السبب الجذري لفشل الاختبارات ويصيغ حلول الإصلاح.
سرعة استدلال رائدة: فالأحمال العالية، كيقرب معدل المعالجة لجوج مرات معدل Qwen3.5-9B، وكيعتبر من الأسرع بين الموديلات من نفس الفئة.
استجابة سريعة فالطلب الواحد: تقنية التنبؤ بعدة Tokens (MTP) كتزيد سرعة الطلب الواحد بحوالي 1.6 مرة.
بنية فعالة: تصميم 12B بـ MoE كيفعّل غير 2.5B من المعاملات، وكيحقق أداءً عالياً بتكلفة حسابية منخفضة.
جودة عالية لبيانات التدريب: جميع بيانات التدريب كتدوز من انتقاء صارم، وكيتم حذف المهام المعيبة باش تبقى إشارات التعلم موثوقة.
قدرات شاملة: تحسن شامل فالبرمجة، والبرمجة التنافسية، والرياضيات، واستدعاء الأدوات، والمعرفة العامة.
مناسب للنشر الخاص: كيدعم التشغيل محلياً أو فوق البنية التحتية الخاصة، مع تحكم كامل ومستقل فالكود والبيانات، وكيصلح للسيناريوهات الحساسة فالمؤسسات.
06رابط مشروع Mellum2.1
الموقع الرسمي للمشروع: https://blog.jetbrains.com/ai/2026/10/mellum2-1-gets-to-work-a-fast-open-model-for-coding-agents/
مستودع الموديل فـ HuggingFace: https://huggingface.co/JetBrains/Mellum2.1-12B-A2.5B-Thinking
07سيناريوهات استعمال Mellum2.1
البرمجة بالوكيل: استكشاف مستودعات الكود بشكل مستقل، وتحرير الملفات والتحقق من التعديلات، وإنجاز المسار كامل من تحديد الاختبار الفاشل حتى الإصلاح.
مساعد خاص بالمؤسسات: النشر محلياً فوق خوادم المؤسسة باش يضمن بقاء الكود والبيانات داخل الشبكة الداخلية.
تكامل عميق مع IDE: الدمج مع IDEs ديال JetBrains أو الأدوات الخارجية لتوفير إكمال الكود والسؤال والجواب الذكي.
تنسيق الوكلاء الفرعيين: بفضل الكمون المنخفض ومعدل المعالجة المرتفع، كيقدر ينفذ مهام فرعية أو يوجّه الطلبات داخل أنظمة متعددة الوكلاء.
الاستدلال الرياضي والمنطقي: معالجة مسائل الرياضيات، والبرمجة التنافسية، والأسئلة اليومية، مع الحفاظ على قدرات المساعد العام.
© إخلاء المسؤولية: النطاقات والمحتوى المرتبط يقدرو يتبدلو مع الوقت. AIEZZ ما كيتحكمش فالمواقع التابعة لجهات أخرى. راجع المحتوى الخارجي والمخاطر بشكل مستقل.
تقييمات المستخدمين0