
- الزيارات الشهرية
- 0
- الأسعار
- ما تحددش
- مدرج
- —
- تحدّث
- 2026-10-09
01شنو هو Naive-N0.5-Flash؟
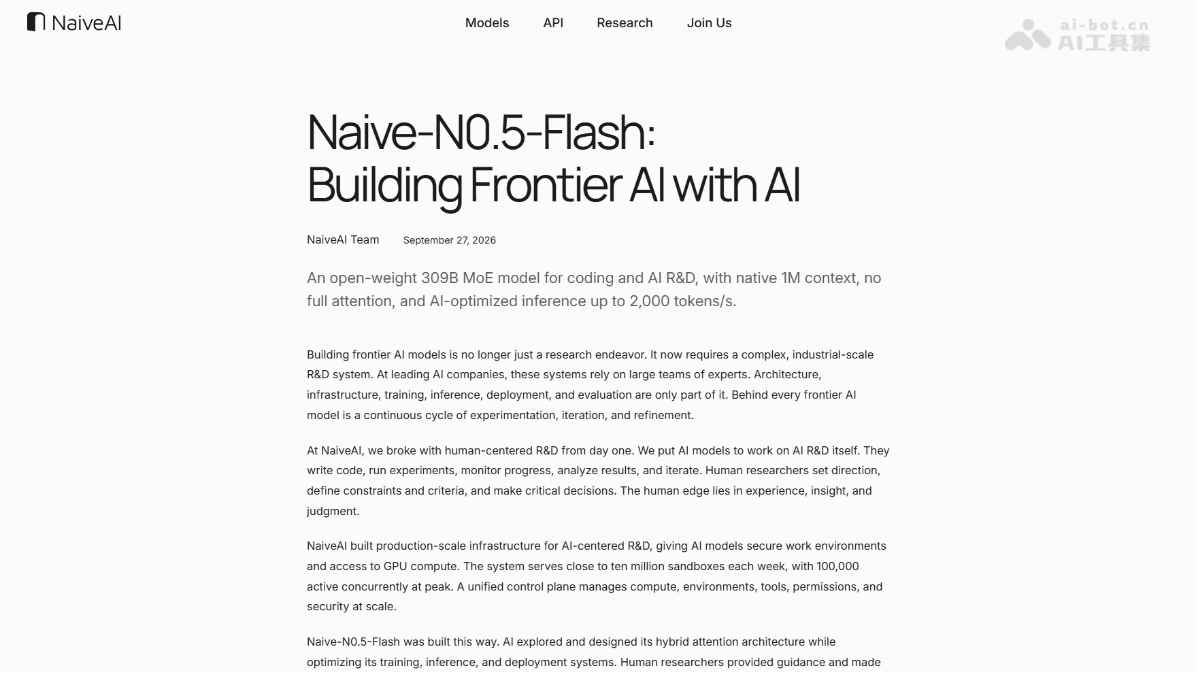
Naive-N0.5-Flash هو أول موديل كبير MoE مفتوح المصدر من NaiveAI، وموجّه للبرمجة وتطوير الذكاء الاصطناعي. Naive-N0.5-Flash مبني على البنية الأساسية Xiaomi MiMo-V2.5 بعد تعديلها، بهندسة 309B MoE، وكيستعمل انتباهًا متناثرًا هجينًا SWA+DSA، وكيدعم أصليًا سياقًا بحجم 1M بلا حتى طبقة انتباه شامل. الموديل تطوّر بمشاركة معمّقة من الذكاء الاصطناعي، ونظام الاستدلال المرافق NaiveRT كيوصل ففك الترميز أحادي التدفق لذروة 2122 tokens/s.
02الوظائف الرئيسية ديال Naive-N0.5-Flash
البرمجة بسياق طويل: كيدعم أصليًا سياقًا بحجم 1M token، وكيقدر يعالج مستودعات كود طويلة بزاف ومهام هندسة البرمجيات الممتدة.
المساعدة فالبحث والتطوير ديال الذكاء الاصطناعي: كيقدر يقرا الأوراق العلمية، يعاود يطبّق الطرق، يدير التجارب ويحلل النتائج، ويشارك مباشرة فالمسار الكامل لتطوير الموديل.
تسريع الاستدلال: مع نظام الاستدلال NaiveRT، كتوصل السرعة فالوضع العادي لـ 50 tokens/s، وكتبلغ ذروة فك الترميز أحادي التدفق 2,122 tokens/s فالوضع السريع.
البحث الذاتي: من بعد تحديد الهدف، ميزانية الحوسبة وبروتوكول التقييم، كيقدر يدفع البحث بشكل ذاتي من البداية للنهاية.
03المبدأ التقني ديال Naive-N0.5-Flash
تابعونا فـ WeChat وردّو بـ“开源” باش تنضمو لمجموعة التواصل ديال مشاريع الذكاء الاصطناعي مفتوحة المصدر
الانتباه المتناثر الهجين SWA–DSA: الموديل مبني على البنية الأساسية MiMo-V2.5، وكيبدّل طبقات الانتباه الشامل ذات الكلفة الكبيرة بانتباه DeepSeek المتناثر، وكيكدّس بالتناوب انتباه نافذة منزلقة وانتباه DSA بنسبة 5:1، بلا أي طبقة انتباه شامل فالشبكة كاملة. كيعالج SWA نافذة محلية فيها 128 token، بينما كيقيّم DSA كامل التاريخ بواسطة مفهرس خفيف وكيختار top-2048 token باش يحسبهم المسار الرئيسي.
تصميم المفهرس الخفيف: تبدّل MLA الأصلي ديال DSA بـ GQA، ونقص عدد رؤوس الاستعلام فالمفهرس من 64 لـ 16، وهاد الشي نقص الوقت ديال مسار اختيار الفهرس بـ 44%، مع الحفاظ على الأداء بلا تراجع فمهام Agent بسياق 1M.
مسار التدريب من ثلاث مراحل: فالأول كيتجمّد المسار الرئيسي فوق 50B token، وكيتم توفيق توزيع المفهرس مع توزيع الانتباه الشامل باستعمال خسارة KL؛ من بعد كيتحوّل الانتباه للانتباه المتناثر وكيستمر التدريب المسبق بـ 3T token، باش يتأقلم مع آلية اختيار المعلومات الجديدة ويتقوى فمجالي البرمجة والبحث والتطوير؛ وفالأخير كيدوز 200B token ديال الضبط الموجّه مع تخفيض معدل التعلم. كيبقى سياق 1M حاضر طول العملية، والذكاء الاصطناعي كيكمل أوتوماتيكيًا تحليل استرجاع top-k وإصلاحات الاستقرار العددي.
التوازي الهجين للسلاسل وتحسين الذاكرة: بسبب الفرق بين SWA اللي محتاج غير نافذة محلية وDSA اللي محتاج كامل التاريخ، كيتستعمل توازي Halo للسلاسل بشكل منفصل؛ ومن جهة الذاكرة، كتتصغّر حبيبات إلغاء تحميل التفعيلات حتى لمستوى العمليات، وكيتم الاحتفاظ صراحةً بفهارس top-k باش ما تعاودش الحسابات تغيّر الاختيار، وبـ 512 بطاقة يمكن تدريب 1T token فحوالي 4 أيام.
تحسينات استدلال NaiveRT: باستعمال دمج ضخم للعمليات، وPDL باش يتنفذو kernels ديال المسار الفوقاني والتحتاني بالتوازي، ودفع دورة فك الترميز التخميني كاملة فوق GPU، كينقص تأخير فك الترميز فالدورة الواحدة من 12.3ms لـ 3.4ms؛ وكيدعم حتى أخذ عينات حتميًا بتاتًا حسب البذرة العشوائية، باش يضمن تطابق العينات مع training logprob فتدريب RL. جميع التحسينات كتتقاس على أساس المسار الحقيقي الكامل ديال الموديل.
04كيفاش تستعمل Naive-N0.5-Flash
تأكد من العتاد: خاص GPU من NVIDIA كيدعم FP8، وأوزان الموديل كتحتاج حوالي 315GB، مع ضرورة تخصيص ذاكرة إضافية.
جيب الأوزان: حمّل مستودع NaiveAI/Naive-N0.5-Flash-FP8 من Hugging Face.
ثبّت الاعتماديات: نفّذ pip install "transformers[torch,kernels]>=5.17.0".
حمّل الموديل: استعمل AutoTokenizer وAutoModelForCausalLM مع trust_remote_code=True وdevice_map="auto".
بني المدخلات: مرّر رسائل الحوار عبر apply_chat_template وولّد tensors ديال الإدخال.
ولّد النتيجة: عيّط على model.generate() باش تولّد الجواب، ومن بعد استعمل tokenizer.decode() لفك ترميز الخرج.
ضبط المعاملات: للاستعمال العام كيتنصح بـ temperature=1.0 وtop_p=0.95.
عاود إنتاج الاستدلال عالي الأداء: إلا بغيتي سرعة 2,122 tokens/s، تقدر تجيب كود NaiveRT مفتوح المصدر، وبيئة Docker Compose والسكريبتات المرافقة للقياس وتنصّبهم بوحدك.
05المزايا الأساسية ديال Naive-N0.5-Flash
سياق طويل بزاف: كيدعم أصليًا سياق 1M token، وما كاينة حتى طبقة انتباه شامل فالشبكة كاملة، وهاد الشي كيخلي كلفة فك ترميز السلاسل الطويلة أقل بزاف من البنيات العادية.
سرعة استدلال رائدة: نظام NaiveRT المرافق كيوصل ففك الترميز أحادي التدفق لذروة 2,122 tokens/s، وتأخير فك الترميز التخميني أقل بـ 72.4% مقارنةً بـ SGLang.
قدرات قوية فالبحث والتطوير: PaperBench 63.2، وMLE-bench-30 بنسبة 73.7%، وNanoGPT SpeedRun فـ 73.8s، مع تفوق فعدة تقييمات للبحث والتطوير ديال الذكاء الاصطناعي على موديلات من نفس المستوى.
بحث وتطوير أصلي بالذكاء الاصطناعي: الذكاء الاصطناعي شارك فتصميم البنية وتحسين النظام، وهاد الشي كيجسّد عمليًا نموذج “الذكاء الاصطناعي كيبحث ويطوّر الذكاء الاصطناعي”، بحيث الإنسان كيحدد الأهداف والذكاء الاصطناعي كينفذ التكرارات.
إمكانات البحث الذاتي: من بعد تحديد الهدف والميزانية، كيقدر يكمل البحث كاملًا من البداية للنهاية بشكل ذاتي، ودرّب نموذج العالم AutoWM فـ 400 ساعة وطلع للصدارة فـ WorldArena.
06عنوان مشروع Naive-N0.5-Flash
الموقع الرسمي للمشروع: https://naive.ai/en/research/
مستودع GitHub: https://github.com/NaiveAI-Labs/Naive-N0.5-Flash
مستودع الموديل فـ HuggingFace: https://huggingface.co/NaiveAI/Naive-N0.5-Flash
07مجالات استعمال Naive-N0.5-Flash
مساعد البحث والتطوير ديال الذكاء الاصطناعي: كيساعد الباحثين يقراو الأوراق العلمية، يعاودو يطبقو الطرق، يديرو التجارب ويحللو النتائج، بحال مهام البحث والتطوير من نوع PaperBench وMLE-bench.
هندسة البرمجيات الممتدة: بفضل السياق الأصلي ديال 1M، كيقدر يعالج مستودعات كود كبيرة وينجز الفهم بين الملفات، إصلاح الأخطاء وتوليد الكود على مستوى المستودع.
مهام Agent بسياق طويل: كيحافظ على تاريخ المهمة كامل فسيناريوهات التفاعل الطويل، بحال العمليات فالطرفية والاستدعاءات المتعددة للأدوات.
بنية تحتية لتدريب RL: بالاستفادة من سرعة فك الترميز الأحادي العالية ديال NaiveRT وأخذ العينات الحتمي بتاتًا، كيسرّع rollout ديال التعلم المعزز طويل المدى وكيقلل من العينات اللي كتتأخر على الركب.
© إخلاء المسؤولية: النطاقات والمحتوى المرتبط يقدرو يتبدلو مع الوقت. AIEZZ ما كيتحكمش فالمواقع التابعة لجهات أخرى. راجع المحتوى الخارجي والمخاطر بشكل مستقل.
تقييمات المستخدمين0