
- الزيارات الشهرية
- 0
- الأسعار
- مجاني & مدفوع
- مدرج
- 2026-08-13
- تحدّث
- 2026-08-13
01شنو هو dots.tts؟
dots.tts هو موديل أساسي لتوليد الكلام مفتوح المصدر من طرف فريق dots ديال شياوهونغشو ومختبر X-LANCE ديال جامعة شنغهاي جياو تونغ، فيه 2 مليار بارامتر وكيعتمد بشكل كامل على التوليد التلقائي المستمر. الموديل كيولّد الصوت 48kHz مباشرة على دفعات فالفضاء الكامن المستمر، وحقق نتائج SOTA فالتشابه ديال الصوت ودقة المحتوى فاختبارات بحال Seed-TTS-Eval. كيدعم الاستنساخ بلا أمثلة، والإخراج المتدفق، والمحادثات الثنائية الاتجاه بزمن تأخير منخفض. المشروع محلول المصدر بالكامل، بالكود والأوزان، وزاد قدرة التعديل الصوتي الدقيق عبر dots.tts.edit.
02الوظائف الرئيسية ديال dots.tts
استنساخ الصوت بلا أمثلة: غير بـ 3–10 ثواني ديال الصوت المرجعي، يقدر يقلد نفس الصوت باش يقرا أي نص جديد، وكيَدعم الاستنساخ بين اللغات. وحقق أداء SOTA فدقة المحتوى وتشابه المتكلم فاختبار Seed-TTS-Eval.
تحويل النص لكلام: كيوفر توليد صوت بجودة عالية، من اختيار صوت عشوائي حتى لتوليد صوت متكلم محدد، اعتماداً على موديل تلقائي مستمر فيه 2B بارامتر وكيخرج صوت 48 kHz مباشرة.
التوليد المتدفق والتفاعل بزمن تأخير منخفض: كيدعم الإخراج المتدفق بشكل طبيعي؛ منين كيدخل بادئة النص، كيبدأ يولد الصوت على دفعات. فالنمط ثنائي التدفق 1T1A، كلما خرج LLM واحد Text Token، كيرد الجانب الصوتي مباشرة. زمن تأخير أول حزمة صوتية كيوصل حتى لـ 54.4 ميلي ثانية، وهادشي مناسب لوكلاء الصوت الفوريين والمحادثات الثنائية الاتجاه.
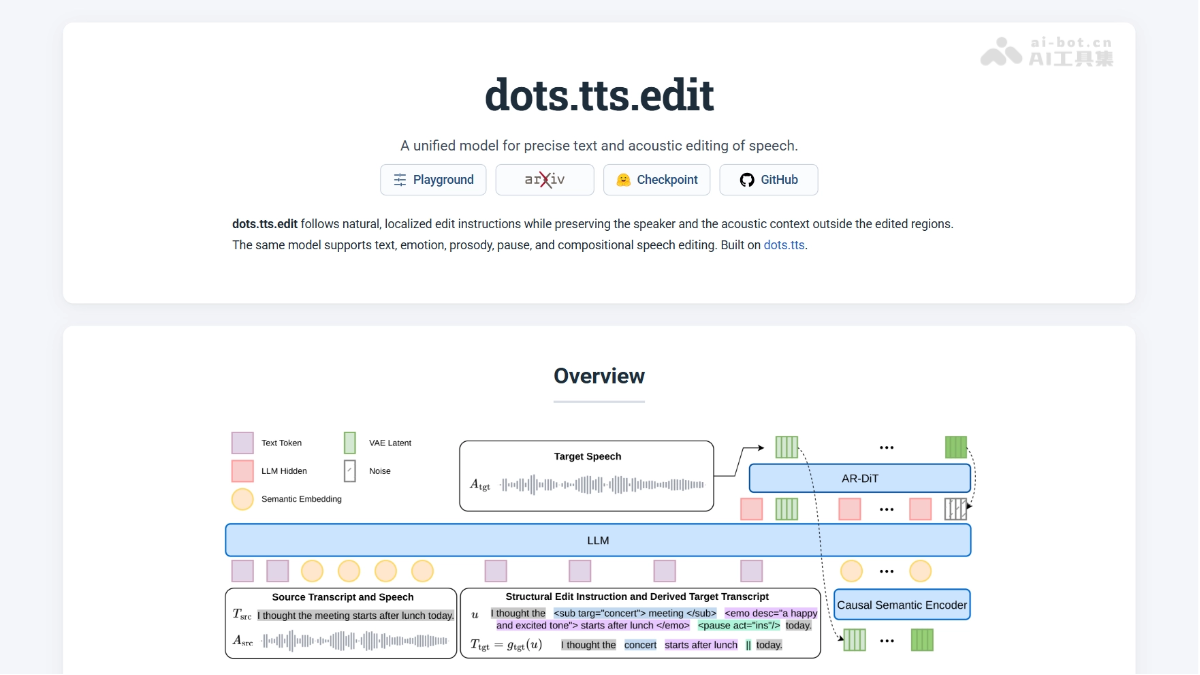
التعديل الصوتي الدقيق: كيدعم تبديل النص فالتسجيلات الموجودة، وتعديل العاطفة، وتغيير النبرة والسرعة، وإدخال أو حذف التوقفات. ويمكن جمع عمليات متعددة فتعليمة وحدة وتنفيذها مرة وحدة، مع الحفاظ على المناطق اللي ما تبدلاتش.
دعم لغات متعددة: كيغطي 24 لغة، وحقق متوسط تشابه المتكلم 83.9 فالتقييم متعدد اللغات ديال MiniMax، مع المرتبة الأولى فـ 19 لغة.
سرعات متعددة للاستدلال: كيوفر عدة checkpoints، منها Base وSOAR وMeanFlow (4 خطوات) وsCM بجوج خطوات وDMD بخطوة وحدة، باش يختار المستخدم التوازن المناسب بين جودة الصوت وسرعة الاستدلال.
03المبدأ التقني ديال dots.tts
تابع الحساب فـ WeChat وردّ بـ “开源” باش تنضم لمجموعة مشاريع الذكاء الاصطناعي مفتوحة المصدر
بنية تلقائية مستمرة بالكامل: dots.tts تخلى على الطريقة التقليدية اللي كتكمّي الصوت فـ Tokens متقطعة، وكيخدم مسار التوليد كامل فالفضاء الكامن المستمر. الموديل كيتوقع المقاطع الصوتية على دفعات بطريقة تلقائية، ومن بعد كيرجعها لموجة صوتية 48 kHz عبر Decoder على طريقة BigVGAN، وبهذا كيتفادى من الأصل عنق الزجاجة فالمعلومات وضياع تفاصيل الصوت الناتجين عن التكميم المتقطع.
تمثيل مستمر دلالي: كيستعمل الموديل AudioVAE مصمم على أساس HoliTok باش يضغط الموجة الصوتية الأصلية لمتغيرات كامنة مستمرة بمعدل 25 FPS. وكيوازن الـ Encoder، عبر التدريب الدلالي، بين دقة إعادة البناء وتنظيم الفضاء الكامن، حتى وصل تشابه المتكلم بعد إعادة البناء لـ 0.969، وخلّى مجال كبير للحفاظ على تفاصيل الصوت والخصائص الصوتية فالتوليد التلقائي اللاحق.
آلية التحكم فالأخطاء: حيث إن الانحرافات الصغيرة فالخطوات الأولى فالتوليد التلقائي المستمر كتقدر تتراكم وتنتاشر للور، دخل dots.tts Encoder دلالي سببي كيضغط الـ VAE patches المتولدة فالحين لذاكرة تاريخية دلالية مركزة، وكيعاود يدخلها لـ LLM. وبفصل التغييرات الصوتية المحلية عالية التباين والاحتفاظ غير بالملخص الدلالي طويل المدى، كيحد بشكل فعال من انتقال الأخطاء، والصوت الحاد، وانجراف الخصائص الصوتية فالتوليد ديال السلاسل الطويلة.
مسار التوليد: عملية التوليد كيديرها LLM كمحور رئيسي، مبني فالبداية على Qwen2.5-1.5B، وكيستهلك مباشرة Text Tokens ديال BPE وكيخرج الحالة المخفية فكل خطوة. من بعد، كينفذ رأس المطابقة التدفقية التلقائية (DiT فيه 18 طبقة) توليداً بإزالة الضوضاء للـ acoustic patch الموالي، اعتماداً على الحالة المخفية ديال LLM والبادئة التلقائية. وفنفس الوقت، كيوفر Encoder عالمي للمتكلم x-vector، جاي من CAM++ مجمد، ضمان ثبات الصوت.
تسريع ما بعد التدريب: الفريق كيستعمل المحاذاة بالتصحيح الذاتي SOAR باش يحاكي الموديل أثناء التدريب حالات الانحراف اللي كتوقع فالتنفيذ الحقيقي ويتعلم يصحح راسو، بلا حاجة لموديل مكافآت، وهادشي كيزيد الاستقرار. وبـ MeanFlow distillation كيضغط المسارات متعددة الخطوات ديال المدرّس فسرعة متوسطة، وكيحقق توليداً بجودة عالية فـ 4 خطوات. ومن خلال موديل الاتساق المبسط (sCM) كيضغطه لجوج خطوات. وباستعمال Reward-aware Distribution Matching Distillation (DMD) مع استراتيجية تحديث بجوج مقاييس زمنية، كيتم الحصول على موديل طبيعي وواضح بجودة عالية فخطوة وحدة.
04كيفاش تستعمل dots.tts
التثبيت: نفّذ pip install dots.tts باش تثبته، أو كلونِي الكود من GitHub ومن بعد ثبته محلياً للتطوير باستعمال pip install -e .. فالحالات اللي فيها تزامن عالي، تقدر تزيد تنشر SGLang Omni باش تستافد من تسريع CUDA Graph ودعم المعالجة على دفعات مستمرة.
التوليد من سطر الأوامر: استعمل مدخل dots.tts وحدد --model-name-or-path و--text و--prompt-audio و--prompt-text الهدف، باش تدير استنساخ للصوت بلا أمثلة. إلا حيدتي --prompt-text كيرجع لاستنساخ x-vector، وإلا حيدتي --prompt-audio كيدير اختيار صوت عشوائي.
التعديل من سطر الأوامر: استعمل مدخل dots.tts.edit، وقدم --source-audio وتعليمة --instruction بصيغة XML، باش تعدل التسجيلات الموجودة بدقة، بحال تبديل النص أو تعديل العاطفة والإيقاع.
الاستعمال الأساسي ديال Python API: من بعد تحميل الموديل عبر DotsTtsRuntime.from_pretrained()، عيط على generate() ومرر النص، ومعاه اختيارياً الصوت المرجعي، باش تحصل على Tensor ديال الصوت المولّد وتحفظه فملف.
الإخراج المتدفق عبر Python API: عيط على generate_stream() باش تحصل على Tensorات صوتية على دفعات، وترسلها مباشرة للمشغل أو WebSocket، وتحقق تجربة منخفضة التأخير: التوليد والتشغيل فآن واحد.
المحادثة ثنائية التدفق عبر Python API: استعمل DotsTtsRuntimeDoubleStreaming لبدء الجلسة، ومن بعد دفع النص Token بـ Token. الجانب الصوتي كيبدأ التوليد مباشرة، وزمن تأخير أول حزمة صوتية يقدر يوصل حتى لـ 54.4 ميلي ثانية، وهادشي مناسب لوكلاء الصوت الفوريين.
الضبط الدقيق: شغّل accelerate launch scripts/train_dots_tts.py وعيّن مسار البيانات ديالك، باش تدير تكييفاً دقيقاً للصوت أو المجال انطلاقاً من checkpoints مفتوحة.
تسريع التقطير: باستعمال scripts/train_dots_tts_meanflow.py، دير MeanFlow distillation انطلاقاً من checkpoint ديال SOAR كمدرّس، باش تحصل على موديل طالب بجودة عالية فـ 4 أو 2 أو 1 خطوة، حسب متطلبات التأخير والتزامن.
واجهة الويب: شغّل python apps/gradio/app.py باش تبدأ واجهة التوليد المرئية، أو شغّل apps/edit_playground/app.py باش تبدأ Edit Playground، وترفع الصوت من المتصفح، وتحدد مناطق التعديل، وتشوف النتيجة مباشرة.
05المزايا الأساسية ديال dots.tts
النمذجة فالفضاء الكامن المستمر بالكامل: تخلى على Acoustic Tokens المتقطعة، وكيولّد الصوت تلقائياً مباشرة فالفضاء الكامن المستمر، مع الحفاظ على تفاصيل صوتية غنية بحال ملمس الطيف والنفَس، وكيصل تشابه المتكلم بعد إعادة البناء لـ 0.969.
جودة توليد SOTA: حقق فاختبار Seed-TTS-Eval نتائج SOTA فدقة المحتوى وتشابه الصوت معاً. وفالتقييم متعدد اللغات ديال MiniMax، وصل متوسط SIM فـ 24 لغة لـ 83.9، متفوقاً فالأداء العام على الحلول الرئيسية.
تدفق أصلي بزمن تأخير منخفض: فالنمط ثنائي التدفق 1T1A، زمن تأخير أول حزمة صوتية كينخفض حتى لـ 54.4 ميلي ثانية. ومع SGLang Omni، وصل التزامن فبطاقة H100 وحدة لـ 16 مساراً وبمعدل 4.76 req/s، لتلبية متطلبات وكلاء الصوت الفوريين.
قدرة تعديل موحدة: dots.tts.edit مبني على نفس الموديل الأساسي، وكيدعم التعديل الدقيق للنص والعاطفة والإيقاع والتوقفات باستعمال تعليمات مهيكلة بصيغة XML، وحقق تقدماً عاماً على باقي الأنظمة مفتوحة المصدر فتقييم doteBench.
06عنوان مشروع dots.tts
مستودع GitHub: https://github.com/studio-dots-ai/dots.tts
البحث التقني فـ arXiv: https://arxiv.org/pdf/2608.02673
07مجالات استعمال dots.tts
وكيل صوتي فوري: فالنمط ثنائي التدفق 1T1A، زمن تأخير أول حزمة صوتية كينخفض حتى لـ 54.4 ميلي ثانية، وكيصلح للمحادثات الثنائية الاتجاه الفورية والمساعدات الصوتية اللي كيسوقها LLM.
استنساخ الصوت بلا أمثلة: غير بثواني قليلة من الصوت المرجعي، يقدر يقلد أي صوت، وكيَدعم الاستنساخ بين اللغات، وكيصلح للكتب المسموعة والدبلجة وصناعة المحتوى الشخصي.
توليد محتوى متعدد اللغات: كيغطي 24 لغة مع الحفاظ على تشابه عالي للمتكلم، وكيصلح للبث الصوتي متعدد اللغات والخدمات المحلية فالمنتجات العالمية.
التعديل الصوتي الدقيق: باستعمال dots.tts.edit يمكن تبديل النص فالتسجيلات الموجودة، وتعديل العاطفة والإيقاع والتوقفات، وهادشي مناسب للمونتاج اللاحق ديال البودكاست وتحسين المحتوى الصوتي.
البث المباشر والإخبار الفوري: مع الإخراج المتدفق ديال LLM، يمكن التوليد والتشغيل فآن واحد، وكيصلح للأخبار، والبث المباشر التجاري، وبث المعلومات فالحين.
© إخلاء المسؤولية: النطاقات والمحتوى المرتبط يقدرو يتبدلو مع الوقت. AIEZZ ما كيتحكمش فالمواقع التابعة لجهات أخرى. راجع المحتوى الخارجي والمخاطر بشكل مستقل.
تقييمات المستخدمين0