
- الزيارات الشهرية
- 0
- الأسعار
- مجاني & مدفوع
- مدرج
- 2026-08-07
- تحدّث
- 2026-08-07
01شنو هو SALMONN-2؟
SALMONN-2 هو موديل لغوي كبير عام ديال الصوت، تفتح المصدر ديالو بتعاون بين جامعة تسينغهوا، مختبر شانغهاي للذكاء الاصطناعي وجامعة كامبريدج. مبني على مُرمّز SPEAR موحّد للتعلّم الذاتي من الصوت ديال ByteDance، وعلى مُكيّف لدمج الخصائص متعددة الطبقات، وكيستعمل Qwen3 كأساس لغوي. باستعمال حوالي 1.8万 ساعة من البيانات المراقَبة، قدر يحقق أحسن أداء بين الموديلات مفتوحة المصدر من نفس الحجم فـ3 معايير شاملة: MMAU-Pro وMMAR وMMSU، وزاد لأول مرة ضمن ALLM عام قدرات متقدمة بحال كشف الأحداث الصوتية، كشف التزييف الصوتي، تقييم جودة الكلام والتعرّف على الكلام بالسياق متعدد الوسائط.
02الوظائف الرئيسية ديال SALMONN-2
الفهم العام للصوت: كيدعم مهام متعددة المجالات بحال التعرّف على الكلام، وصف الصوت، فهم الموسيقى، التعرّف على المشاعر والتحقق من هوية المتكلم.
كشف الأحداث الصوتية (SED): كيقدر يحدد ويخرج الفترات الزمنية ديال البداية والنهاية ديال الأحداث الصوتية فالمحيط، بحال نباح الكلاب ولا صوت الخطوات.
كشف التزييف العميق فالصوت: كيحدد واش الكلام حقيقي ولا مزيف، وكيحدد الفترات الزمنية ديال المقاطع المحلية اللي ممكن تكون مركّبة ولا معدّلة.
تقييم جودة الكلام (SQA): كيلتقط الخصائص الصوتية منخفضة المستوى بحال الضجيج، التشويه والوضوح، وكيعطي نقطة للجودة مع تفسير.
التعرّف على الكلام بالسياق متعدد الوسائط (MICL): كيجمع بين لائحة كلمات مكتوبة وملفات صوتية مرجعية للنطق، وكيحسن دقة التعرّف على الكلمات النادرة والأسماء الشخصية غير المألوفة.
03المبدأ التقني ديال SALMONN-2
تابعونا فـWeChat وجاوبو بـ“开源” باش تلتحقو بمجموعة مشاريع الذكاء الاصطناعي مفتوحة المصدر
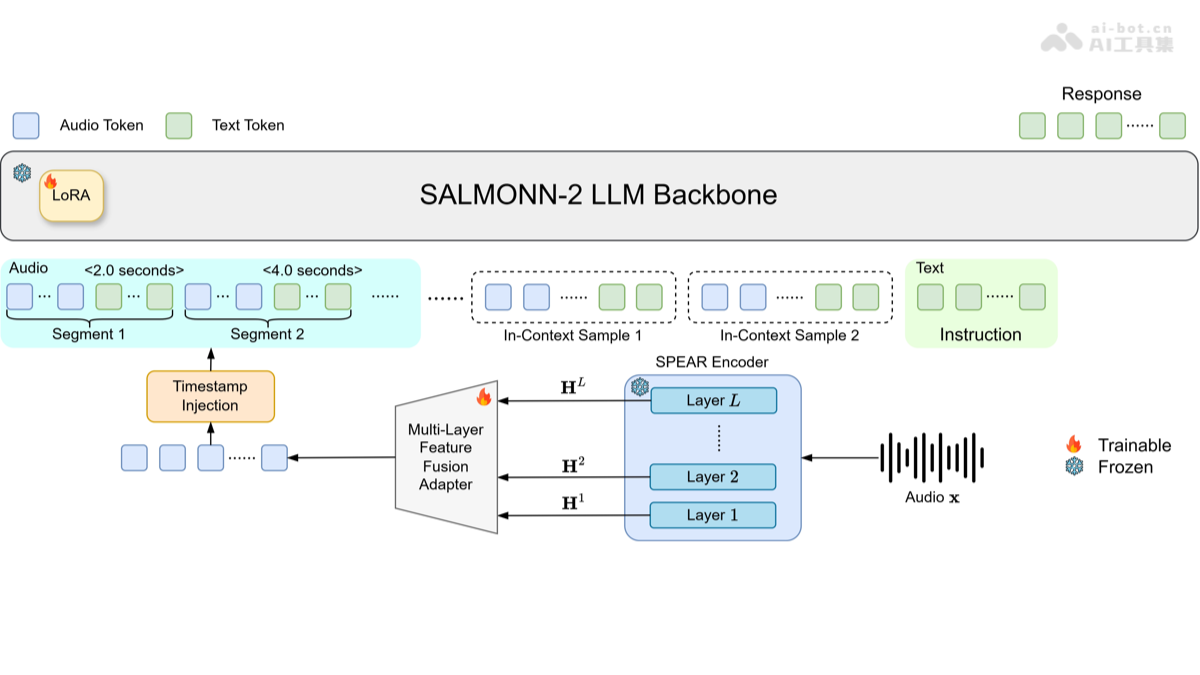
مُرمّز صوتي موحّد للتعلّم الذاتي: SALMONN-2 كيستعمل SPEAR كواجهة صوتية واحدة. المُرمّز تدرّب بالتعلّم الذاتي على كمية كبيرة ديال البيانات الصوتية غير المعلّمة، وكيقدر يلتقط فآن واحد المعلومات الدلالية، النطق، نبرة الصوت، هوية المتكلم والبيئة الصوتية، عوض البنية التقليدية ذات المُرمّزين Whisper+BEATs، مع تبسيط البنية والحفاظ على قدرة أكثر توازناً بين المجالات.
مُكيّف دمج الخصائص متعددة الطبقات (MLF): المعلومات اللي كترمز ليها طبقات SPEAR كتختلف حسب المستوى: الطبقات السطحية كتحافظ على تفاصيل الصوت والنطق، والطبقات الوسطى كتحمل معلومات نبرة الصوت وهوية المتكلم، أما الطبقات العميقة فكتراكم المفاهيم الدلالية. مُكيّف MLF كيدير أولاً تطبيعاً وتجميعاً للحالات الخفية ديال كل طبقة، ومن بعد إسقاطاً سفلياً قابلاً للتعلّم وضغطاً عبر تجميع الإطارات، وفي الأخير كيحوّل التمثيل المدموج متعدد المستويات إلى فضاء تضمينات الموديل اللغوي، باش يقدر الموديل يستعمل بمرونة الإشارات الصوتية من مستويات مختلفة حسب المهمة.
آلية إدماج الطوابع الزمنية: الموديل كيدخل الطوابع الزمنية فشكل نص طبيعي، بحال <2.0 seconds>، مباشرة فمتتالية الصوت، وكيقدمها بالتناوب مع تضمينات الصوت للموديل اللغوي، وبهذا كيقدر ينجز مهام تحديد الوقت داخل إطار توليد موحّد، بلا حاجة لطبقة خاصة بتضمينات الطوابع الزمنية.
التدريب على التعلّم بالسياق متعدد الوسائط (MICL): فمهام التعرّف على الكلام بالسياق، الموديل ماكيستقبلش غير لائحة كلمات منحازة مكتوبة، بل كيتوصل فآن واحد بملفات صوتية مرجعية لنطق هاد الكلمات كسياق متعدد الوسائط. أثناء التدريب، كيتستعمل بشكل عشوائي حذف الكلمات المشتتة والكلمات الهدف، باش يتفادى الانحياز المفرط ويتعلم يستعمل إشارات السياق بشكل مناسب ملي كتدعمو الأدلة الصوتية.
04كيفاش تستعمل SALMONN-2
دخل للمستودع ونسخ الكود: دخل لمستودع GitHub https://github.com/bytedance/SALMONN/tree/salmonn2، واستعمل git clone باش تهبط الكود للحاسوب ديالك.
وجد بيئة التشغيل: نفّذ conda create -n salmonn2 python=3.10 باش تنشئ بيئة افتراضية وتفعّلها، ومن بعد حدّث pip وsetuptools وwheel.
ثبّت الاعتماديات والمشروع: من الجذر ديال المستودع شغّل pip install -r requirements.txt وpip install -e . --no-deps، باش تكمل تثبيت SALMONN-2 والاعتماديات ديال التشغيل.
هبّط الأوزان المدربة مسبقاً: استعمل HuggingFace CLI باش تهبط نقطة تفتيش الموديل: hf download marcoyang/SALMONN-2-8B --repo-type model --local-dir /path/to/salmonn-2-hf.
حمّل الموديل ودير الاستدلال: استعمل AutoProcessor وAutoModelForCausalLM لتحميل الأوزان المحلية، ودوز ملف صوتي ونص التعليمات، ومن بعد عيّط على model.generate() باش تحصل على نتيجة فهم الصوت.
05المزايا الأساسية ديال SALMONN-2
فعالية البيانات: باستعمال حوالي 1.8万 ساعة من البيانات المراقَبة، أقل بزاف من عشرات الآلاف حتى لملايين الساعات اللي كتستعملها المنافسات من نفس الحجم، كيهبط بشكل كبير تكلفة الوسم.
واجهة موحّدة وأكثر توازناً: مُرمّز SPEAR واحد للتعلّم الذاتي عوض مُرمّزين، وكيحقق أداءً أكثر توازناً فالكلام، أصوات المحيط، الموسيقى ومهام الأصوات المرافقة للكلام.
استغلال كامل للمعلومات متعددة المستويات: مُكيّف MLF كيدمج خصائص جميع طبقات المُرمّز، وكيمنع ضياع التفاصيل المهمة بحال الصوت ونبرة المتكلم اللي ممكن تضيع إلا استعملنا غير الطبقة الأخيرة.
توسيع قدرات تحليل الصوت: لأول مرة كيدعم بشكل منهجي داخل ALLM عام مهام تحليل الصوت اللي كانت مهمّشة من قبل، بحال SED وكشف التزييف وتقييم جودة الكلام SQA.
قابلية توسيع الحجم: منين توسّع الأساس اللغوي من 8B حتى 30B-A3B، استمرات النقط ديال المعايير الشاملة الثلاثة كاملين فالارتفاع، وهادشي كيثبت أن البنية عندها قابلية مزيانة للتوسيع فالحجم.
06عنوان مشروع SALMONN-2
مستودع GitHub: https://github.com/bytedance/SALMONN/tree/salmonn2
مستودع الموديل فـHuggingFace: https://huggingface.co/marcoyang/SALMONN-2-8B
البحث التقني فـarXiv: https://arxiv.org/pdf/2607.17079
07مجالات استعمال SALMONN-2
مساعد ذكي للاجتماعات: كيفرّغ محتوى الاجتماع فالحين، وكيستعمل أمثلة نطق المشاركين باش يتعرّف بدقة على الأسماء الأجنبية والمصطلحات المتخصصة.
مراقبة المحتوى الصوتي: كيكتاشف أوتوماتيكياً الأحداث الصوتية غير العادية فالبث المباشر ولا البودكاست، وكيحدد الكلام المزيّف بالتزييف العميق للوقاية من النصب.
مراقبة جودة الكلام: كيدير تقييماً أوتوماتيكياً لجودة مكالمات خدمة الزبناء ومواد الاستوديو، وكيحدد المقاطع اللي فيها ضجيج ولا تشويه.
البحث فالأرشيفات متعددة الوسائط: كينشئ أوصافاً للأحداث مع طوابع زمنية للتسجيلات الصوتية القديمة والبرامج الإذاعية، وكيتيح البحث الدقيق حسب المحتوى.
أجهزة مساعدة للأشخاص ضعاف السمع: كينبّه المستخدمين ضعاف السمع فالحين لأحداث صوتية فالمحيط، بحال جرس الباب والإنذار، فشكل نصوص وطوابع زمنية.
© إخلاء المسؤولية: النطاقات والمحتوى المرتبط يقدرو يتبدلو مع الوقت. AIEZZ ما كيتحكمش فالمواقع التابعة لجهات أخرى. راجع المحتوى الخارجي والمخاطر بشكل مستقل.
تقييمات المستخدمين0