
- الزيارات الشهرية
- 0
- الأسعار
- ما تحددش
- مدرج
- —
- تحدّث
- 2026-09-08
01شنو هو LLaDA-Image؟
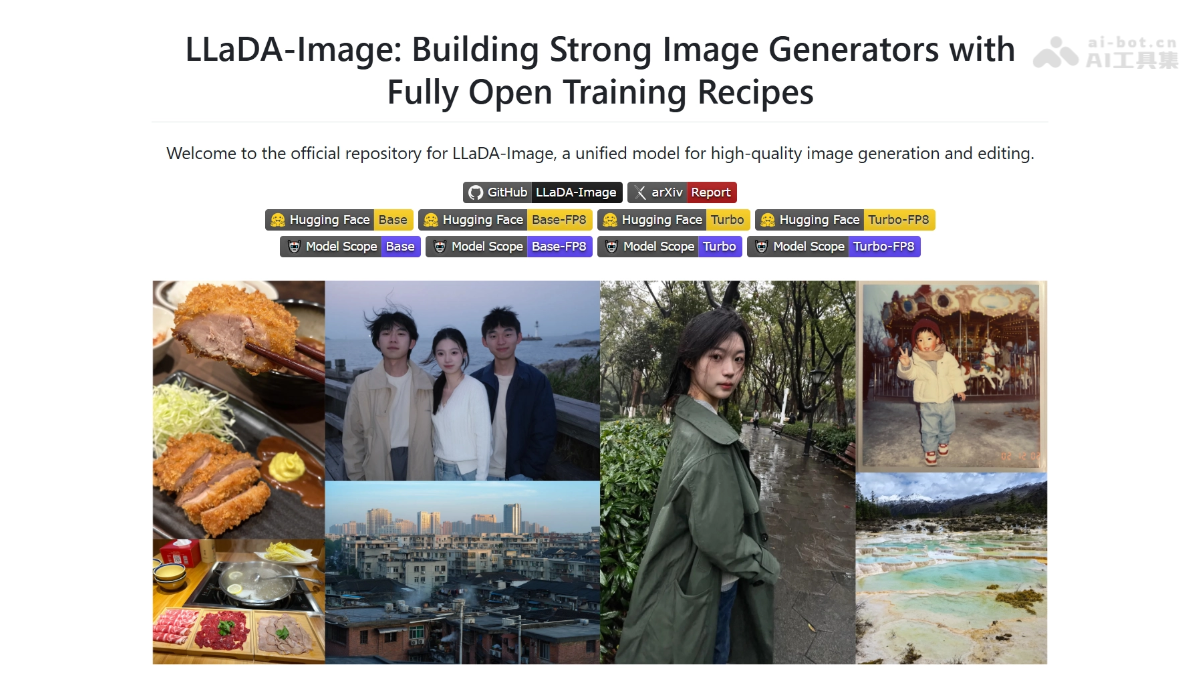
LLaDA-Image هو نموذج موحّد مفتوح المصدر لتوليد الصور وتعديلها، طوّراتو مجموعة Ant Group inclusionAI، وفيه 6B ديال المعاملات. النموذج كيعتمد على مسار مبتكر: التدريب المسبق على الصور فقط، ومن بعد المواءمة مع اللغة. وبنية الانتشار الكاملة ديالو (فهم بـ LLaDA2.0-mini + توليد بـ 6B DiT) كتدعم تحويل النص لصورة، والتعديل بالتعليمات، ورسم النصوص بالصينية والإنجليزية. نسخة Turbo كتخرّج الصورة غير فـ 2–4 خطوات، وحصلات على المرتبة الأولى بين النماذج مفتوحة المصدر فمساري الصينية والإنجليزية بجوج فـ Qwen-Image-Bench.
02الوظائف الرئيسية ديال LLaDA-Image
توليد الصور من النص: توليد صور واقعية بجودة عالية وتفاصيل غنية انطلاقاً من أوصاف مكتوبة بلغة طبيعية.
تعديل الصور بالتعليمات: رفع صورة مرجعية وإدخال تعليمات بلغة طبيعية لتعديل مناطق محددة بدقة مع الحفاظ على باقي الأجزاء كيف ما هي.
عرض النصوص بالصينية والإنجليزية: إظهار النصوص الصينية والإنجليزية بدقة داخل الصور المولَّدة، مع دعم تصميم الملصقات، وتنسيق النصوص، والكتابة الفنية.
التوليد المشروط بـ VQ: توليد صور قابل للتحكم باستعمال رموز التكميم البصري (VQ) كمدخلات مشروطة.
تعديل الصور المرجعية: استعمال الصورة المرفوعة كمرجع لإجراء تعديلات بحال نقل الأسلوب وتغيير المحتوى.
استدلال سريع بـ Turbo: النموذج المُقطَّر كيحتاج غير لـ 2–4 خطوات ديال أخذ العينات باش يولّد صور عالية الجودة بحجم 1024×1024.
03المبدأ التقني لـ LLaDA-Image
تابع حساب WeChat وأرسل «开源» للانضمام إلى مجموعة تبادل مشاريع الذكاء الاصطناعي مفتوحة المصدر
بنية موحّدة قائمة بالكامل على الانتشار: يتكوّن النموذج من وحدة الفهم LLaDA2.0-mini (نموذج لغوي بالانتشار قائم على MoE) ووحدة التوليد 6B DiT. تعتمد الوحدتان في الخلفية على نماذج الانتشار، وتتصلان عبر Connector، ما يتيح فصل الفهم الدلالي عن توليد البكسلات.
استراتيجية تدريب على مراحل: كيتّبع النموذج مسار «يتعلّم الرسم أولاً، ثم يتعلّم الاستجابة للتعليمات». في البداية، كيدوز من تدريب قبلي وتدريب متوسط خاصّين بالصور لبناء أولوية قوية لتوليد الصور، ومن بعد كيتضاف الإشراف اللغوي المزدوج لتحقيق المحاذاة بين النص والصورة.
بناء بيانات عالية الجودة: استُخدم فالتدريب على التوليد ما مجموعه حوالي 2.2 مليار عيّنة، و98% منها صور حقيقية. أوصاف الصور والنصوص فمرحلة المحاذاة اللغوية كينتجها وكيصادق عليها نموذج كبير من سلسلة Qwen، باش تكون دقّة اتّباع التعليمات مضمونة.
تحسين التدريب بكفاءة: كتستعمل السلسلة كاملة RMSNorm غير المرتبط بالمعلمات بدل LayerNorm، مع اعتماد مُحسِّن Muon، لتحسين الاستقرار والكفاءة ديال التدريب واسع النطاق.
التقطير السريع Twin-DMD: كتضغط نسخة Turbo نموذج Base باستعمال تقنية تقطير Twin-DMD، وكتقدر تولّد صور عالية الجودة بدقة 1024×1024 عبر 2–4 خطوات من أخذ العينات، محققة توازناً بين السرعة والجودة.
04كيفاش تستعمل LLaDA-Image
إعداد البيئة: نصّب Python 3.11 وPyTorch 2.8 وDiffusers 0.39.0 وFlashAttention 2.8.3 وغيرها من الاعتماديات، وجهّز بيئة استدلال محلية.
الحصول على الأوزان: حمّل ملفات موديل LLaDA-Image (النسخة عالية الدقة) أو LLaDA-Image-Turbo (النسخة السريعة) من Hugging Face أو ModelScope ديال魔搭.
توليد الصور انطلاقاً من النص: من بعد ما تحمّل الموديل، دخل وصف نصّي؛ خلّي نسخة Base على 50 خطوة وguidance scale بقيمة 5.0، ونسخة Turbo على 2–4 خطوات وguidance scale بقيمة 1.0، باش تولّد صورة بحجم 1024×1024.
تعديل الصور بالتعليمات: حمّل صورة مرجعية ودخل تعليمة تعديل باللغة الطبيعية (بحال «بدّل الخلفية وخليها فالبحر»)، والموديل كيحافظ أوتوماتيكياً على المناطق اللي ما تعدلاتش.
ردّ بالك لمعايير الحجم: خاص أحجام الإدخال فالتوليد من النص وتوليد VQ المشروط تكون من مضاعفات 16، ومهام التعديل من مضاعفات 32.
05المزايا الأساسية ديال LLaDA-Image
أداء رائد مفتوح المصدر: احتلّ المرتبة الأولى بين النماذج المفتوحة المصدر فالمسارين الصيني والإنجليزي بجوج فـ Qwen-Image-Bench، وتجاوز النقاط الإجمالية ديالو نماذج مفتوحة المصدر رئيسية بحال FLUX.2 Max.
التوليد والتحرير فموديل واحد: نفس الموديل كيدعم فآن واحد توليد صور بجودة عالية انطلاقاً من النص، وتحرير الصور بتعليمات دقيقة، بلا حاجة للتبديل بين نماذج مختلفة.
استدلال سريع بزاف: نسخة Turbo المقطّرة كتحتاج غير من 2 حتى لـ4 خطوات ديال أخذ العينات باش تولّد صور عالية الدقة بحجم 1024×1024، وكتنقص وقت الانتظار بشكل كبير.
رندرة النصوص بالصينية والإنجليزية: عندو قدرة ممتازة على توليد النصوص بالصينية والإنجليزية، وكيقدر يتكلف بمهام التصميم بحال الملصقات، تنسيق الصفحات، والخطوط الفنية.
واقعية بمستوى الصور الفوتوغرافية: بفضل بيانات تدريب مسبق مبنية بنسبة 98% على صور حقيقية، النتائج المولّدة فيها إضاءة طبيعية، تفاصيل غنية، وواقعية عالية بزاف.
06روابط مشروع LLaDA-Image
مستودع GitHub: https://github.com/inclusionAI/LLaDA-Image
مستودع النماذج فـ HuggingFace: https://huggingface.co/collections/inclusionAI/llada-image
البحث التقني فـ arXiv: https://arxiv.org/pdf/2609.03796
07مجالات استعمال LLaDA-Image
التصميم البصري ديال التجارة الإلكترونية: توليد الصورة الرئيسية ديال المنتوج بكليك وحدة انطلاقاً من وصفو، ولا تبديل الخلفية وتعديل الضو والظلال بسرعة باستعمال التعليمات، باش تنقص تكلفة التصوير وما بعد الإنتاج.
صناعة بوسترات التسويق: بفضل القدرة المزيانة على توليد النصوص بالصينية والإنجليزية، تقدر تولّد مباشرة بوسترات تجارية وتصاور للسوشيال ميديا فيهم شعار العلامة التجارية ومعلومات الحملة.
صناعة المحتوى للسوشيال ميديا: توفير توليد تصاور بجودة بحال الصور الفوتوغرافية للبورتريهات والمناظر الطبيعية ونمط الحياة للمدونين وصنّاع المحتوى، مع دعم التعديل بأساليب مختلفة والإخراج السريع للتصاور.
التصميم المفاهيمي ديال الألعاب والأفلام: إنتاج تصاور مفاهيمية للشخصيات والمشاهد بسرعة انطلاقاً من النص، وتعديل التفاصيل بالتعليمات بشكل متكرر، لتسريع المرحلة الإبداعية الأولية.
تنقيح التصاور الشخصية: من بعد رفع الصورة، تنفيذ عمليات بحال حذف العناصر الزايدة، وتبديل السما، وتعديل الألوان باستعمال تعليمات باللغة الطبيعية، مع الحفاظ على المناطق اللي ما تبدلاتش، وتعويض برامج تعديل التصاور المعقدة.
© إخلاء المسؤولية: النطاقات والمحتوى المرتبط يقدرو يتبدلو مع الوقت. AIEZZ ما كيتحكمش فالمواقع التابعة لجهات أخرى. راجع المحتوى الخارجي والمخاطر بشكل مستقل.
تقييمات المستخدمين0