
- الزيارات الشهرية
- 0
- الأسعار
- ما تحددش
- مدرج
- —
- تحدّث
- 2026-10-11
01شنو هو PixelUMM؟
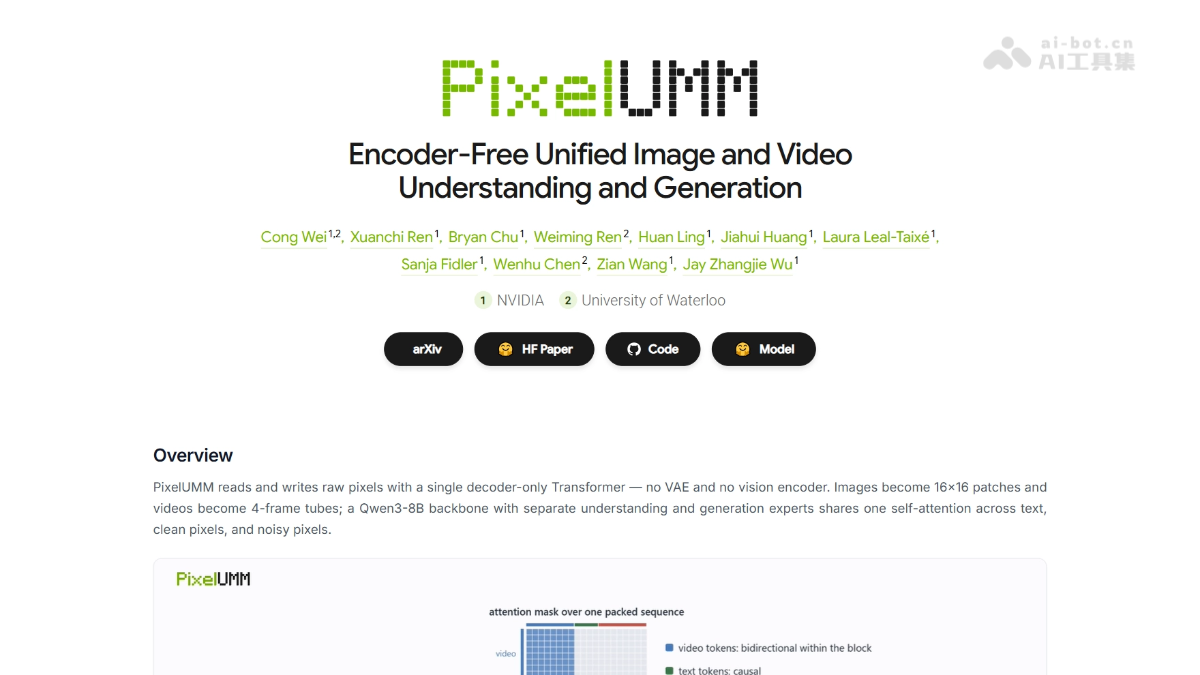
PixelUMM هو موديل موحّد متعدد الوسائط بلا مُرمِّز، طوّراتو NVIDIA وجامعة واترلو. الاختراق الأساسي ديالو هو الحيد النهائي ديال VAE والمُرمِّز البصري، واستعمال Transformer واحد من نوع Decoder-only كيقرأ وكيكتب الصور والفيديو مباشرة ففضاء البكسلات الأصلية، بحيث الفهم والتوليد كيتقاسمو نفس الـ decoder والانتباه الذاتي. كتتقسم الصور لـ patchات بحجم 16×16، والفيديو لـ tubeletات ديال 4 فريمات، والكود محلول المصدر.
02الوظائف الرئيسية ديال PixelUMM
تحويل النص لفيديو (T2V): كيدعم توليد فيديوهات حتى لـ 832×464، بـ 96 فريم و24fps، وبمدة 4 ثواني، بجودة قريبة من موديلات diffusion الرائدة فالفيديو.
تحويل النص لصورة (T2I): كينتج الصور مباشرة داخل نفس الموديل، بلا حاجة لفرع صور أو decoder مستقل.
فهم الصور: كيقدر ينجز 21 مهمة لفهم الصور، بحال VQA وOCR وتحليل الرسوم البيانية والوثائق، وبمستوى متوسط قريب من VLMات ديال فئة 8B.
فهم الفيديو: كيدعم معايير الأسئلة والأجوبة على الفيديو بحال MVBench وVideo-MME، وكيتيح جوج أنماط للإدخال: dense وsparse.
تحويل الصورة لفيديو (I2V): كتدخل الصورة النظيفة ديال الفريم الأول كشرط عند خبير الفهم، ومن بعد كيتولد الفيديو الموالي بلا ترميز فريم الشرط باستعمال VAE.
تعديل الفيديو: كيتستعمل الفيديو المدخل كشرط بصري، وكتتنجز مهام التعديل عبر آلية السياق الشرطي متعدد الوسائط.
03المبدأ التقني ديال PixelUMM
معمارية بلا مُرمِّز: PixelUMM حيد بشكل نهائي VAE والمُرمِّز البصري اللي كيتستعملو فالموديلات الموحّدة التقليدية. كتتقسم الصورة مباشرة لـ patchات بحجم 16×16، والفيديو لـ tubeletات ديال 4 فريمات بصيغة بكسلات RGB أصلية، وحتى المخرجات كيرجعها رأس خطي مباشرة على شكل بكسلات. العملية كاملة ما فيهاش خسارة ديال الترميز وفك الترميز ففضاء latent، وهاد الشي كيحقق قراءة وكتابة حقيقية من الطرف للطرف ففضاء البكسلات.
بنية MoT بانتباه مشترك: الموديل مبني على Qwen3-8B وكيستعمل Mixture-of-Transformers، بحيث خبير الفهم وخبير التوليد عند كل واحد فيهم FFN مستقل، ولكن كيتقاسمو نفس self-attention. بهاد الطريقة كيتفاعلو النص والبكسلات النظيفة والبكسلات المشوشة ففضاء انتباه واحد، وكيجمع الموديل بين الفهم والتوليد.
التدريب بالانتشار ففضاء البكسلات: مهام التوليد كتتدرّب مباشرة ففضاء البكسلات بطريقة flow-matching. تجارب الإزالة كتبرهن أن معيار التدرجات ففضاء البكسلات وفضاء VAE شبه متطابق، ولكن التدريب ففضاء البكسلات أكثر استقراراً. كما بينات تجارب نسبة الضغط أن patchات 16×16 وtubeletات ديال 4 فريمات هي أحسن توازن بين صعوبة التعلم والفعالية.
آلية إدخال الشروط متعددة الوسائط: الشروط النظيفة، بحال شرط النص والصورة المرجعية والفيديو المدخل، كتمشي كاملة لخبير الفهم، بينما tokenات المشوشة اللي غادي تتولد كتمشي لخبير التوليد. كيندمجو بجوج فآلية الانتباه المشترك، وبهذا توسعات طريقة SenseNova-U1 لإدخال الشروط بلا encoder لتشمل تحويل الصورة لفيديو وتعديل الفيديو. التجارب كتبرهن أن هاد التصميم ما كيضرش بقدرة الفهم، وكيحسن النتائج فـ4 معايير للفيديو بـ 0.89–3.49 نقطة.
مقارنة الرأس الخطي بالرأس الالتفافي: كيتستعمل افتراضياً رأس إخراج خطي وخفيف، ولكنه كيقدر يسبب تشوهات فشبكة ديال 16 بكسل. المقارنة مع رأس الالتفاف بالرفع التدريجي على طريقة Wan ومع رأس PixelShuffle بينات أن الرأس الالتفافي كيحيد هاد التشوهات، وأن PixelShuffle بالأولوية الزمنية هو أحسن حل وسط بين خسارة التدريب والحد من التشوهات. تبديل الرأس كيتطلب إعادة التدريب.
04كيفاش تستعمل PixelUMM
نسخ المستودع: git clone https://github.com/nv-tlabs/PixelUMM، ومن بعد ضبط بيئة CUDA حسب ENVIRONMENT.md.
تحميل الأوزان: حمّل checkpoint الافتراضي S8-F22-R05 من nvidia/PixelUMM على Hugging Face، وحسب CHECKPOINT.md حمّل إعدادات وملفات tokenizer ديال Qwen3-8B.
ضبط المسارات: عيّن متغيرات البيئة PIXELUMM_CKPT وPIXELUMM_QWEN_DIR وPIXELUMM_OUTPUT باش يشيرو لمسارات مطلقة محلية.
التحقق من checkpoint: شغّل أولاً check_checkpoint.py باش تتأكد من سلامة الأوزان وتوافق tensorات.
طلب صلاحية المراجعة الأمنية: دخل لـ Hugging Face وطلب صلاحية الولوج لـ nvidia/Cosmos-1.0-Guardrail، ومن بعد دير تسجيل الدخول.
تشغيل الاستدلال: استعمل inference.py وحدد --task t2i / t2v / image-vlm / video-vlm، مع prompt والدقة وعدد الفريمات وباقي المعاملات، باش تولد الصور والفيديو أو تخرج نتائج الفهم.
التوليد بالجملة (اختياري): استعمل inference_batch.py مع ملف YAML ديال promptات لتشغيل المهام بالجملة.
التدريب التجريبي (اختياري): حسب TRAIN.md حمّل toy dataset، واستعمل train_toy.py لتشغيل مثال تدريب على 4 مهام انطلاقاً من checkpoint F22.
05المزايا الأساسية ديال PixelUMM
معمارية بلا مُرمِّز بشكل كامل: حيد VAE والمُرمِّز البصري، وكيقرا وكيكتب مباشرة ففضاء البكسلات الأصلية، وكيحيد خسارة المعلومات ومصادر التشوهات الناتجة عن الترميز وفك الترميز ففضاء latent.
توحيد الفهم والتوليد: Transformer واحد من نوع decoder-only كينجز فـ نفس الوقت تحويل النص لصورة، وتحويل النص لفيديو، وفهم الصور، وفهم الفيديو، مع تقاسم نفس self-attention بين خبير الفهم وخبير التوليد.
معمارية بسيطة واستدلال مباشر: المخرجات كيرجعها رأس خطي وخفيف مباشرة على شكل بكسلات، بلا decoder إضافي، وهاد الشي كيخلي سلسلة التوليد أقصر.
إدخال الشروط بمرونة وفعالية: الصورة المرجعية والفيديو المدخل وباقي الشروط النظيفة كتمشي لخبير الفهم، وبهذا كيتحقق تحويل الصورة لفيديو وتعديل الفيديو. والتجارب كتبرهن أن هاد التصميم ما كيضرش بقدرة الفهم.
قواعد تدريب واضحة وقابلة للتوسيع: موديل 8B كيوصل لنفس الخسارة باستعمال تقريباً ثلث عدد خطوات التدريب اللي كيحتاجها موديل 1.7B، وهاد الشي كيبين بوضوح فوائد التوسيع.
06روابط مشروع PixelUMM
الموقع الرسمي للمشروع: https://nv-tlabs.github.io/PixelUMM/
مستودع GitHub: https://github.com/nv-tlabs/PixelUMM
مستودع الموديل على Hugging Face: https://huggingface.co/nvidia/PixelUMM
البحث التقني على arXiv: https://arxiv.org/pdf/2609.38597
07مجالات استعمال PixelUMM
صناعة محتوى الفيديوهات القصيرة: دخل جملة وحدة وولّد فيديو ديال 4 ثواني بـ 24fps، مناسب لإنتاج مواد بسرعة لوسائل التواصل الاجتماعي.
تحويل الصورة لفيديو وتعديل الفيديو: استعمل الفريم الأول أو الفيديو الأصلي كشرط لتوليد المحتوى أو تغييره، ويمكن توظيف هاد الشي فالعرض المتحرك للمنتجات التجارية والبروفات الأولية للأعمال السينمائية.
فهم الفيديوهات الطويلة والأسئلة والأجوبة: دير وصف وتلخيص واستدلال زمني على الفيديو المدخل، وهاد الشي مناسب لمراقبة المحتوى والبحث على المواد وإعداد محاضر الاجتماعات.
تحليل الوثائق والرسوم البيانية: نتائج OCRBench 78.0 وDocVQA 90.4 كتدعم سيناريوهات ذكية للوثائق فالشركات، بحال التعرف على الفواتير والأسئلة والأجوبة على التقارير.
© إخلاء المسؤولية: النطاقات والمحتوى المرتبط يقدرو يتبدلو مع الوقت. AIEZZ ما كيتحكمش فالمواقع التابعة لجهات أخرى. راجع المحتوى الخارجي والمخاطر بشكل مستقل.
تقييمات المستخدمين0