

شنو كيدير AnyJev
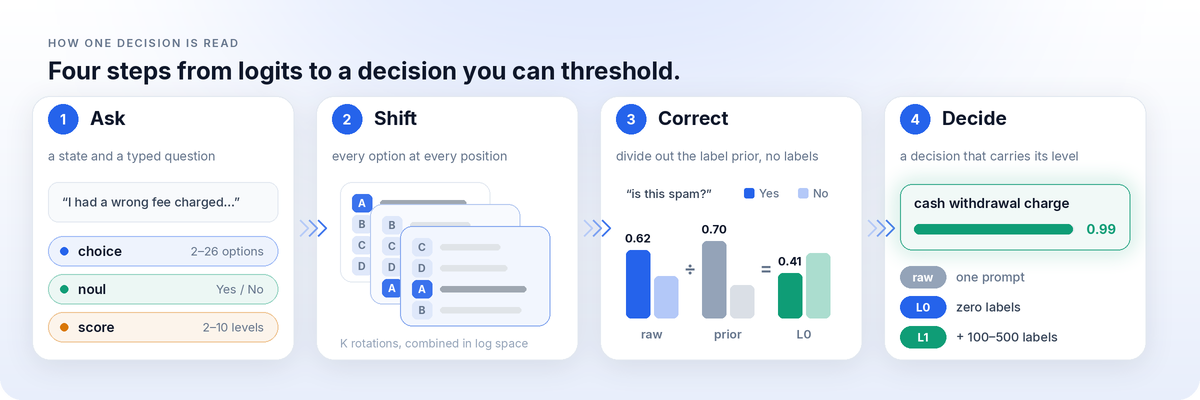
AnyJev كيحوّل موديل لغة مفتوح لموديل ديال القرارات على طريقة Jev. بلا ما نطلبو من الموديل يولّد جواب ومن بعد نفسّرو النص ديالو، AnyJev كيقرا توزيع التوكن الجاي من الموديل من بعد الـprefill وكيَرَجّع قرار مكتوب النوع ومعاه الاحتمالات.
هاد الشي مفيد فخدمات بحال توجيه طلب، تقدير واش شي إجراء فيه مخاطرة، ولا تنقيط واش المهمة كملات. كل نتيجة كتسجّل مستوى القرار المستعمل، وهاد الشي كيخلّي الكود اللي من بعد يفرّق بين نتيجة ما معايراش ولا بلا labels ونتيجة خارجة من head مدرّب.
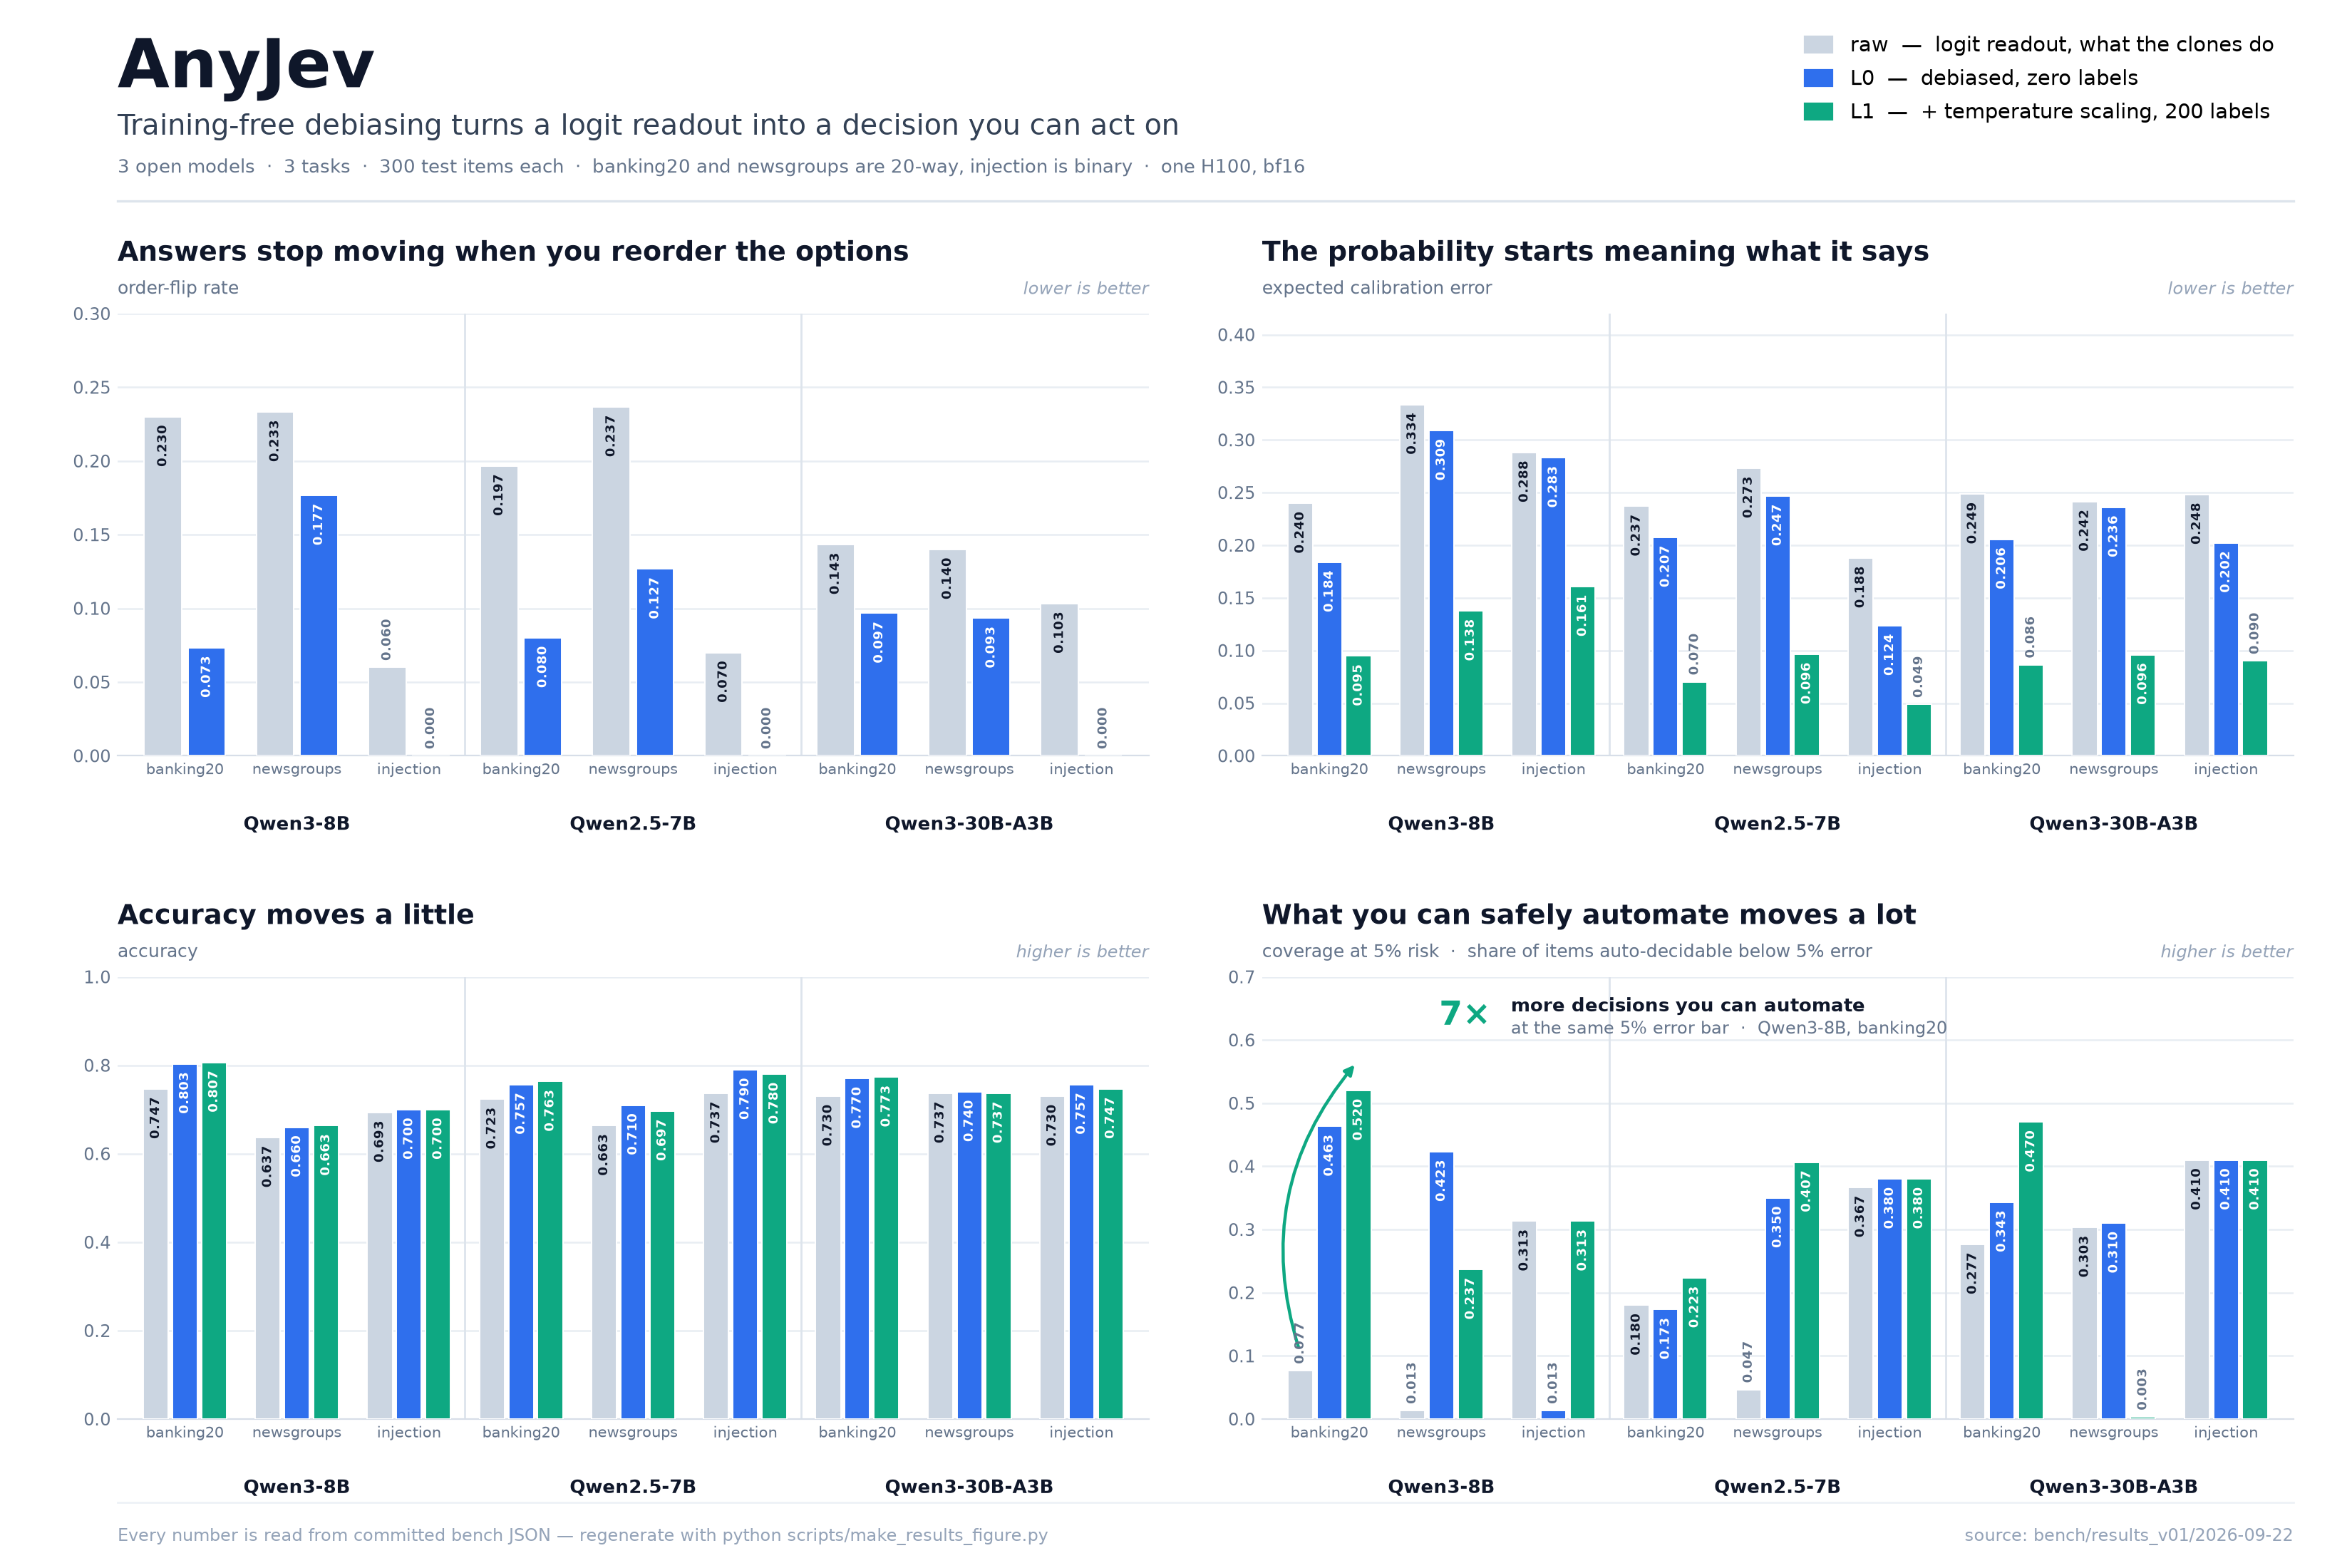
AnyJev كيعالج جوج مشاكل عملية فـraw logits: التنبؤات تقدر تتبدّل ملي كيتبدّل ترتيب الاختيارات، وقيم الثقة الخام ممكن ما تكونش معايرة مزيان كفاية للأتمتة المبنية على العتبات. فالتجربة ديال Qwen3-8B BANKING77 فـREADME، L0 هبط معدل تبدّل الاختيار بسبب ترتيب الخيارات من 0.230 لـ0.073 بلا labels. وL1 هبط خطأ المعايرة المتوقع من 0.240 لـ0.095 باستعمال أمثلة معلّمة.
مستويات القرار
AnyJev كيوفّر بزاف ديال المستويات، وكل واحد عندو متطلبات مختلفة فالبيانات والتشغيل:
- raw: كيطبّق softmax محدود على توكنات labels. ما كيصحّحش انحياز الموضع وما كيعايرش الثقة.
- L0: ما كيحتاج حتى labels. كييّمم تدويرات الاختيارات، كيدير المتوسط باش ينقص انحياز الموضع، وكيقسم على prior مقدّر ديال label.
- L1: كيستعمل تقريباً 100–500 label لكل سؤال باش يدرّب temperature scaling فوق L0. كيحسّن المعايرة ولكن ما كيبدّلش الترتيب.
- L2: كيستعمل تقريباً 100–300 label لكل سؤال باش يحلّ head ديال LDA مصغّر ولا ridge انطلاقاً من hidden state وسطاني. كيحتاج موديل محلي وكيكون خاص بالموديل والسؤال بجوج.
L0 كيحتاج بزاف ديال prefills فاختيار فيه بزاف ديال الخيارات حيث كيقيّم التدويرات. أما L2 كيستعمل prompt واحد وكيوقف فـblock وسطاني محدد، وهاد الشي كيخلّيه أرخص من forward pass كامل فالتجارب المبلّغ عليها ديال Qwen3.
المزايا الرئيسية
- أسئلة مكتوبة النوع من نوع
choiceوnoulوscore. - ما كاين لا توليد ديال النص لا تحليل ديال الجواب.
- تصحيح L0 بلا labels لتأثيرات موضع الاختيار وprior ديال label.
- معايرة L1 بالحرارة باستعمال بضع مئات من labels.
- رؤوس L2 بصيغة مغلقة كتتدرّب فثواني بلا gradients ولا fine-tuning للموديل.
- اختيار أوتوماتيكي لـL2 ولا L1 ولا L0 باستعمال
level="auto". - جمع تدريجي للـlabels باستعمال
observe. - قرارات دفعة وحدة لعدد كبير من الحالات وسؤال واحد.
- ملفات JSON صغار يمكن تحفظهم وتحملهم من بعد للتشغيل.
التثبيت والإعداد
ثبّت backend ديال Hugging Face
ثبّت AnyJev مع تكامل Hugging Face ديالو:
pip install "anyjev[hf]"الإصدار الحالي كيشغّل جميع مستويات القرار عبر backend المبني على Transformers وهو anyjev.backends.hf. دعم vLLM وSGLang داخل فخارطة الطريق وما متوفرش فهاد الإصدار.
صايب decider
دخل الـAPI الأساسي ووجد HFBackend مع موديل مفتوح:
from anyjev import Decider, Question
from anyjev.backends.hf import HFBackend

decider = Decider(HFBackend("Qwen/Qwen3-8B"))
رؤوس L2 اللي جايين مع الحزمة كيغطيّو خمسة ديال موديلات Qwen3: 1.7B و4B و8B و30B-A3B و32B. رؤوس L2 كيبقاو خاصين بالموديل الأساسي وبالسؤال، يعني head تدرّب لموديل ولا سؤال واحد ما يقدرش يتعاود يستعمل أوتوماتيكياً مع واحد آخر.
عرّف أسئلة مكتوبة النوع
السؤال كيوصف نوع الخرج، والأجوبة الصالحة، واسم ثابت. تقدر تقيّم أنواع مختلفة ديال الأسئلة على نفس حالة التطبيق.
route = Question.choice(
    "Which team should handle this?",
    ["billing", "technical", "sales", "other"],
    name="route",
)

risky = Question.noul(
    "Is this tool call destructive or irreversible?",
    name="risky",
)

done = Question.score(
    "How complete is the task?",
    bins=5,
    name="done",
)
استعمل choice لقرار تصنيفي، وnoul لقرار صحيح ولا خطأ، وscore لتنقيط رقمي مقسّم لفئات. القراءة ديال حروف التوكنات كتدعم حالياً حتى لـ26 اختيار.
دير قرار L0 أساسي
L0 هو الافتراضي وما كيحتاج حتى أمثلة معلّمة. صايب state فيها المعلومات اللي محتاجاها الأسئلة، ومن بعد عيّط لـdecide:
state = {
    "conversation": [
        {"role": "user", "content": "I was charged twice."}
    ],
    "tool_call": {
        "name": "refund_payment",
        "arguments": {"payment_id": "pay_123"},
    },
}

result = decider.decide(state, [route, risky, done])

print(result["route"].distribution)
print(result["risky"].p_true)
print(result["done"].value)
print(result.level)
توزيع نموذجي ديال route يقدر يربط كل اختيار عطيتِيه باحتمال. القرارات الثنائية كتكشف p_true، وقرارات التنقيط كتكشف value. النتيجة العامة كترجّع L0 ملي ما كاين حتى artifact بمستوى أعلى.
خاص تفسير الاحتمالات يكون حسب المستوى ديالها. L0 كيحسّن الاستقرار وكيصحّح انحياز label المقدّر، ولكن ما كيخليش عدم اليقين معاير بشكل كامل.
زِد معايرة L1
إلى كان عندك تقريباً 100–500 حالة معلّمة لسؤال واحد، عيّط لـcalibrate باش تدرّب temperature ديال L1:
decider.calibrate(risky, states, labels)L1 كيعاير الاحتمالات اللي كتنتج فوق L0. ما كيبدّلش شنو هو الجواب اللي كياخذ الرتبة الأولى، ولكن يقدر يخلي عتبات الثقة عندها معنى أكثر.
درّب Head L2 بصيغة مغلقة
باش تكون الدقّة أعلى، درّب رأس L2 خاص بالسؤال باستعمال تقريباً 100–300 مثال مُعنون:
decider.fit_head(route, states, labels)

decider.save_artifacts("qwen3-8b.json")
التدريب كيدوز النموذج مرّة وحدة على الأمثلة، ومن بعد كيحلّ الرأس بطريقة مغلقة. ما كيستعملش التدرّجات وما كيبدّلش أوزان النموذج اللغوي. حسب المشروع، الرأس كيكون غالباً فحدود 100 KB، وكيقدر يتحلّ فثواني بالنسبة لنماذج Qwen3 الصغيرة المدعومة.
حمّل القطع المحفوظة فعملية لاحقة، ومن بعد طلب اختيار المستوى بشكل آلي:
decider.load_artifacts("qwen3-8b.json")

result = decider.decide(state, [route], level="auto")
print(result["route"].level)
مع level="auto"، AnyJev كيستعمل L2 إلا كان رأس متوافق يقدر يوجّه السؤال. وإلا كيرجع لـ L1 إلا كانت المعايرة متوفرة، ومن بعد لـ L0.
جمع التسميات بالتدريج
AnyJev كيقدر يقبل التسميات ملي كتوصل من طابور المراجعة، أو من النتائج الملاحظة، أو من مصدر آخر ديال الملاحظات:
decider.observe(route, state, correct_label)الحلقة الآلية ديال المشروع كتحلّ الرأس من بعد 30 ملاحظة، ومن بعد كتعيد حلّه عند 60 و120، وفكل محطة لاحقة. هاد الشي كيدعم دورة نشر كيبدأ فيها السؤال الجديد بـ L0، وكينتاقل لـ L2 من بعد ما يتجمع ما يكفي من الملاحظات.
الاستدلال على دفعات
ملي كتطبّق سؤال واحد على بزاف ديال الحالات، استعمل واجهة الدفعات عوض ما تعاود تنادي على decide كل مرة:
results = decider.decide_batch(states, route)هاد الواجهة هي المخصّصة لمعالجة مدخلات كثيرة باستعمال سؤال واحد مُكتّب الأنواع.
جرّب العرض التجريبي المضمّن
من نسخة محلية من المستودع، شغّل العرض التجريبي الاصطناعي بلا ما تهبط النموذج:
python -m demo.jev_mode --backend fakeباش تحاكي دورة النشر، زِد خيار دورة الحياة:
python -m demo.jev_mode --backend fake --lifecycleحيد --backend fake باش تشغّل العرض الحقيقي ديال Qwen3 بالرؤوس المرفقة.
نصائح متقدمة للنشر
خلّي هوية السؤال ثابتة
L2 كيتدرّب لكل سؤال ولكل نموذج. أي مجموعة جديدة ديال الاختيارات كتحتاج تسميات جديدة ورأس جديد. إعادة صياغة نفس السؤال أو تبديل ترتيب نفس الاختيارات يقدر يوجّه لرأس موجود من قبل.
استعمل المعطيات غير المسمّاة للتكيّف مع الصياغة
بالنسبة للأسئلة اللي تعاودات صياغتها، AnyJev يقدر يعاود يوسّط متوسط الخصائص ديال الرأس ويضبط المقياس باستعمال تقريباً 30 طلب بلا تسميات. هاد التكيّف كينطبق على صياغة السؤال وترتيب الاختيارات، وما كيكتاشفش التغيّر فحالات التطبيق نفسها.
راقب تغيّر المعطيات الحقيقية
حيت تغيّرات توزيع الحالات ما كتبانش لآلية إعادة التوسيط، خَلّي عيّنة تقييم كتتسمّى بشكل دوري وراجع الأداء من حين لآخر. ما تعتبرش التكيّف مع الصياغة بديلاً على مراقبة الإنتاج.
ربط الإجراءات بمستوى القرار
كل قرار كيتحمّل المستوى ديالو. الأنظمة اللاحقة تقدر تفحصو قبل تنفيذ إجراء حسّاس، والمشروع كيدعم حتى فرض المستويات باستعمال require=. هاد الشي كيمنع سير عمل مصمّم لقرارات معايرة أو قرارات L2 من أنه يتصرّف بلا ما يبان على نتيجة رجعات لمستوى احتياطي.
اختار العتبات غير من بعد التحقّق
الفائدة الرئيسية من المعايرة هي أنها كتسمح بإرسال الحالات ذات الثقة العالية للأتمتة، مع تصعيد الحالات غير المؤكدة. اختار العتبات باستعمال معطيات معنونة وممثلة، وقِس الخطأ والتغطية الناتجين، وما تفترضش أن الاحتمال المعروض موثوق تلقائياً.
قيود مهمّة
- رؤوس L2 ما كتنتاقلش لسؤال آخر أو لنموذج أساسي آخر.
- الإصدار الحالي ديال المشروع كيجي غير برؤوس Qwen3.
- L2 كيحتاج الولوج للحالات المخفية، واللي كيوفّرها حالياً الواجهة الخلفية ديال Transformers.
- المعايرة ما كتقدرش تخلي النموذج يحلّ مهمة ما قادرش يجاوب عليها من الأساس.
- L0 يقدر ينقص الدقّة ملي كتكون تسمية وحدة مهيمنة بزاف على الأولوية ديال الدفعة.
- القراءة الحالية ديال الحروف كتدعم ما كيزيدش على 26 اختياراً.
- تقدير تغطية المخاطر المبلّغ عليه، وهو 5%، مبني على 300 مثال، وبالتالي التباين ديالو كبير.
- مقاييس دقّة القرارات المبيّنة والمنشورة كتقيس التوافق مع نموذج لغوي معلّم، وماشي حقيقة أساسية مستقلة ومثبتة.
- القرارات المبلّغ عليها تقيّمت بشكل منفصل، وماشي داخل حلقة وكيل كاملة.
الخلاصة
AnyJev كيوفّر تدرّج عملي من القرارات المكتوبة الأنواع بلا أي تسميات، مروراً بالاحتمالات المُعايرة، ووصولاً لرؤوس فعّالة مبنية على الحالات المخفية. بدا بـ L0، وجمع تسميات حقيقية، وزِد L1 ملي تكون المعايرة هي الأولوية، ودرّب L2 ملي تحتاج لمسار قرار أدق ومخصّص للسؤال. حافظ على المستوى المبلّغ عليه، وتحقّق من العتبات، وراقب العينات المسمّاة مع تغيّر معطيات الإنتاج.
للتفاصيل ديال التنفيذ والخطط الحالية، شوف مستودع AnyJev، وعقد المستويات ديالو، ووثائق المعايير، وخارطة الطريق.