

شنو هو Jeff؟
Jeff هو عائلة ديال النماذج المصغّرة Qwen3.5 وGemma 4، مصمّمة للتصنيف السريع بلا أمثلة سابقة. كتقدّم وصف عادي باللّغة الطبيعية للوضعية، وكتحدّد الاختيارات المتاحة، وكتوصل باحتمال مضبوط لكل اختيار من خلال تمريرة أمامية وحدة.
بخلاف نموذج توليدي تقليدي، Jeff ما كيخرجش نصوص خاص التطبيق ديالك يحلّلها. هو مخصّص لاتخاذ قرارات مباشرة فمهام بحال توجيه طلبات الدعم، واكتشاف النية، والمراقبة، والأوامر الصوتية، وحركات الألعاب. الفئات ما خاصهاش تكون موجودة فبيانات التدريب ديالو، بشرط توصفها بوضوح.
Jeff كيستعمل نفس صيغة الطلب ديال Jev، ولكن هو مشروع مستقل وما عندوش علاقة بـ TypeSafe وماشي معتمد من طرفها. كود التدريب ديالو مبني على وصفة AutoJev مفتوحة المصدر.
المزايا الرئيسية
- استدلال محلي سريع: Jeff-Qwen3.5-0.8B كيحتاج تقريباً 22 ms لكل قرار على RTX PRO 6000 و28 ms على Apple M4 Max باستعمال MLX، حسب الاختبار المعلن.
- مخرجات مضبوطة: كل قرار كيتضمن الاحتمالات، والاختيار المحدد، ودرجة الثقة.
- فئات بلا أمثلة سابقة: الاختيارات كتتوصف وقت الطلب، وما كتكونش محصورة فمجموعة ثابتة ديال التسميات.
- ثلاثة أنواع ديال الأسئلة: استعمل أسئلة
choiceأوnoulأوscore. - تجميع الطلبات: يمكن الجواب على عدة أسئلة مستقلة حول نفس الحالة فآن واحد.
- واجهات محلية: شغّلو بـ PyTorch على بطاقات NVIDIA أو المعالجات، أو استعمل MLX مع نموذج Qwen على أجهزة Apple silicon.
- تكييف المجال: درّب نقطة تحقق ديال Jeff من جديد ملي تكون النتائج بلا أمثلة سابقة غير كافية.
اختار النموذج
Jeff كيوفّر ثلاث نقاط تحقق للنماذج على Hugging Face:
- Jeff-Qwen3.5-0.8B: نموذج فيه 0.8 مليار معامل و1.7 GB ديال الأوزان بدقة 16-bit. هو الاختيار الموصى به للتحديد السريع للاختيارات.
- Jeff-Qwen3.5-2B: نموذج فيه 2 مليار معامل و4.2 GB ديال الأوزان بدقة 16-bit. كيسجل نتيجة عامة أعلى فلوحة الاختبارات المعلنة، ولكن أبطأ وأكثر حذراً.
- Jeff-Gemma4-E2B: نموذج فيه 2 مليار معامل فعّال، و4.6 مليار معامل مخزّن، و9.3 GB ديال الأوزان بدقة 16-bit. الواجهة الخلفية ديال المشروع لـ MLX كتدعم غير نماذج Qwen.
فأول نشر، بدا بـ Jeff-Qwen3.5-0.8B. انتقل لنقطة تحقق أخرى غير من بعد ما تقيّمها على أمثلة ممثلة للتطبيق ديالك.
ثبّت ونزّل Jeff
المستودع كيستعمل uv لمزامنة الاعتماديات وتشغيل الأوامر. من مجلد المشروع، ثبّت الاعتماديات الافتراضية ونزّل نقطة تحقق 0.8B:
uv sync
uv run hf download mstrasser/Jeff-Qwen3.5-0.8B --local-dir checkpoints/jeff-0.8b
نقطة التحقق غادي تتحط فـ checkpoints/jeff-0.8b. تقدر تبدّل مستودع Hugging Face والمجلد المحلي إلا بغيتي تستعمل نموذج منشور آخر.
شغّلو بـ PyTorch
بالنسبة لبطاقة NVIDIA أو للمعالج، شغّل الخادم بالواجهة الخلفية الافتراضية ديال PyTorch:
JEFF_CHECKPOINT=checkpoints/jeff-0.8b PORT=8765 uv run jeff-serveشغّلو على Apple silicon باستعمال MLX
على Mac متوافق، ثبّت الاعتماديات الإضافية ديال Mac واختار الواجهة الخلفية MLX. تشغيل MLX متاح لنقاط تحقق Qwen:
uv sync --extra mac
JEFF_BACKEND=mlx JEFF_CHECKPOINT=checkpoints/jeff-0.8b PORT=8765 uv run jeff-serve
الجوج ديال الأوامر كيفتحو الخدمة محلياً على المنفذ 8765.
صيفط أول طلب تصنيف
الطلب فيه state كيوصف الوضعية، وكائن questions كيحدّد قرار واحد أو أكثر. المثال التالي كيطلب من Jeff يوجّه رسالة ديال زبون ويقدّر بشكل مستقل واش الزبون غاضب:
curl -s localhost:8765/v1/systemone \
  -H 'content-type: application/json' \
  -d '{
    "model": "jeff-latest",
    "state": "طلب استرجاع المال: الزبون كيقول إن الطرد وصل مهروس وباغي فلوسو ترجع.",
    "questions": {
      "route": {
        "type": "choice",
        "instructions": "شنو هو الفريق اللي خاصو يتكلف بهاد الحالة؟",
        "criteria": {
          "1": "استرجاع المال والأداءات",
          "2": "الطرود المتضررة أو الضائعة",
          "3": "مشاكل الحساب وتسجيل الدخول"
        }
      },
      "angry": {
        "type": "noul",
        "instructions": "واش الزبون غاضب؟"
      }
    }
  }'
Jeff كيقيّم السؤالين فطلب واحد. كل جواب كيعطي الاحتمالات، والاختيار المحدد، وقيمة الثقة. التطبيق ديالك يقدر يستعمل الجواب المختار مباشرة أو يطبّق عتبة الثقة الخاصة به.
فهم أنواع الأسئلة
Choice
سؤال choice كيختار اختيار واحد من أصل 255 اختيار كحد أقصى. حط معرّفات قصيرة فـ criteria واستعمل القيم المرتبطة بها لشرح معنى الاختيارات.
"route": {
  "type": "choice",
  "instructions": "شنو هو الفريق اللي خاصو يتكلف بهاد الحالة؟",
  "criteria": {
    "1": "استرجاع المال والأداءات",
    "2": "الطرود المتضررة أو الضائعة",
    "3": "مشاكل الحساب وتسجيل الدخول"
  }
}
Noul
سؤال noul كيمثّل قرار بنعم ولا، وكيترجّع على شكل احتمال. كينفع فاختبارات بحال واش الميساج غاضب، مستعجل، غير آمن، ولا عندو علاقة بالموضوع.
"angry": {
  "type": "noul",
  "instructions": "واش الزبون غاضب؟"
}
النقطة
سؤال score كيحط الجواب فمقياس كتحددو نتا. استعملو ملي كيحتاج التطبيق لتقييم متدرّج عوض تصنيف فشكل تسمية.
كتب مطالبات فعّالة للقرارات
صياغة المطالبة كتأثّر بزاف على المصنّفات الصغار. هاد الممارسات مهمّة خصوصاً ملي كتستعمل Jeff.
- فكّر بالكود وخلي Jeff يقرّر. حسب القواعد الحتمية، الحالات المستقبلية، والنتائج متعددة المراحل فالتطبيق ديالك. عطِ Jeff الوضعية الناتجة باش يدير الحكم النهائي.
- وصف النتائج بشكل مباشر. عوض ما تطلب من النموذج يتوقّع أن الطوموبيل غادي توصل من بعد جوج دورات، قول ليه إن حركة معيّنة غادي تخلّيك تضربك طوموبيل.
- خلي أوصاف الاختيارات منسجمة. خاص الاختيارات تستعمل بنية متشابهة وتفاصيل متقاربة. الصياغة غير المنسجمة تقدر تحيّز القرار.
- استعمل مفاتيح قصيرة للاختيارات. فضّل
{"1": "Engagement letter"}على معرّف داخلي طويل. المفاتيح الطويلة كتزيد كلفة المعالجة بلا ما تحسّن وصف الاختيار. - جمع الأسئلة المستقلة. إلا كانت بزاف ديال القرارات كتشترك فنفس الحالة، صيفطها فطلب واحد عوض تعاود نفس المُدخل.
- جرّب بيانات تمثيلية. نتائج الاختبارات المعيارية كتوفّر سياق مفيد، ولكن ما كتضمنش الأداء فمسار عمل معيّن.
Jeff مصنّف وماشي مخطّط. كيخدم أحسن ملي الكود ديالك كيحضّر المعطيات المهمة والنموذج كيختار بين بدائل موصوفة بوضوح.
الأداء والحدود
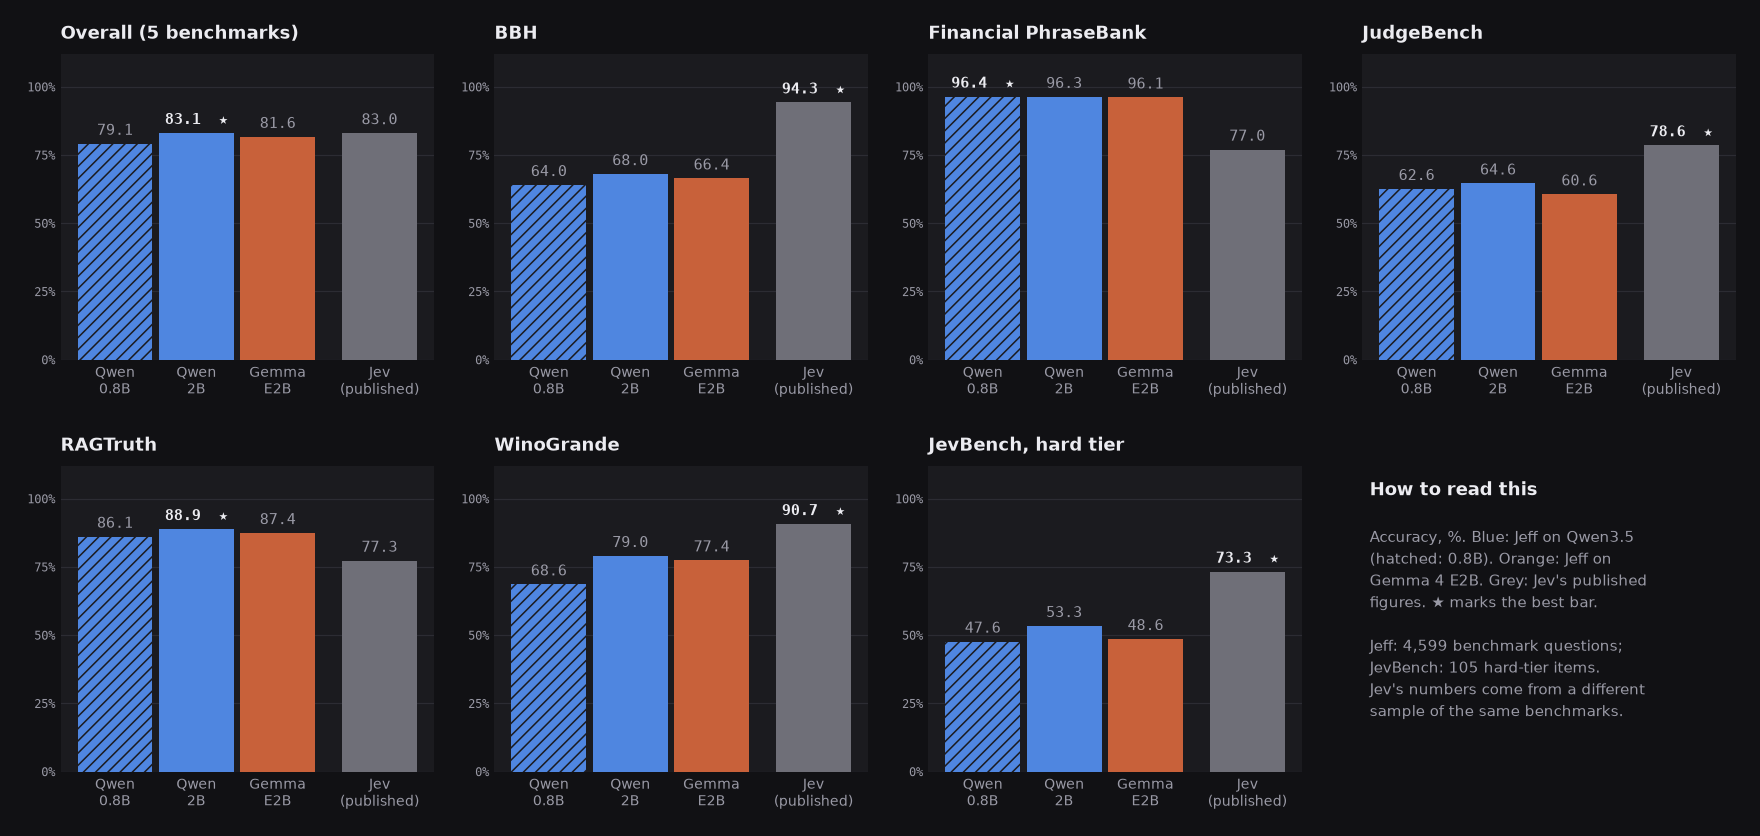
فخمسة اختبارات معيارية عمومية، حصل Jeff-Qwen3.5-0.8B على 79.1، وJeff-Qwen3.5-2B على 83.1، وJeff-Gemma4-E2B على 81.6 فالتقييم ديال المشروع. نتيجة Qwen ديال 2B كانت قريبة من الرقم العام المنشور ديال Jev وهو 83.0، مع العلم أن أرقام Jev وAutoJev تقاست على عينات مختلفة من نفس الاختبارات المعيارية.
النتائج كتختلف بزاف حسب المهمة. Jeff كيدير مزيان فعدة تقييمات ديال التصنيف وربط المعلومات بالسياق، بما فيها Financial PhraseBank وRAGTruth، ولكن باقي أقل من الأنظمة الكبيرة فاختبارات اللي كتركّز على الاستدلال بحال BBH وJudgeBench والمستوى الصعب من JevBench.
أزمنة الاستدلال المتوسطة المعلنة للمدخلات اللي فيها تقريباً 200 رمز كانت 22 ms على RTX PRO 6000، و28 ms على M4 Max باستعمال MLX، و463 ms على CPU فيه 32 خيط بالنسبة لنموذج 0.8B. هاد الأرقام مرتبطة بالعتاد، وخصك تعاود تقيسها فالنشر ديالك.
جرّب مشغّل الألعاب
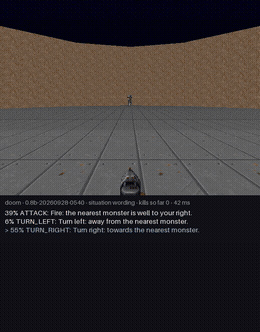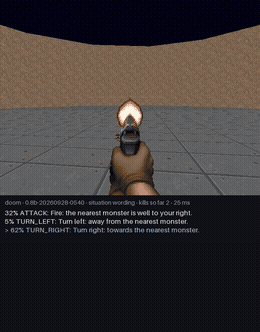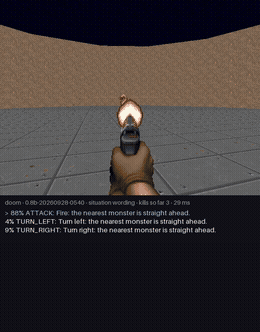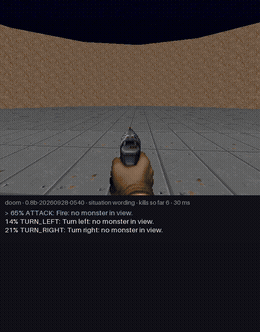
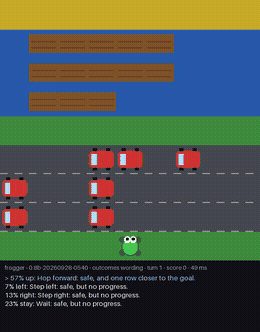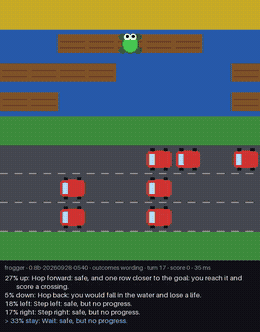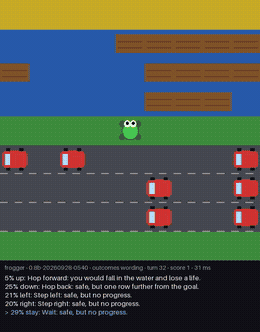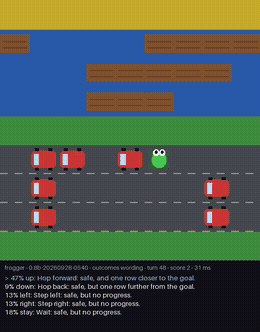
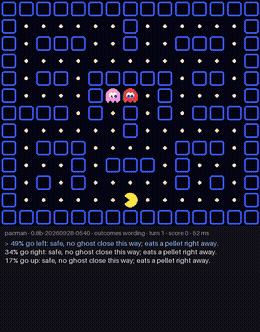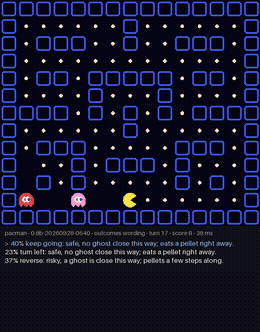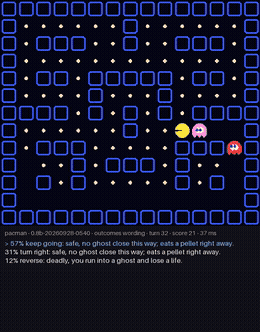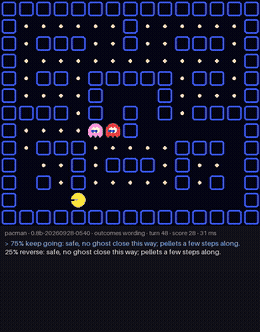
المستودع فيه تجارب ديال Doom وFrogger وPac-Man كتبرهن على اتخاذ القرارات انطلاقاً من الحركات القانونية الموصوفة بشكل ديناميكي. ثبّت تبعيات الألعاب الاختيارية قبل ما تشغّلها:
uv sync --extra gamesإلى كان خادم Jeff خدام من قبل، تقدر تشغّل تقييمات Doom وFrogger الجاهزة:
uv run python -m jeff.games --game doom --player jeff --criteria situation --url http://127.0.0.1:8765 --video --out runs/games/doom.json
uv run python -m jeff.games --game frogger --player jeff --criteria outcomes --url http://127.0.0.1:8765 --out runs/games/frogger.json
وتقدر حتى تشغّل اللاعب ديال Pac-Man المبني على القواعد للمقارنة:
uv run python -m jeff.games --game pacman --player rule --out runs/games/pacman-rule.jsonهاد التجارب كتبرز حتى واحد الحد مهم: الترتيب فاختبارات الأداء ما كيتنبّأش بالضرورة بالأداء فالألعاب التفاعلية. فالنتائج المنشورة، نموذج Jeff ديال 0.8B لعب الألعاب حسن من نموذج Jeff ديال 2B فعدة حالات، رغم أن نموذج 2B جاب نقطة إجمالية أعلى فاختبارات الأداء.
درّب Jeff على المجال ديالك
إلا ما كانتش الدقة بلا أمثلة كافية، بدا من نقطة تفتيش ديال Jeff ودرّب النموذج على أمثلة من التطبيق ديالك. كيوضّح README أن التدريب المتخصص للملاحة الصوتية باستعمال تقريباً 11,000 مثال خاص بالتطبيق طلّع الدقة على البيانات المحجوزة من 31.7% لـ 95.8% فحوالي نص ساعة على GPU واحد.
autojev-train --initial-checkpoint <jeff> --epochs 1 ...المستودع كيوفّر حتى مسار التدريب الأوسع ديالو. التسلسل المعتاد كيبني خليط البيانات، كيدير التدريب، وكيقيّم نقطة التفتيش المختارة:
uv run autojev-mix ...
scripts/train.sh RUN data/mix/public.jsonl data/mix 5e-6 40 Qwen/Qwen3.5-0.8B <revision> --epochs 1
uv run autojev-evaluate --data data/panel.jsonl --local --checkpoint checkpoints/RUN/selected --output runs/eval/RUN.json
الوصفة المنشورة كتستعمل التدريب الكامل للأوزان لمدة دورة وحدة، وحزم من 256، وcross-entropy على حروف الاختيارات، ودرجة حرارة مضبوطة لمعايرة الاحتمالات. كتختار نقاط التفتيش باستعمال مجموعة تطوير عوض لوحة الاختبارات المعيارية.
بالنسبة للمسار المحلي الكامل ديال البيانات الاصطناعية، وتصفية التسريب، وتجارب معدلات التعلّم، ومسار عمل لوحة المعلومات، راجع scripts/train_all.sh. المشروع كيوثّق مصادر التدريب والتراخيص ديالها فـ docs/data-sources.md.
نصائح متقدمة للنشر
- عاير القياس على البيانات ديالك. النموذج العام المُعاير يقدر يبقى محتاج عتبات خاصة بالتطبيق باش يقرر إمتى يصعّد الطلب ولا يستعمل السلوك الاحتياطي.
- زيد حلّ احتياطي آمن. ملي كتكون الثقة ضعيفة بزاف، وجّه الطلب لإنسان، ولا لقاعدة حتمية، ولا لنموذج أكثر قدرة.
- خلي الحالات مختصرة. عطِ الحقائق الضرورية للقرار، وتفادى النصوص اللي ما عندهاش علاقة واللي تقدر تشتّت نموذج صغير.
- قيّم صيغ مختلفة للكلام. قارن بين بزاف ديال الصياغات المنسجمة للتعليمات والمعايير قبل ما تثبّت المخطط ديال الإنتاج.
- اختار النماذج بناءً على التجربة. استعمل نموذج 0.8B لاختيار الخيارات الحسّاس للكمون، ولكن جرّب جميع نقاط التحقق المناسبة على مجموعة التحقق ديالك.
- حترم حدود الوسائط. حسب ملف README، Jeff كيدعم غير النصوص بالإنجليزية.
الخلاصة
كيعطي Jeff طريقة عملية باش تزيد قرارات سريعة ومحلية مبنية على الاحتمالات فالتطبيق، بلا ما تولّد ولا تحلّل نصوص حرة الصياغة. بدا بـ Jeff-Qwen3.5-0.8B، وشرح كل خيار بوضوح، وجمّع الأسئلة المستقلة فطلب واحد، وقيّم النتائج على أمثلة حقيقية من التطبيق. إلا ما كانش السلوك بلا أمثلة كافي، دير الضبط الدقيق لنقطة تحقق موجودة من Jeff باستعمال بيانات خاصة بالمجال.