

شنو هو WeMM-Embedding؟
WeMM-Embedding هي عائلة ديال موديلات شاملة للتمثيل متعدد الوسائط، طوّراتها فرقة WeChat Vision. كتحوّل النصوص، الصور، الفيديوهات، الوثائق البصرية، والمدخلات متعددة الوسائط المتداخلة لتمثيلات موحّدة على شكل متجهات. هاد المتجهات كتعاون فمسارات العمل اللي خاصها تمثّل وتقارن المحتوى بين وسائط مختلفة.
كل موديل كيستخرج التمثيل ديالو من الحالة المخفية فالطبقة الأخيرة، فالموضع المخصص للرمز <embedding>، ومن بعد كيطبّق التطبيع L2. إدخال الصوت مازال ما مدعومش حاليا.
الخصائص الرئيسية
- تمثيلات موحّدة متعددة الوسائط: نفس عائلة الموديلات كتتعامل مع النصوص، الصور، الفيديوهات، الوثائق البصرية، والمدخلات المتداخلة.
- أحجام متعددة للموديلات: اختار بين النسخ اللي فيها 2B أو 4B أو 9B من المعاملات.
- التعلّم بتمثيلات Matryoshka: استعمل أبعاد أقصر للمتجهات ملي كتكون كفاءة التخزين أو الاسترجاع مهمة.
- جوج واجهات للاستدلال: كاينة أمثلة لكل من Transformers وSentence Transformers.
- التشغيل فالإنتاج: المستودع فيه إعدادات وسكريبتات تغليف لـ vLLM وSGLang.
- أدوات التقييم: خط أنابيب MMEB-v3 المرفق كيدعم الاستدلال على عقدة وحدة أو على عدة عقد.
اختيار الموديل والبُعد
مجموعـة الموديلات فيها ثلاث نسخ على Hugging Face. اختار الموديل حسب القدرة الحسابية المتوفرة عندك وحجم التمثيل الكامل اللي محتاجو.
- WeMM-Embedding-2B: كيدعم الأبعاد 64 و128 و256 و512 و1024 و2048.
- WeMM-Embedding-4B: كيدعم الأبعاد 64 و128 و256 و512 و1024 و2560.
- WeMM-Embedding-9B: كيدعم الأبعاد 64 و128 و256 و512 و1024 و2048 و4096.
البُعد الأصغر المدعوم كينقص من تخزين المتجهات ومن الحسابات اللي كتجي من بعد. مثلا، كيشير README إلى أن موديل 2B ببُعد 256 كيحافظ على 98.7% من الأداء ديالو فالصورة والفيديو، مقارنة بالبُعد الكامل، على MMEB-v2.
التثبيت والإعداد
1. جيب المستودع والموديل
خدم من نسخة محلية ديال المستودع، ومن بعد نزّل موديل من الصفحة ديالو فـ Hugging Face، أو عيّن المثال المناسب باش يستعمل معرّف موديل من Hugging Face إلا كان هاد الشي مدعوم.
2. ثبّت الاعتماديات
ثبّت النسخ اللي محددها المشروع:
pip install -r requirements.txt3. ثبّت نسخة Transformers باش تضمن قابلية إعادة الإنتاج
المشروع كيوصي بـ transformers==5.2.0 للاستدلال وقابلية إعادة الإنتاج، حيث الإصدارات الجديدة تقدر تختلف فطريقة المعالجة المسبقة.
pip install transformers==5.2.0وجد المسارات ديال الموديل، صورة الاختبار، وفيديو الاختبار قبل ما تشغّل الأمثلة.
الاستعمال الأساسي مع Transformers
مثال Transformers كينشئ تمثيلات مستقلة لمدخلات النص والصورة والفيديو. شغّلو بمسار محلي للموديل وببُعد إخراج مدعوم:
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
بدّل المسارات المؤقتة بملفات موجودة فالنظام ديالك. بالنسبة لموديل 2B، 2048 هو الحجم الكامل للمتجه. باش تطلب البُعد الكامل للتمثيل ديال الموديل بلا ما تحددو بشكل صريح، حيّد --dimension:
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4
الاستعمال الأساسي مع Sentence Transformers
مثال Sentence Transformers كيدوز مدخلات النص والصورة والفيديو عبر SentenceTransformer.encode(). وكي support حتى اختيار بُعد Matryoshka باستعمال --dimension.
python examples/sentence_transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
حيت SentenceTransformer يقدر يحمّل الموديل مباشرة، تقدر تبدّل المسار المحلي بمعرّف موديل من Hugging Face:
python examples/sentence_transformers_inference.py \
  --model tencent/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
استعمال تمثيلات Matryoshka بالطريقة الصحيحة
تمثيلات Matryoshka كتخليك تقصّر المتجه الكامل لواحد من الأبعاد اللي كيدعمها الموديل المختار. قصّ المحور الأخير ومن بعد عاود طبّق التطبيع على المتجه القصير:
embedding = torch.nn.functional.normalize(
    embedding[..., :d],
    dim=-1
)
عيّن d غير لبُعد موجود فاللائحة ديال الموديل ديالك. خطوة التطبيع الثانية مهمة حيث القص كيبدّل معيار المتجه. ملي كتستعمل أمثلة سطر الأوامر المرفقة، اختار بُعد Matryoshka المطلوب باستعمال --dimension.
تشغيل الموديل باستعمال vLLM
المستودع كيشير إلى أنه تجرّب مع vLLM 0.27.0. شغّل خادم التجميع ووفّر قالب المحادثة الخاص بتمثيل الموديل:
MODEL_PATH=/path/to/WeMM-Embedding-2B
vllm serve "$MODEL_PATH" \
  --runner pooling \
  --chat-template "$MODEL_PATH/embedding_chat_template.jinja"
كاين تغليف مكافئ فـ scripts/serve_vllm.sh.
تشغيل الموديل باستعمال SGLang
الإصدار اللي تجرّب عليه المشروع ووثّقو هو SGLang 0.5.9. طبّق رقعة الفيديو المرفقة قبل ما تطلق خادم التمثيل:
MODEL_PATH=/path/to/WeMM-Embedding-2B
python scripts/patch_sglang_video.py
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --is-embedding \
  --enable-precise-embedding-interpolation
الريپوزيتوري كيوفّر حتى scripts/serve_sglang.sh كغلاف كيشغّل الأمر كامل فمرة وحدة.
شغّل تقييم MMEB-v3
الدوسي mmeb_v3_eval/ فيه كود التقييم اللي تستعمل باش تخرجو النتائج المعلنة ديال MMEB-v3. هاد الكود مبني على البايپلاين الرسمي ديال VLM2Vec، وكايزيد backbone ديال WeMM-Embedding، وتعليمات متناسقة للـdatasets، وinference بالدفعات، وتشغيل multi-node وmulti-GPU، وأخذ عينات من الفيديو بـ64 إطار.
فالأول دخل لدوسي التقييم وحمّل الداتا:
cd mmeb_v3_eval
DATA_ROOT=/path/to/MMEB-V3 bash scripts/download_data.sh
من بعد شغّل التقييم باستعمال المسارات ديال الموديل والـdataset والنتائج:
MODEL_PATH=/path/to/WeMM-Embedding-2B \
DATA_BASEDIR=/path/to/MMEB-V3 \
OUTPUT_DIR=exps/wemm_embedding \
bash scripts/run_eval.sh
رجع لـmmeb_v3_eval/README.md باش تلقى إعداد الداتا والأوامر الموثقة للتشغيل فـnode وحدة ولا فـعدة nodes.
نصائح متقدمة
- وافق الأبعاد مع الموديل: ما تطلبش 2560 بُعد من موديل 2B ولا 4096 بُعد من موديل 4B. استعمل غير الأبعاد المذكورة فالـcheckpoint اللي اخترتي.
- عاود طبّق التطبيع على المتجهات المقتاصّة: إلا قصّرت embedding كاملة بيدك، ديما طبّق L2 normalization من بعد.
- خلّي المعالجة القبلية قابلة لإعادة الإنتاج: استعمل نسخة Transformers الموصى بها ملي كتعيد إنتاج النتائج، حيث المعالجة القبلية تقدر تتبدل بين الإصدارات.
- استعمل طريقة التحميل المناسبة: أمر Transformers الموثق كيستعمل مسار الموديل، بينما مثال Sentence Transformers يقدر حتى يحمّل
tencent/WeMM-Embedding-2Bمباشرة. - خد بعين الاعتبار الصوت غير المدعوم: الموديلات دابا ما كتقبلش الصوت، ونتيجة الصوت المعلنة فـMMEB-v3 هي بالتالي صفر.
- استعمل أغلفة التشغيل باش تسهّل الخدمة: السكريبتات ديال shell فـ
scripts/كاتجمع إعدادات التشغيل الموثقة ديال vLLM وSGLang.
سياق الأداء
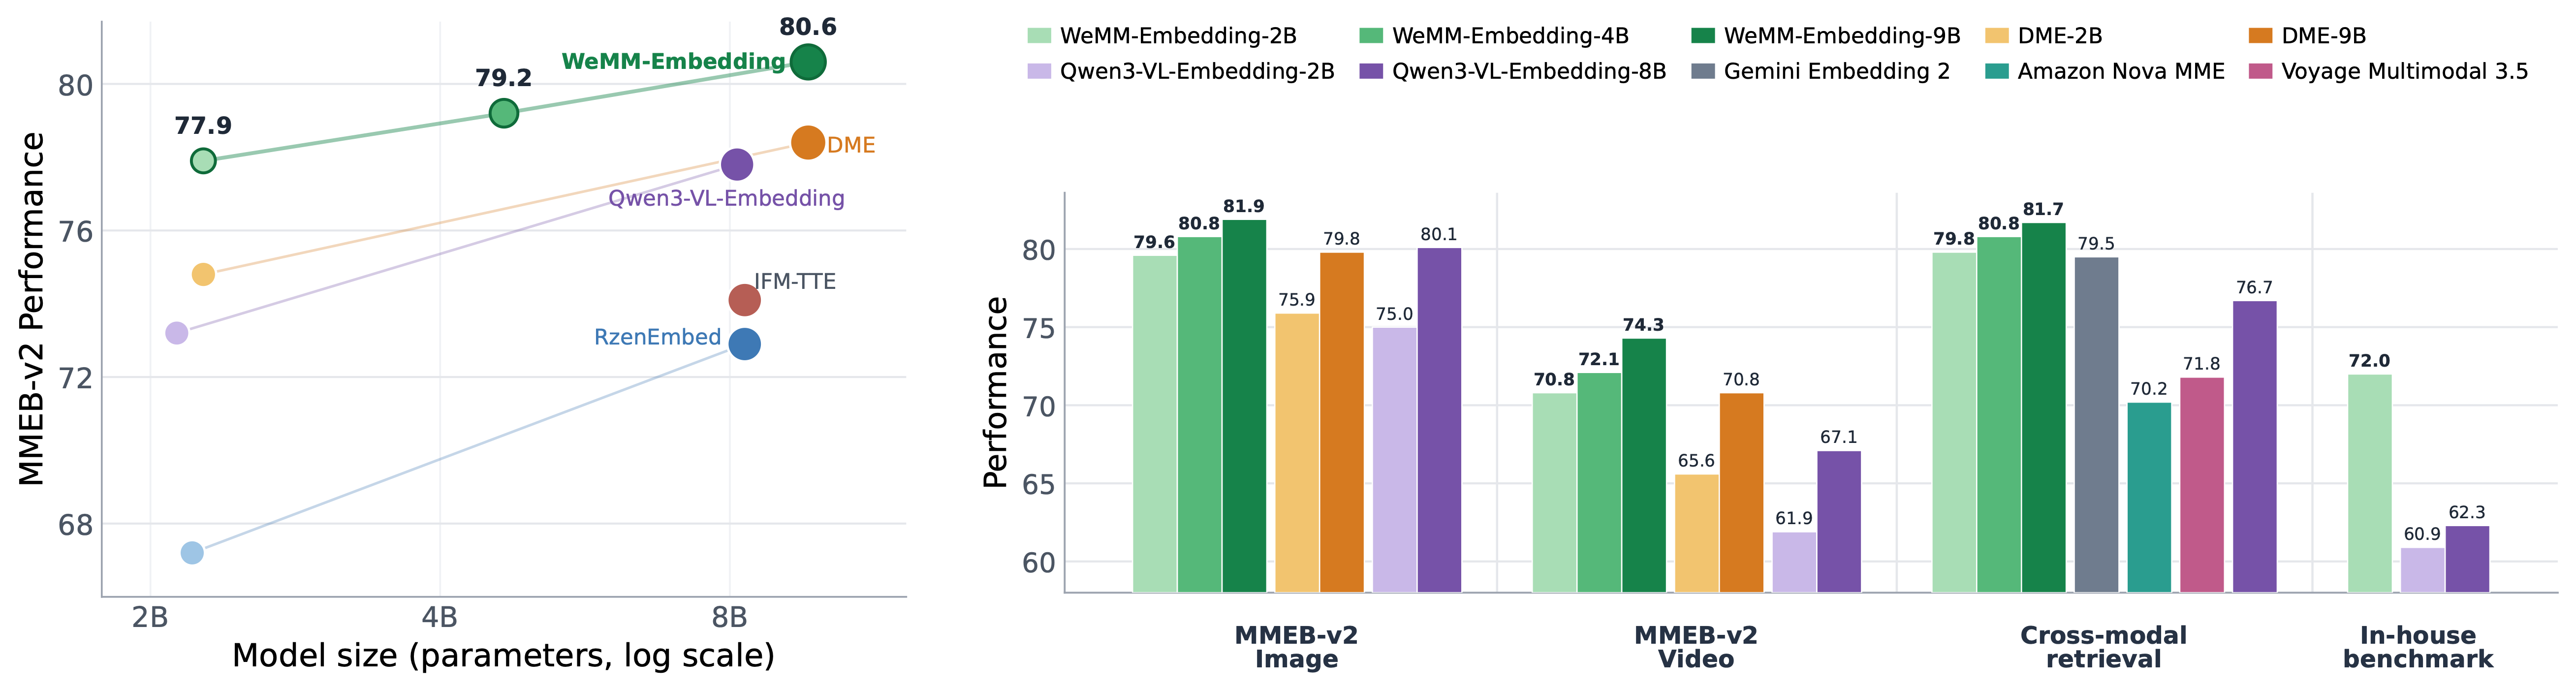
الـREADME كيعرض النتائج عبر 78 dataset ديال MMEB-v2 وكاملين 190 مهمة ديال MMEB-v3. فـMMEB-v2، النسخ 2B و4B و9B جابت متوسط نقاط قدره 77.9 و79.2 و80.6 على التوالي. وفـMMEB-v3، النقاط الإجمالية المعلنة ديالها هي 56.0 و58.2 و59.5. المقاييس كتختلف حسب مجموعة المهام: مهام الصور والفيديو كتستعمل Hit@1، ومهام الوثائق البصرية والنصوص كتستعمل NDCG@5، ومهام الوكلاء وMCMR والصوت كتستعمل Hit@1.
خاص تفسير نقاط الاختبار المعياري مع مراعاة تغطية المهام الموثقة. MMEB-v3 كيعطي نقطة صفر للمهام غير المدعومة، ومن بينها الصوت بالنسبة لـWeMM-Embedding.
الخلاصة
WeMM-Embedding كيوفّر عائلة ديال الموديلات باش تولّد تمثيلات مطبّعة من أنواع مختلفة ديال المدخلات البصرية والنصية. بدا بـcheckpoint ديال 2B ومعاه مثال inference مرفق، واختار بُعد Matryoshka مدعوم ملي كتكون المتجهات المدمجة مفيدة، ومن بعد انتقل لـvLLM ولا SGLang ولا بايبلاين MMEB-v3 ملي تحتاج serving ولا evaluation. كود الريپوزيتوري اللي دارو Tencent منشور تحت رخصة Apache License 2.0 إلا كان مذكور العكس.