

شنو هو DeepInfer-SM80؟
DeepInfer-SM80 هو مجموعة ديال الوحدات المحسّنة بـ Python وTriton وTileLang باش يشغّل DeepSeek-V4.1 على وحدات NVIDIA Ampere الرسومية عبر محرّك vLLM V1. كينقل أفكار أساسية من DeepInfer ديال DeepSeek، اللي موجه لـ NVIDIA Blackwell، وكيعاود يصمّم مسار التنفيذ الحساس اعتماداً على إمكانيات عتاد Ampere.
بلا ما يعتمد على خصائص خاصة بـ Blackwell بحال تعليمات مجموعات الـ warp tcgen05، وTensor Memory، وتعليمات العتاد لتحجيم UE8M0، و228 KB ديال الذاكرة المشتركة لكل معالج متعدد التدفقات، كيستعمل المشروع Tensor Cores ديال Ampere من نوع mma.sync.aligned.m16n8k16، وجدولة واعية بـ SM، وفك ترميز UE8M0 باستعمال الإزاحة بالبتات الصحيحة، وإعادة استعمال YOCO للـ KV المشترك.
كيدعم المشروع وحدات SM80 الخاصة بمراكز البيانات بحال A100 وA800، وزيد عليها أجهزة SM86 بحال RTX 3090 وRTX 3090 Ti وRTX A6000 وA40 وA10 وA30. الكيرنلات ديالو ما كتستعملش أكثر من 48 KB ديال الذاكرة المشتركة لكل CTA، وهاد الشي كيخليها خدامة ضمن الحدود الأقل ديال الذاكرة المشتركة فـ أجهزة SM86.
علاش تستعملو؟
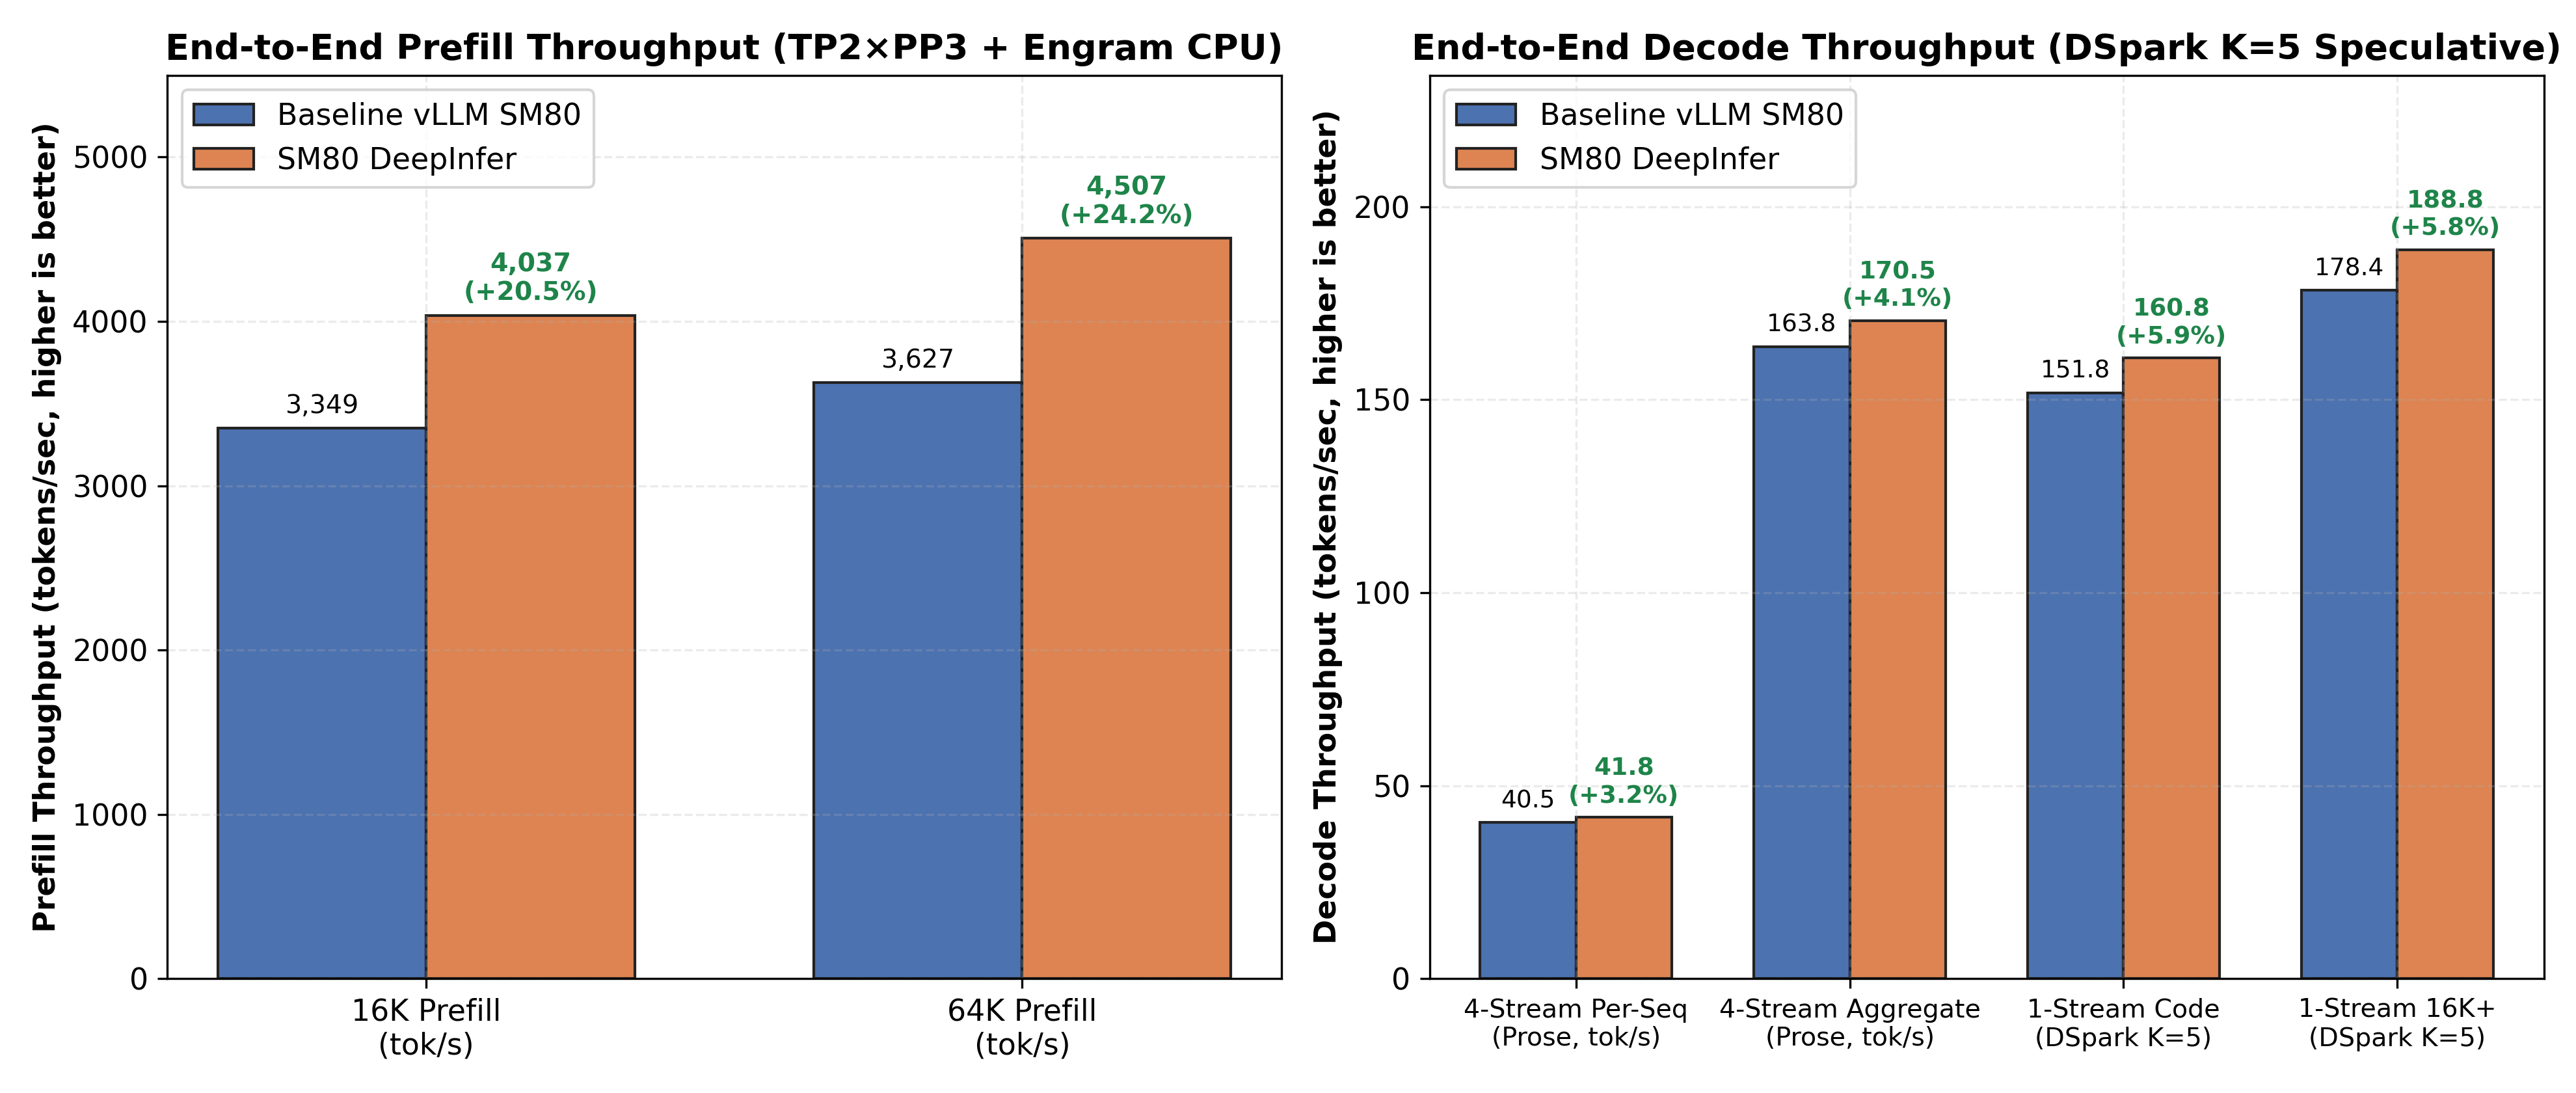
DeepInfer-SM80 مركز على العمليات المكلفة المرتابطة بمرحلة prefill ديال DeepSeek-V4.1، والانتباه المتناثر، والوصول لذاكرة KV المؤقتة، وتوجيه البقايا، والاستدلال بسياق طويل. المستودع كيذكر النتائج التالية من إعداد إنتاجي كيستعمل ست وحدات GA100 بسعة 64 GB، وTP2 × PP3، وفك ترميز تخميني DSpark بـ K=5، وأقصى طول للسياق قدره 1,048,576 رمز:
- تهيئة باردة لـ 16K: 4,037.0 رمز فالثانية، بعدما كانت 3,349.4 رمز فالثانية.
- تهيئة باردة لـ 64K: 4,506.8 رمز فالثانية، بعدما كانت 3,627.3 رمز فالثانية.
- المدة حتى أول رمز فـ 64K: 10.7 ثانية، بعدما كانت 13.2 ثانية.
- فك ترميز تخميني بأربعة تدفقات: 170.5 رمز فالثانية كمجموع، مقارنةً بـ 163.8 رمز فالثانية.
- فك ترميز بتدفق واحد باستعمال كود Python: 160.8 رمز فالثانية، مقارنةً بـ 151.8 رمز فالثانية.
- سعة KV المقيمة فـ GPU: 4,648,480 رمز، بلا زيادة إضافية فاستعمال VRAM مقارنةً بالخط الأساسي.
هاد القياسات كتصف العتاد وإعداد الخدمة اللي تجرّبو فالمستودع. النتائج على وحدات Ampere أخرى، أو إعدادات أخرى للنموذج، أو أعباء عمل مختلفة، أو بيئات vLLM مختلفة، تقدر تكون مغايرة.
أهم التحسينات
ـ MLA متناثر موحّد بـ 512 بُعد
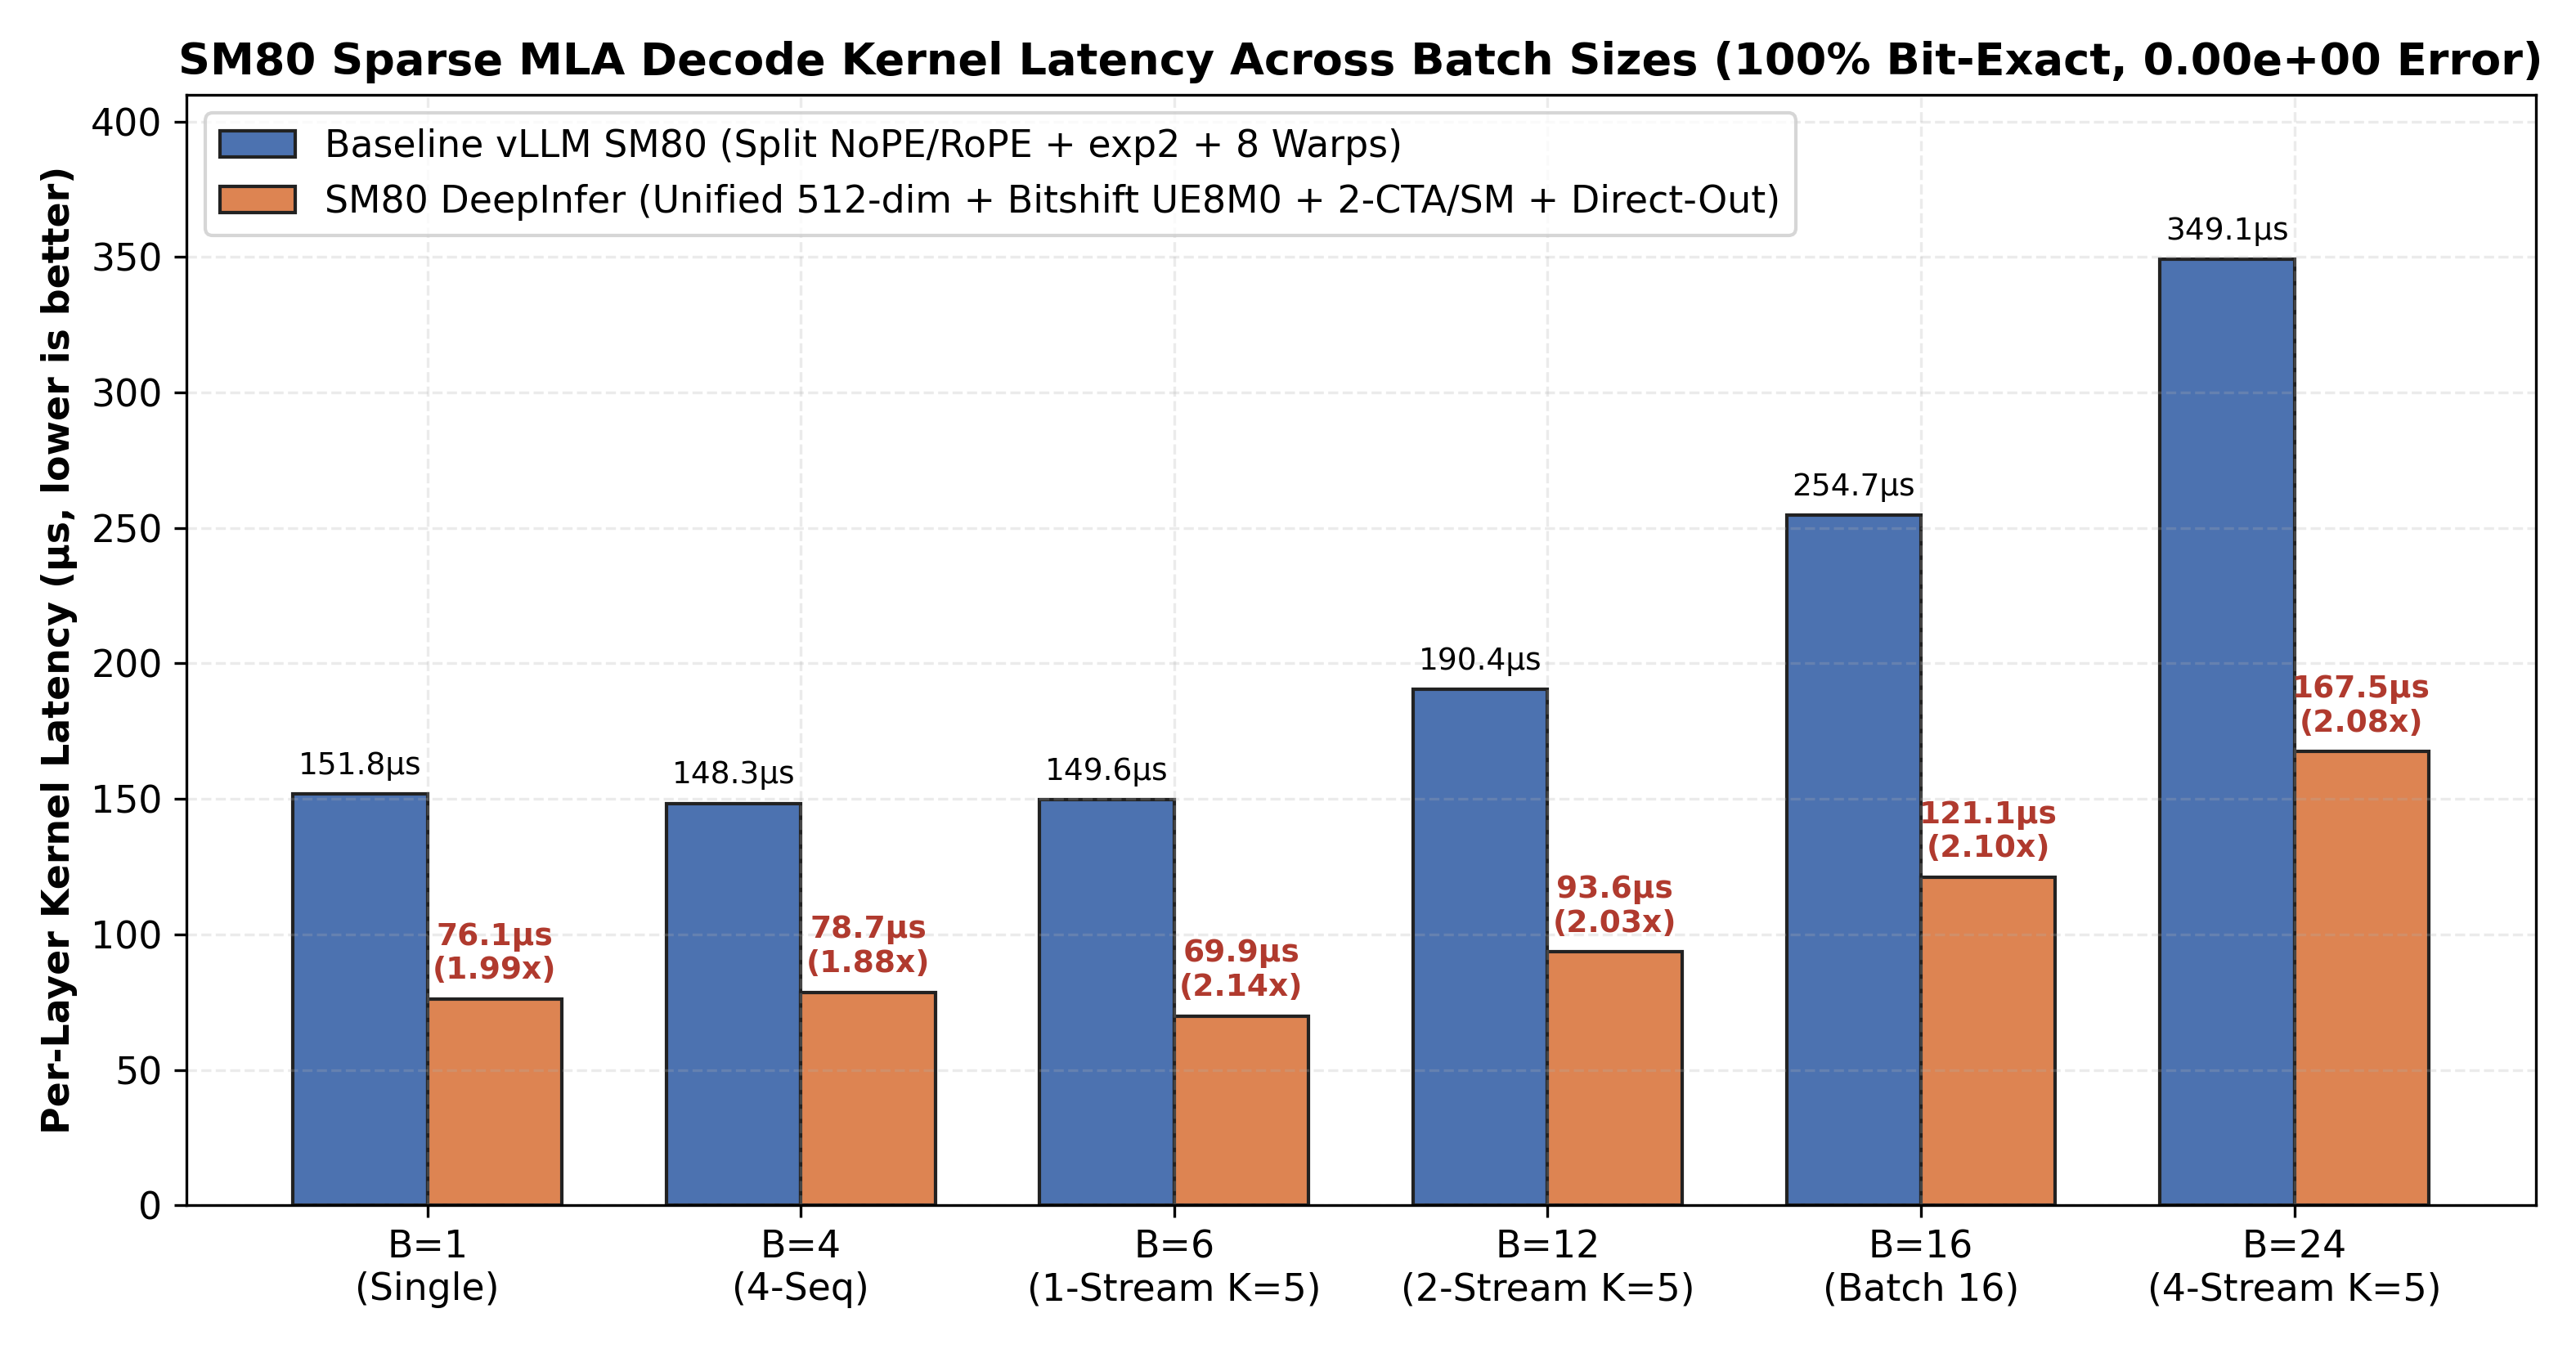
الانتباه المتناثر DeepSelect ديال DeepSeek-V4.1 كيخزّن latent NoPE بـ 448 بُعد بصيغة float8_e4m3fn، باستعمال مقاييس كتل بقوة اثنين من نوع UE8M0، مع لاحقة RoPE بـ 64 بُعد بصيغة BF16. DeepInfer-SM80 كيحمّل tile كامل بـ 512 بُعد وكيعالجو عبر مسار واحد للضرب النقطي بـ Tensor Core، عوض ما يعالج أجزاء NoPE وRoPE بشكل منفصل.
الكيرنل كيبدّل تحويل UE8M0 المبني على exp2 بإزاحة صحيحة وفق IEEE-754:
(scale_u8.to(tl.int32) << 23).to(tl.float32, bitcast=True)بالنسبة للأسس الصحيحة ديال UE8M0، هاد الشي كينتج قيم مقياس FP32 مطابقة للبتات، وكيحوّل الخدمة من عمليات متسامية لمسار الأعداد الصحيحة.
الإعداد المضبوط كيستعمل BLOCK_N=64 وnum_warps=4 وnum_stages=2. تقليل الضغط على السجلات كيخلي جوج CTAs يستاقرو فكل معالج متعدد التدفقات SM80. ملي كيكون num_kv_splits == 1، الكيرنل كيكتب مباشرة فالناتج النهائي وكيجنب إطلاق مرحلة اختزال منفصلة.
دمج Top-K وSWA فمؤشر CTA واحد
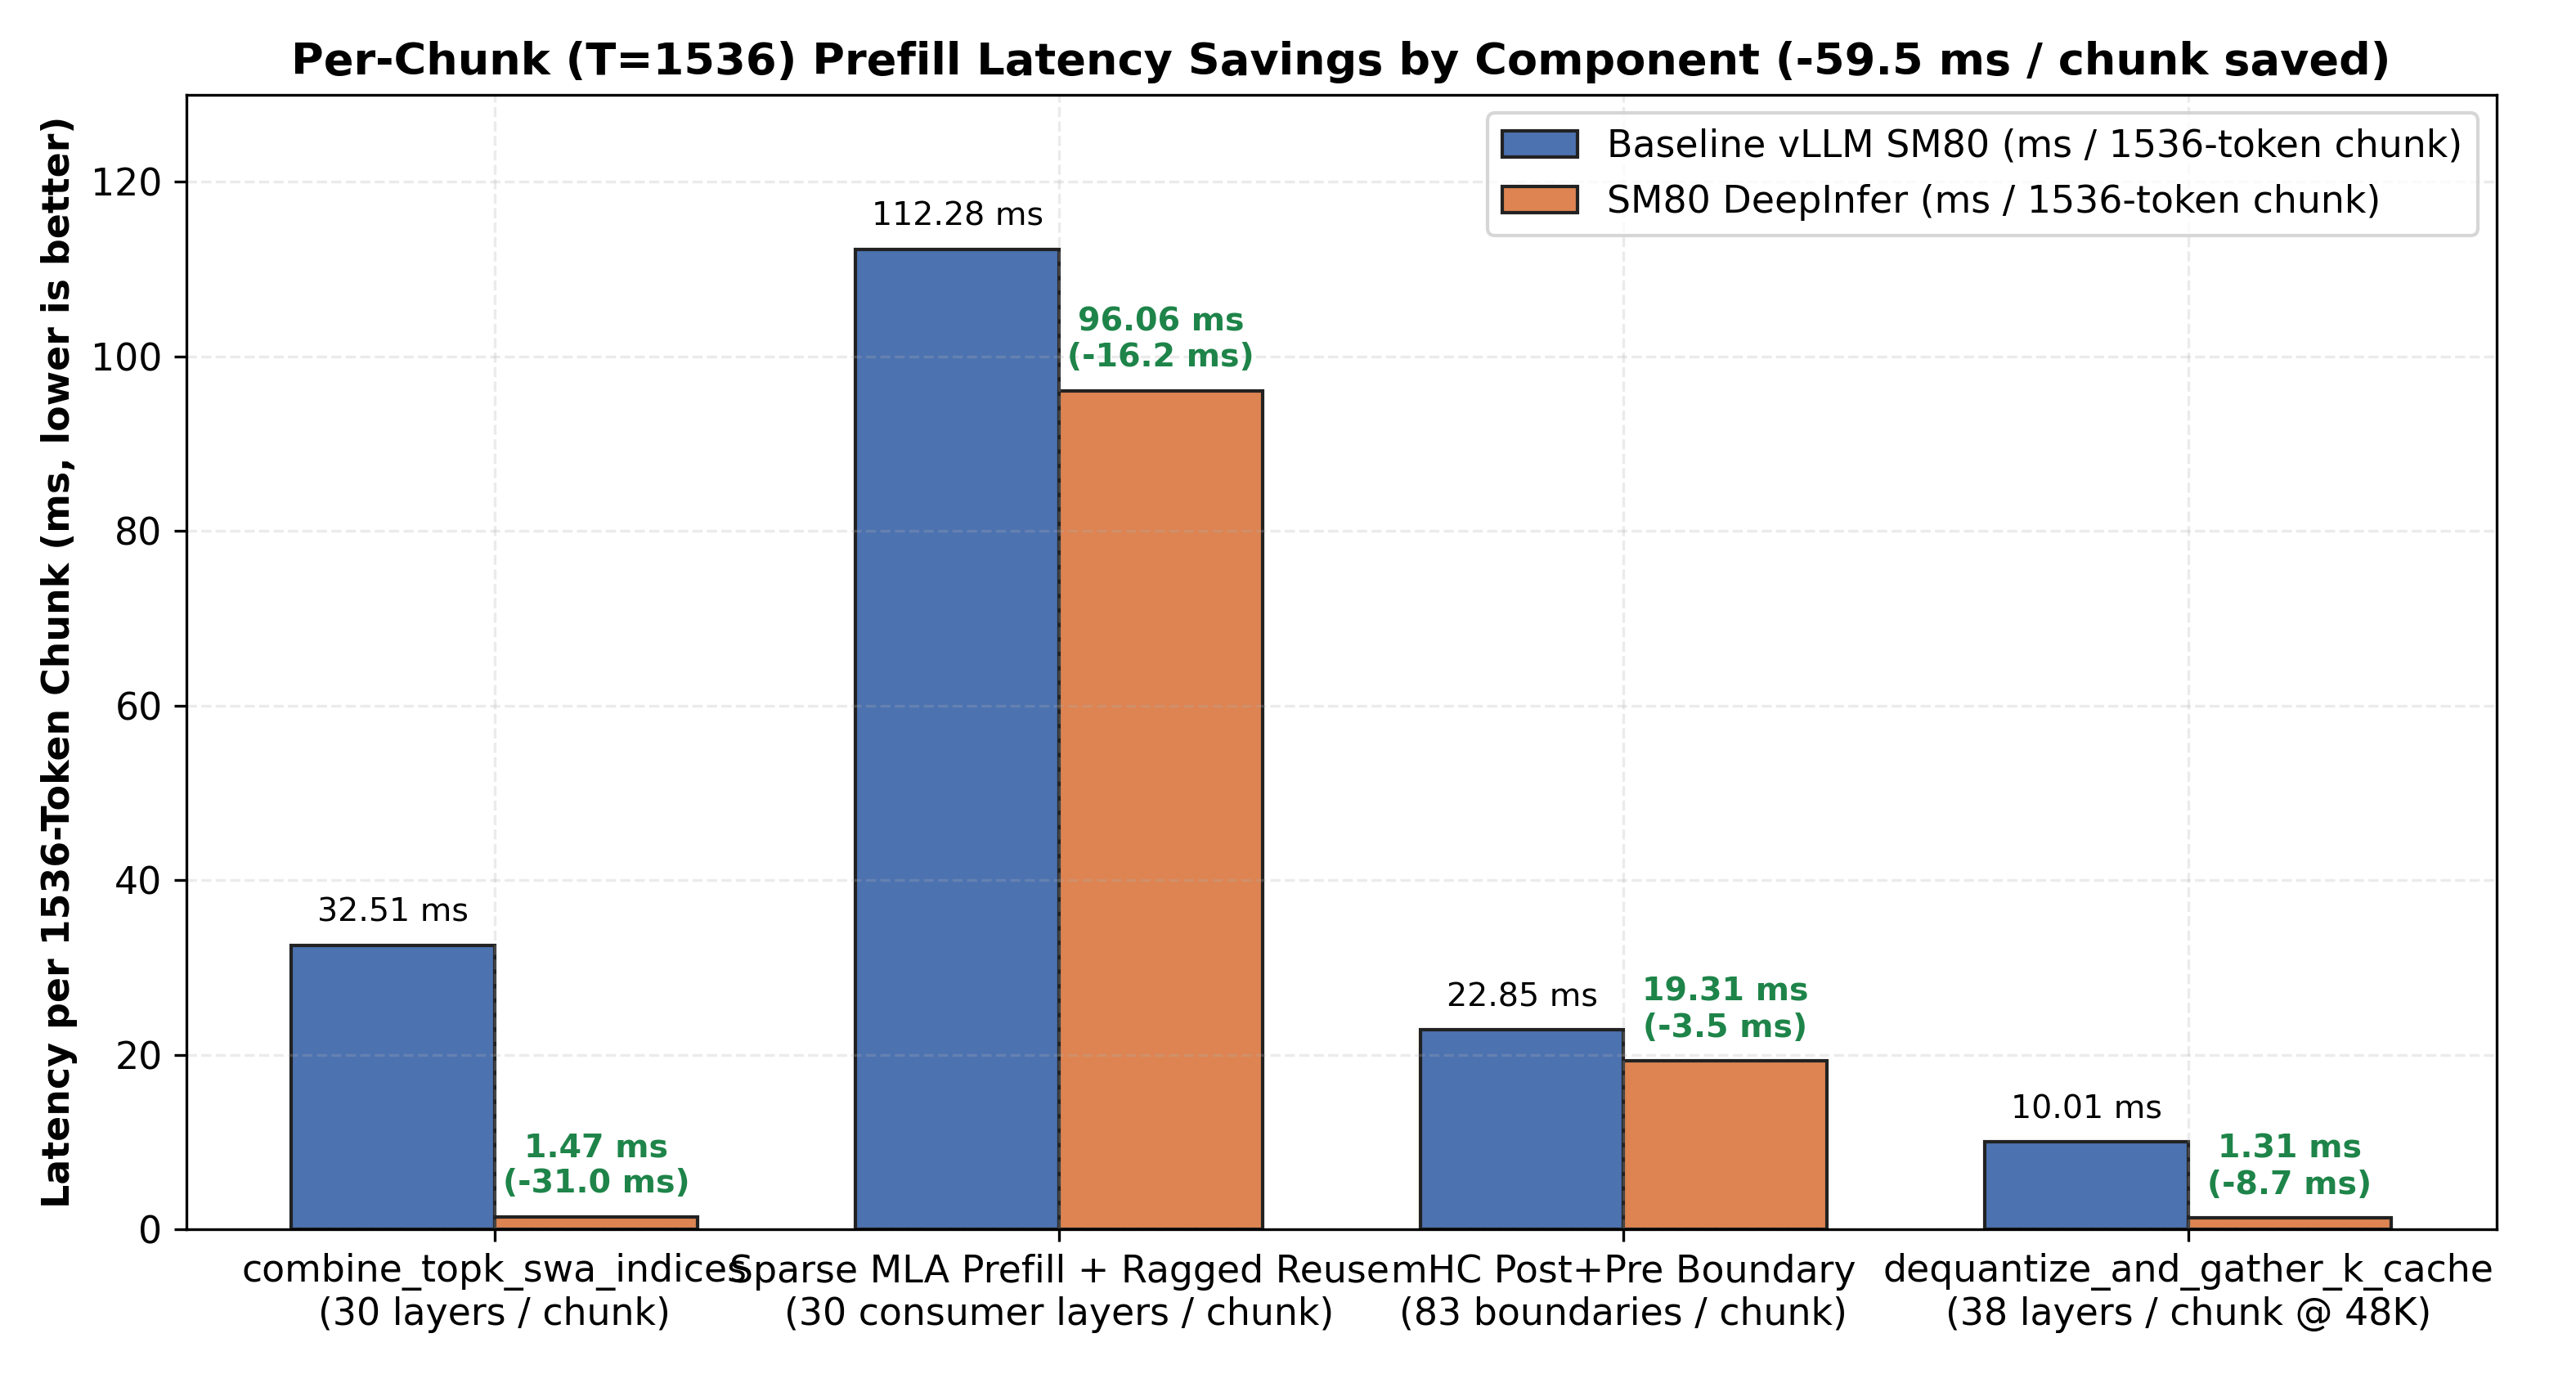
الكيرنل المحسّن _combine_topk_swa_indices_kernel كيبدّل سلسلة ديال عمليات وتخصيصات PyTorch بكيرنل واحد ديال Triton كيستعمل CTA واحد لكل رمز استعلام. عند T=1536، كتهبط مدة الاستجابة المقاسة من 1,083.72 ميكروثانية لـ 48.88 ميكروثانية، يعني تسريع بـ 22.17×.
باش يتفادى تعارضات الكتابة بين الـ warps، كل صف ديال الناتج كيتقسم لثلاث مناطق منفصلة:
- مؤشرات Top-K المضغوطة كتاخذ
[0, topk_len). - مؤشرات الانتباه بالنافذة المنزلقة كتاخذ
[topk_len, topk_len + swa_len). - الأعمدة الباقية كتتعمر بـ
-1.
الـ README كيذكر أن الناتج مطابق للبتات فكل أطوال السلاسل ونسب الضغط المجرّبة 0 و1 و2.
فك أسرع لتكميم ذاكرة KV المؤقتة وتجميعها
المسار dequantize_and_gather_k_cache كيستعمل نفس تحويل UE8M0 المبني على الإزاحة بالبتات. وكيكتب كذلك باستعمال strides ديال الوجهة اللي كيتعطاو لكيرنل Triton، وكيحيد تخصيصات torch.empty الوسيطة وعمليات .copy_() اللي كتجي من بعدها.
التسريع المقاس هو 4.02× مع سياق بـ 16K و7.64× مع سياق بـ 48K، مع نتائج مرجعية مطابقة للبتات فالاختبارات المذكورة.
توجيه بقايا mHC مضبوط لـ SM80
DeepSeek-V4.1 كيدير توجيه hyper-connection مقيّد بالمتشعبات بأربعة تدفقات فـ 83 حدّ خلال كل مرور أمامي. DeepInfer-SM80 كيزيد هندسة تقسيم متراصفة (6, 8, 128) لحجم خفي ديال النموذج قدره 5,120. كل واحد من الشرائح الثمانية فيه 640 عنصر، وهو عدد قابل للقسمة على 128.
المشروع كيهبط كذلك عتبة المصفوفات الصغيرة من 32 لـ 16، باش تقدر أعداد الرموز اللي كتساوي 16 أو أكثر تستعمل مسار Tensor Core T.gemm. التسريع المذكور لـ mhc_fused_post_pre_delayed هو 2.89× عند T=12 و1.30× عند T=6.
إعادة استعمال بيانات YOCO الوصفية
فمعمارية You-Only-Cache-Once ديال DeepSeek-V4.1، الطبقات من 21 حتى لـ39 كيقراو من KV cache كامل الدقة ديال الطبقة 20. هاد المستهلكين كيتشاركو نفس أطوال السلسلة الموسّعة، ونفس جدول الكتل، ونفس نسبة الضغط.
DeepInfer-SM80 كيخزّن الميتاداتا غير المنتظمة ديال K فـ vLLM forward context ملي كيعالج الطبقة 20. إعادة استعمال هاد المعطيات فالطبقات من 21 حتى لـ39 كتحيد 19 سلسلة زائدة ديال GPU kernels لبناء الميتاداتا فكل prefill chunk.
قبل التثبيت
خاصك بيئة vLLM V1 اللي غادي تشغّل DeepSeek-V4.1 فوق NVIDIA Ampere GPU مدعومة. المستودع كيوفّر patch موحّد وست وحدات بديلة، ولكن README ما كيحدّدش أرقام دقيقة لإصدارات CUDA أو Python أو Triton أو TileLang أو vLLM. استعمل checkout ديال vLLM متوافق مع الـpatch ومع نشر DeepSeek-V4.1 الموجود عندك.
مجموعات العتاد المدعومة هي:
- GPU ديال مراكز البيانات SM80: A100 40 GB، وA100 80 GB، وGA100 64 GB، وA800 40 GB أو 80 GB.
- GPU ديال محطات العمل والمستهلكين SM86: RTX 3090، وRTX 3090 Ti، وRTX A6000، وA40، وA10، وA30.
البرنامج موزّع بموجب Apache License 2.0.
طريقة التثبيت A: طبّق الـPatch الموحّد
هاد الطريقة كتطبّق الملفات الستة المعدّلة على checkout ديال مصدر vLLM. حلّ terminal فالمجلد الجذر ديال داك checkout ونفّذ:
git apply /path/to/Deepinfer-SM80/patches/vllm-sm80-deepinfer.patchبدّل /path/to/Deepinfer-SM80 بالمكان ديال المشروع اللي تـclone أو تـdownload. الـpatch فيه تغييرات sparse MLA، وcache-gather، وTop-K مع SWA، وmHC، وwarmup، وإعادة استعمال ميتاداتا YOCO.
طريقة التثبيت B: ثبّت الوحدات البديلة Drop-In
إلى كان تبديل الملفات مباشرة أنسب للبيئة ديالك، نسخ شجرة وحدات vLLM ديال المشروع فوق حزمة vLLM المثبّتة:
cp -r vllm_sm80_deepinfer/vllm/* /path/to/site-packages/vllm/بدّل /path/to/site-packages/vllm/ بمجلد حزمة vLLM الفعلي. ونفس الملفات يمكن حتى تـbind-mountاها كـread-only overlays فـDocker deployment.
الشجرة البديلة كتعدّل هاد المجالات الوظيفية:
model_executor/kernels/mhc/لتنفيذ mHC بـTileLang والـwarmup.models/deepseek_v4_1/amd/rocm.pyباش يخدم Triton Top-K وSWA combiner.models/deepseek_v4_1/common/ops/cache_utils.pyلجمع KV-cache.models/deepseek_v4_1/nvidia/model.pyلإعادة استعمال ميتاداتا YOCO.v1/attention/ops/rocm_aiter_mla_sparse.pyمن أجل unified sparse MLA kernels.
رغم أن جوج ملفات محسّنة باقيين محتافظين بـ
rocmأوamdفالمسارات ديالهم، المستودع كيستعملهم صراحة كجزء من تكامل vLLM الموجّه لـAmpere. حافظ على بنية المجلدات اللي موفّرة ملي كتطبّق الملفات البديلة.
الاستعمال الأساسي: تحقّق من الـKernels
من بعد ما تثبّت الـpatch أو الوحدات البديلة، شغّل الـmicrobenchmarks المعزولة الموفّرة فوق A100 أو A800 أو RTX 3090 أو RTX A6000 أو أي Ampere GPU مدعومة:
python3 benchmarks/microbench_sm80_kernels.py
python3 benchmarks/microbench_sm80_part2.py
python3 benchmarks/microbench_sm80_part3.py
ملفات benchmark كغطّيو sparse MLA وKV-gather kernels، وTileLang mHC kernels، وTop-K مع SWA combiner. الهدف ديالهم هو قياس زمن الاستجابة المحلي ديال الـkernel والتحقّق من المخرجات المحسّنة بمقارنتها مع المراجع الأساسية.
ولّد رسوم benchmark ديال المستودع بهاد الأمر:
python3 benchmarks/generate_charts.pyمجموعة بيانات benchmark الكاملة متوفّرة حتى فـbenchmarks/results/sm80_benchmark_summary.json.
فهم التحقّق العددي
كاينين عدة مسارات محسّنة مبلّغ عليها على أنها مطابقة على مستوى البِت:
_combine_topk_swa_indices_kerneldequantize_and_gather_k_cache_sparse_attn_decode_kernelmhc_post_with_sqrsum
مسارات أخرى ديال Tensor Core يمكن تختلف شوية حيث كيوقع تغيير فـBF16 accumulation أو فترتيب تنفيذ MMA. الفروقات القصوى المبلّغ عليها بقات أقل من 1.9e-3 فإعدادات mHC المدمجة المقاسة، وأقل من 4.8e-3 فإعداد sparse-attention prefill المقاس.
نتائج negative log-likelihood ديال prompt-logprob بقات داخل مستوى الضجيج المبلّغ عليه بين تشغيل وآخر. ملي كتقيّم deployment، فحص الأداء والمخرجات العددية بجوج، وما تفترضش أن كل operator محسّن خاصو يكون مطابق على مستوى البِت.
نصائح متقدمة للنشر
استعمل TP2 × PP3 لتخطيط الإنتاج المجرّب ديال ستة GPU
بالنسبة لستة GPU ديال Ampere بسعة 64 GB أو 80 GB، المستودع كيوصي بـTP2 × PP3 مع تقسيم طبقات 14,14,12. فالإعداد المجرّب، هاد الترتيب عطى من 160.8 حتى لـ188.8 token فالثانية فحالات code ذات stream واحد وأحمال التوليد الطويلة، و4,506.8 token فالثانية فـ64K cold prefill، وسعة تقريباً 4.65 مليون GPU-resident KV token.
هاد السعة كتوافق تقريباً 4.43 سياق ديال مليون token واحد فإعداد benchmark.
فهم البدائل
- PP6: كيوفّر تقريباً من 4.5 حتى لـ4.7 مليون token من السعة، ولكن README كيشير لسرعة أبطأ بزاف فـsingle-stream decode حيث tensor parallelism هو واحد والطلبات كتدوز عبر ست مراحل ديال pipeline.
- Asymmetric TP2 plus TP4: كيزيد السعة المقدّرة تقريباً لستة ملايين token، ولكن تقسيم MoE intermediate size ديال 2,304 إلى partitions ديال TP4 بعرض 576 كيضرّ بكفاءة Marlin tile.
شاور على docs/05_TOPOLOGY_1M_CONTEXT_ANALYSIS_SM80.md فالريبو قبل ما تختار التوبولوجيا ديال نشر بمليون توكن.
قيّس الخدمة الفعلية
أكبر المكاسب كيجيو من العمليات اللي كتتعاود بزاف، ولكن التحسّن من البداية للنهاية كيعتمد على طول البرومبت، والتزامن، وفكّ الترميز التوقّعي، والتوبولوجيا، وموديل الـGPU. دير البنشماركات المعزولة اللولة، ومن بعد قارن خدمات كاملة بنفس البرومبتات، وأحجام السياق، ومستويات التزامن اللي كيتستعملو فالتطبيق ديالك فالإنتاج.
خلي المسار السريع ديال الإخراج المباشر خدام
تحسين فكّ الترميز ديال MLA المتناثر كيتجاوز إطلاق اختزال ثاني ملي num_kv_splits == 1. إلا بدّلتي جدولة الانتباه ولا سلوك التقسيم، عاود قيّس الكيرنل، حيث مسار الإخراج المباشر جزء مهم من التحسّن المعلن ففكّ الترميز.
خلي ميتاداتا YOCO فالسياق الأمامي
كاش الميتاداتا ديال الطبقة 20 مهم حيث جميع المستهلكين ديال الطبقات 21–39 كيتقاسمو نفس مصدر KV. التغييرات فتنفيذ الموديل ولا فالتعامل مع السياق الأمامي خاصها تحافظ على هاد الاستعمال المشترك؛ وإلا يقدر المحرك يعاود يبني نفس الميتاداتا المتعرّجة لكل طبقة مستهلكة.
الخلاصة
DeepInfer-SM80 كيوفّر مسار مركّز لتسريع DeepSeek-V4.1 على NVIDIA Ampere بلا ما يزيد فاستعمال VRAM ديال KV-cache. التحسينات ديالو كاتجمع بين الانتباه المتناثر المكيّف مع Ampere، وفكّ الترميز ديال bitshift UE8M0، والإخراج المباشر من KV-cache، ودمج Top-K وSWA بلا سباقات، والتوجيه ديال mHC بمحاذاة صحيحة، وإعادة استعمال ميتاداتا YOCO.
بدا بتطبيق الباتش الموحّد ولا بتثبيت الوحدات الستة الجاهزة للتعويض المباشر. شغّل مجموعات الميكروبنشمارك الثلاثة كاملين باش تأكد من الكمون والسلوك العددي فالهاردوير ديالك، ومن بعد قيّم بيئة vLLM المحسّنة باستعمال خدمة الإنتاج الحقيقية ديالك. بالنسبة لنشر بستة ديال الـGPU وسياق ديال مليون توكن، استعمل إعداد TP2 × PP3 اللي تجرّب فالريبو كنقطة المرجع الأساسية.