

شنو هو NamiGPT؟
NamiGPT هو واحد الدليل الأساسي فالنماذج اللغوية الكبيرة، موجّه للمبتدئين اللي كيقراو بالصينية. كيستعمل PyTorch باش يطبّق GPT-2 من الصفر، بلا ما يستعمل وحدات Transformer الجاهزة، وكيقدر يحمّل الأوزان الرسمية المدرّبة مسبقاً ديال OpenAI باش يدير الاستدلال وتوليد النصوص.
المشروع ماشي الهدف الرئيسي ديالو هو سرعة التدريب، ولكن الفهم: النموذج الأساسي كاين فـ gpt2/model.py، والكود فيه أقل من 200 سطر؛ والدرس كيتبع مثال من ثلاث كلمات هو «القط كياكل الحوت»، وكيشرح بالتدريج التقطيع، والمتجهات، ومصفوفة الانتباه، وطريقة التوليد النهائي.
اسم NamiGPT تكريماً لـ nanoGPT ديال Karpathy. وهو كيركّز أكثر على التعليم من الصفر بالصينية، وكيشرح كل خطوة من GPT-2 باستعمال أمثلة صغيرة.
شنو غادي تتعلّم؟
- كيفاش كيحوّل Tokenizer النص إلى token ID.
- كيفاش كيتبناو مدخلات النموذج باستعمال Embedding والترميز الموضعي.
- كيفاش كيتحسبو Self-Attention وMulti-Head Attention.
- شنو الدور ديال الوصلات المتبقية، وLayerNorm، وFFN، ودوال التنشيط.
- كيفاش كيتراكبو بزاف ديال Transformer Block باش يتكوّن GPT-2.
- كيفاش تحمّل الأوزان الرسمية ديال OpenAI فالنموذج المكتوب يدوياً.
- كيفاش تولّد النصوص باستعمال استراتيجيات الجشع، ودرجة الحرارة، وtop-k.
- كيفاش تتحقق بالاختبارات من أن التطبيق المكتوب يدوياً متوافق مع تطبيق HuggingFace.
أهم مميزات المشروع
تطبيق المكوّنات الأساسية من الصفر
NamiGPT ما كيستعملش مباشرة وحدات Transformer الجاهزة. النموذج فيه مكوّنات LayerNorm وAttention وFFN وBlock وGPT، وهاد الشي كيسهّل قراءة كيفاش كدوز البيانات والتنسورات سطر بسطر.
سكريبتات الفصول كتخدم بشكل مستقل
قسم الاستدلال مكوّن من 15 موضوع متدرّج، من بينها tokenizer وEmbedding والترميز الموضعي والانتباه الذاتي والانتباه متعدد الرؤوس والوصلات المتبقية وتطبيع الطبقة والشبكة الأمامية ودوال التنشيط وTransformer Block والتراصّ وتحميل الأوزان وتوليد النصوص وقابلية التفسير. كل موضوع تعليمي مرفوق بسكريبت قابل للتشغيل.
تصوير تفاعلي
المشروع كيوفّر رسوماً متحركة لبنية Transformer وتصويراً كاملاً لمصفوفات الاستدلال. ملي كيكون فهم الكود أو الصيغ صعيب، تقدر تشوف كيفاش كيتحسبو عناصر المصفوفة خانة بخانة فمثال «القط كياكل الحوت».
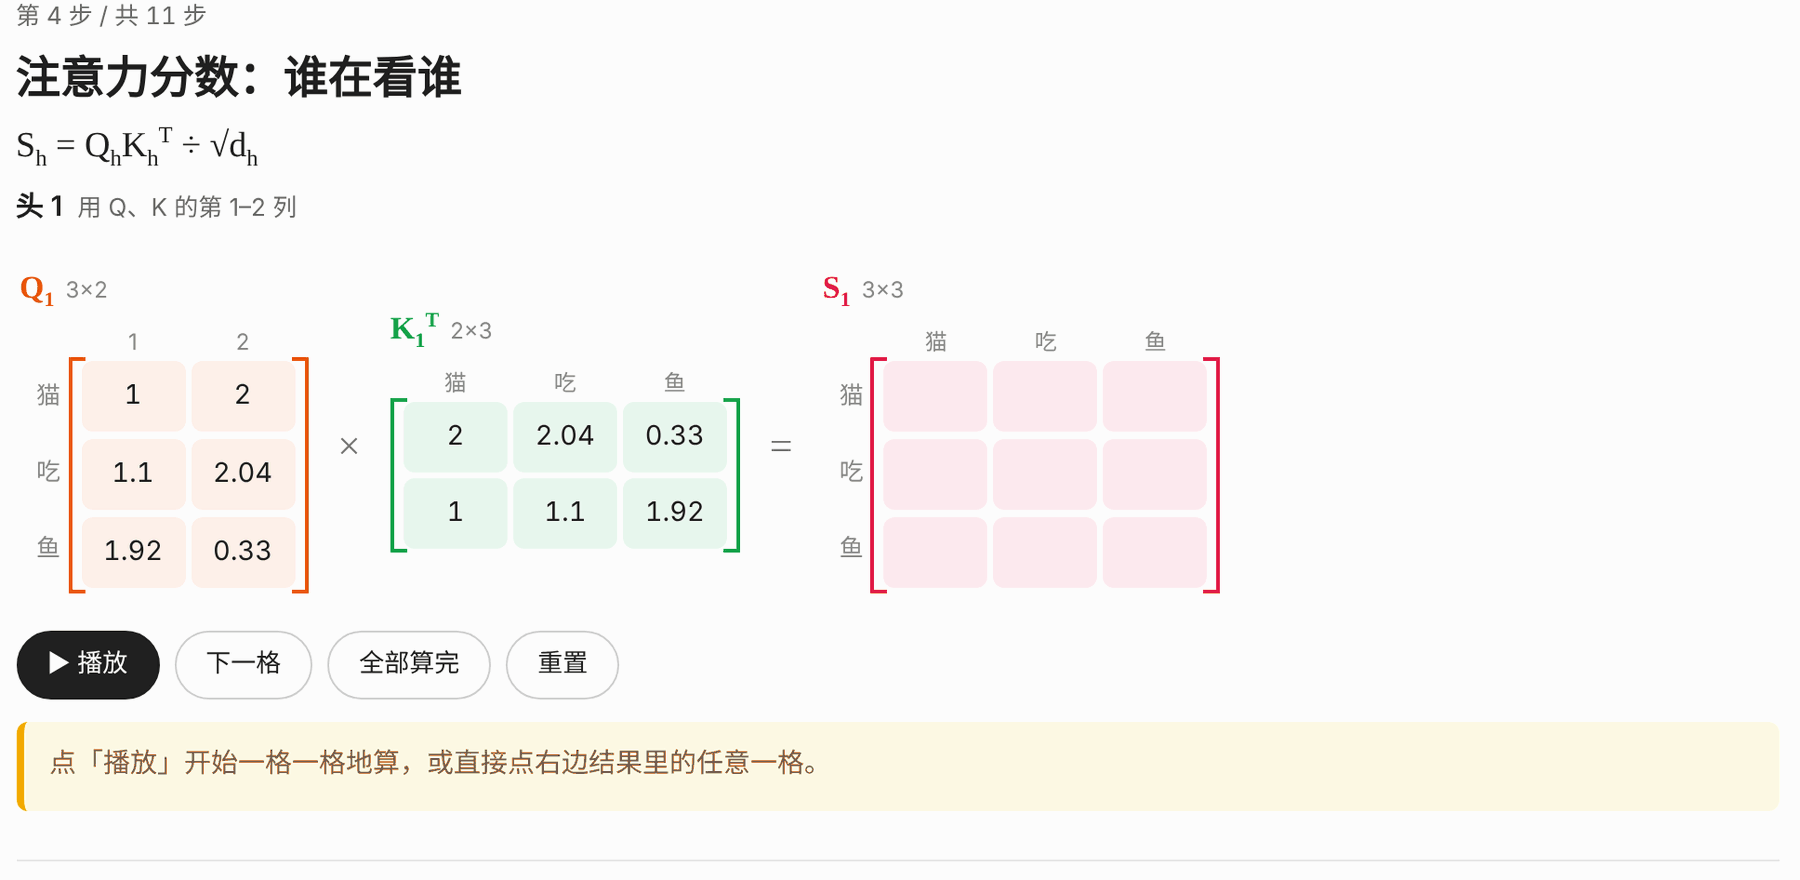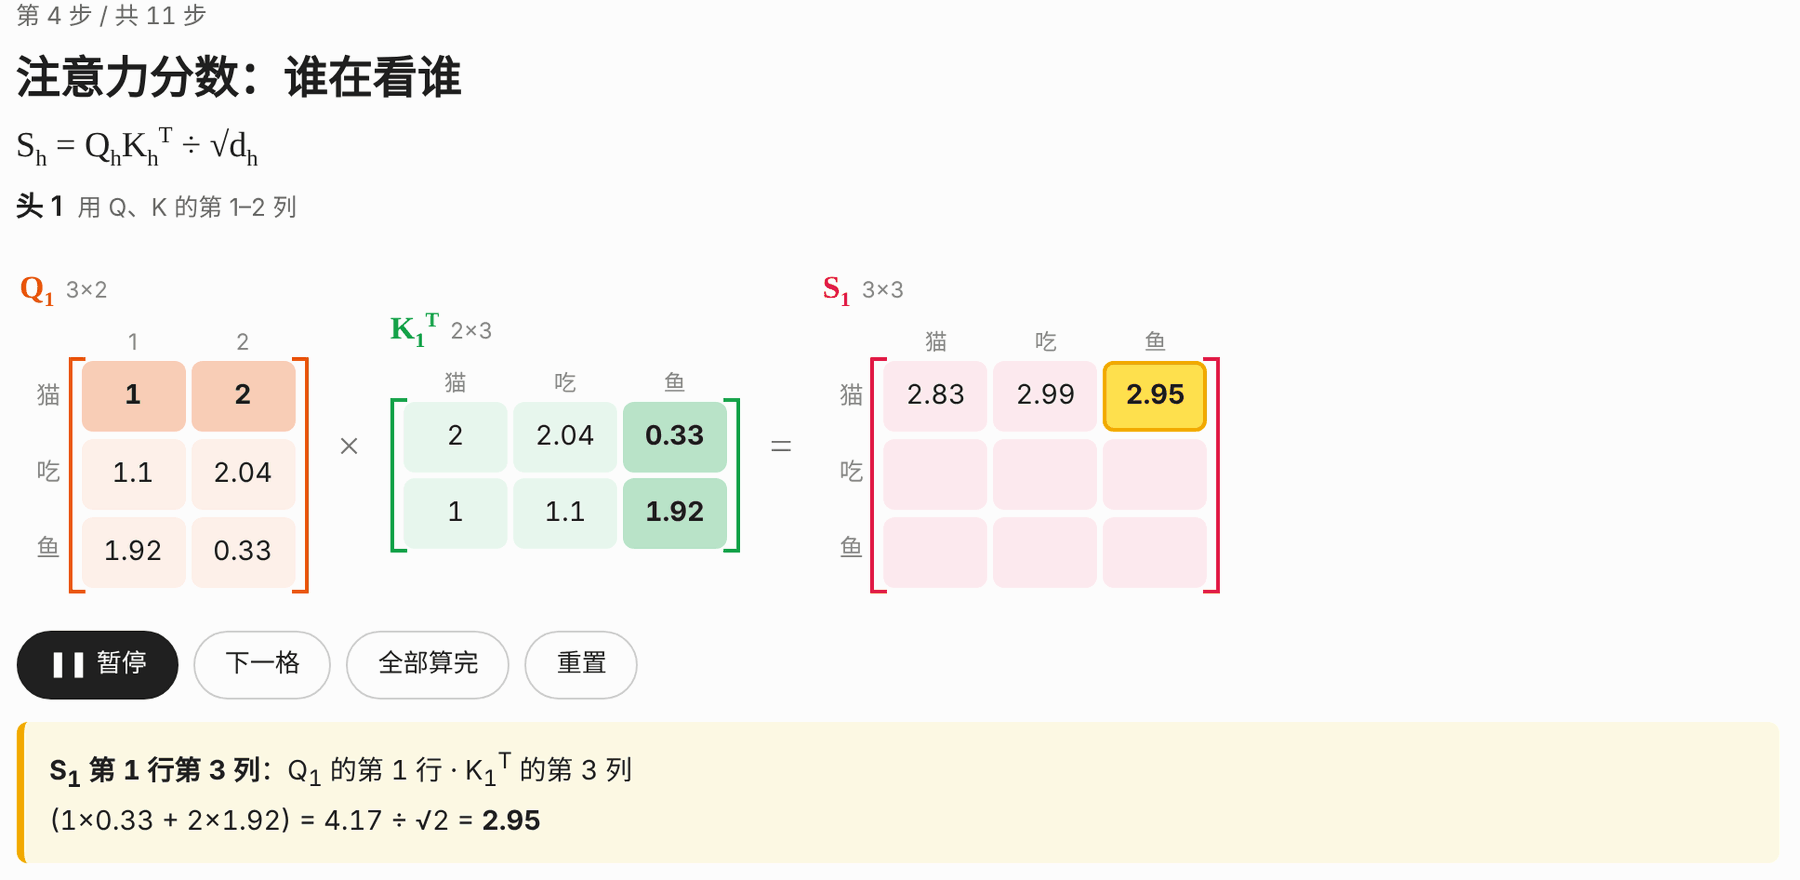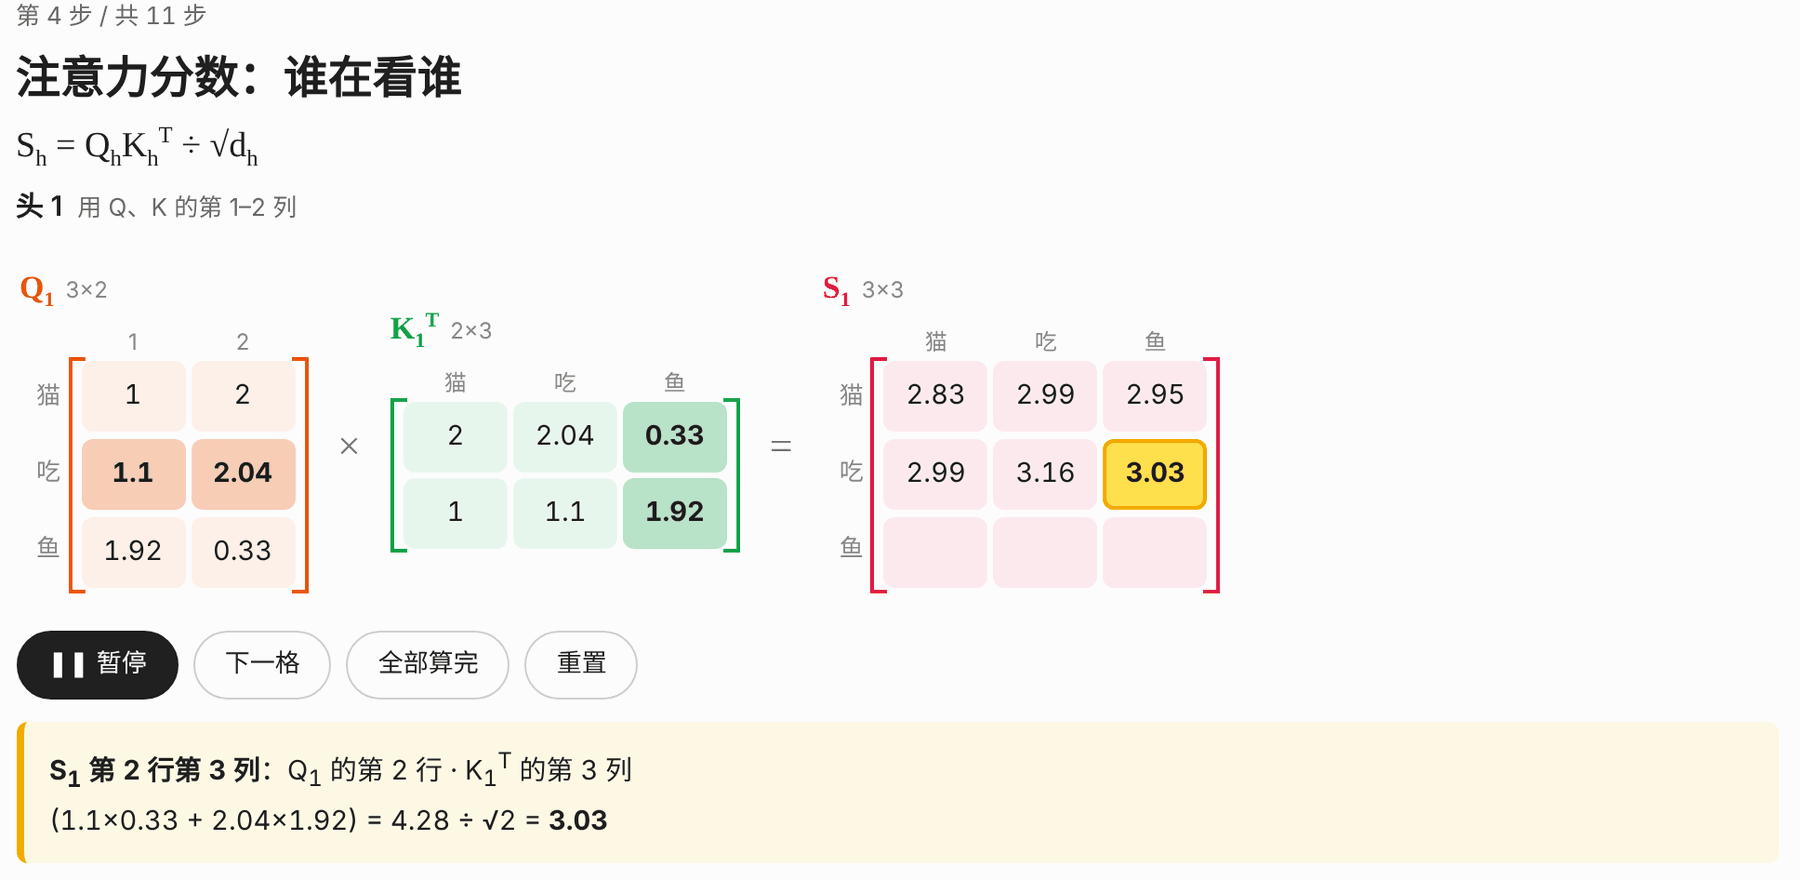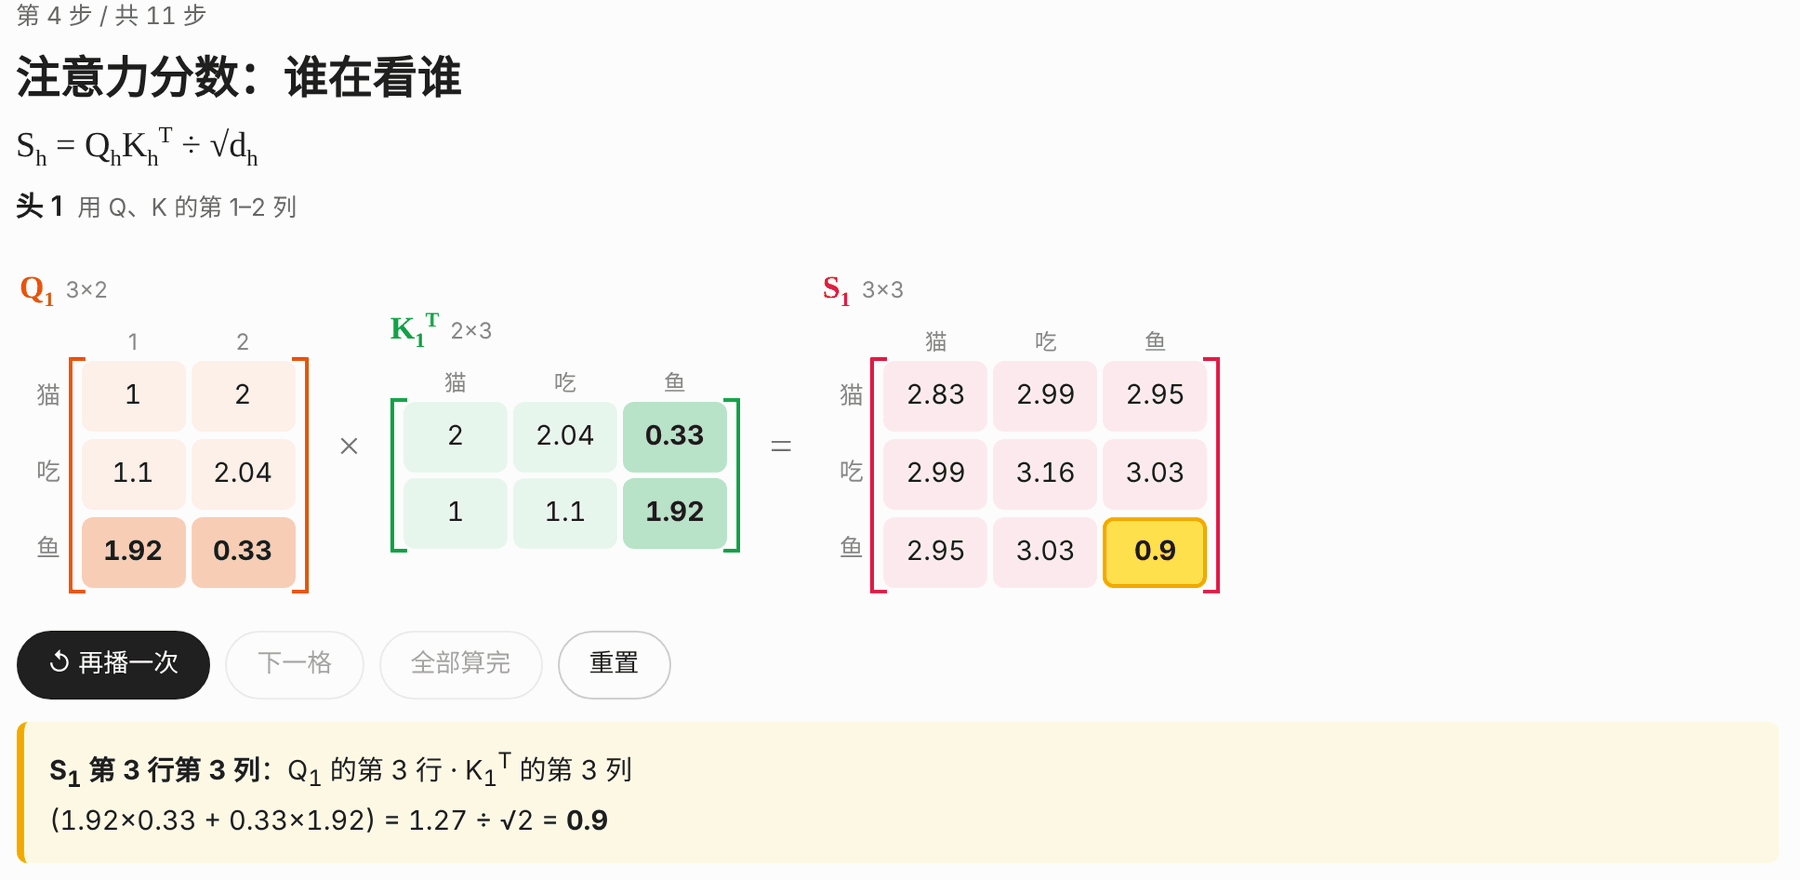
من الأحسن تبدا بـفهم Transformer فصورة وحدة، ومن بعد تستعملالتصوير المرئي لاستدلال النماذج الكبيرة باش تقارن مع كود الفصول.
مطابقة النتائج مع HuggingFace
المستودع فيه فحوصات للأشكال واختبارات للمطابقة مع التطبيق الرسمي ديال HuggingFace. بالإضافة للمقارنة السريعة باستعمال أوزان عشوائية، تقدر حتى تحمّل أوزان GPT-2 الحقيقية وتدير تحقق إضافي.
التحضير قبل التثبيت
قبل ما تبدا، خاص تكون عندك قدرة أساسية على قراءة Python، وتكون فاهم مفاهيم الجبر الخطي الأساسية بحال ضرب المصفوفات. البيئة المحددة للمشروع هي Python 3.9 أو إصدار أحدث وPyTorch 2.x.
أولاً كلونِي المستودع، دخل لمجلد المشروع وثبّت الاعتماديات:
git clone https://github.com/aa1143/NamiGPT.git
cd NamiGPT
pip install -r requirements.txt
إلى كانت الشبكة محدودة ملي كتنزّل الأوزان الرسمية من HuggingFace، تقدر تضبط عنوان المرآة فالتيرمينال الحالي:
export HF_ENDPOINT=https://hf-mirror.comهاد المرآة كتستعمل غير لتحميل الأوزان الرسمية. من بعد، ملي كتستعمل from_pretrained، بنية النموذج كتبقى جاية من التطبيق اليدوي ديال NamiGPT.
الخطوة الأولى: فهم GPT-2 حسب الفصول
الطريقة الأنسب للمبتدئين ماشي هي تقرا النموذج كامل من الأول، ولكن تتعلم فصل بفصل حسب تدفق بيانات الاستدلال:
- مرحلة الإدخال: فهم Tokenizer وEmbedding والترميز الموضعي.
- مرحلة الانتباه: فهم Self-Attention، ومن بعد التوسّع لـ Multi-Head Attention.
- مرحلة الوحدات: تعلّم الوصلات المتبقية وLayerNorm وFFN ودوال التنشيط.
- مرحلة النموذج: جمع المكوّنات فـ Transformer Block، ومن بعد تراصّها باش يتكوّن GPT-2 كامل.
- مرحلة التطبيق: تحميل الأوزان الرسمية، وتوليد النص، والاطلاع على نتائج قابلية التفسير.
كل سكريبت كيقدر يخدم بوحدو. مثلاً، باش تشغّل فصل الانتباه متعدد الرؤوس:
python chapters/01-inference/ep06_multi_head_attention.pyالمحتوى الكامل بالصور والنصوص متوفر فـدروس NamiGPT المصوّرة، والمسودة الأصلية فالمستودع كاينة فـ docs/01-inference/.
الخطوة الثانية: تحميل GPT-2 وتوليد النصوص
من بعد التثبيت، تقدر تستورد مباشرة الواجهات ديال تحميل النموذج والتوليد اللي كيوفّرها NamiGPT. المثال التالي كيستعمل tokenizer ديال GPT-2، وكيحوّل prompt بالإنجليزية إلى token ID، ومن بعد كيحمّل النموذج المكتوب يدوياً والأوزان الرسمية بحجم 124M:
import tiktoken, torch
from gpt2 import from_pretrained, generate

enc = tiktoken.get_encoding("gpt2")
model = from_pretrained("gpt2")

ids = torch.tensor([enc.encode("The cat sat on the")])
out = generate(
    model,
    ids,
    max_new_tokens=30,
    temperature=0.8,
    top_k=50,
)
print(enc.decode(out[0].tolist()))
مراحل تنفيذ الكود
tiktoken.get_encoding("gpt2")كيجلب المرمّز اللي كيستعملو GPT-2.enc.encode(...)كيحوّل نص الـprompt إلى token ID.torch.tensorكيغلّف المعرّفات فـ tensor ديال الدفعة اللي كيحتاجها النموذج.from_pretrained("gpt2")كينشئ GPT-2 مكتوب يدوياً، وكيحمّل الأوزان الرسمية بحجم 124M.generateكيولّد حتى لـ 30 token جديد من بعد نص الـprompt.enc.decodeكيرجّع token ID الناتجة إلى نص.
ملاحظة: GPT-2 ما تدرّبش على المحادثات، والقوة ديالو هي يكمل محتوى موجود، ماشي يجاوب على الأسئلة بحال نماذج الدردشة. و حيث بيانات التدريب ديالو أغلبها بالإنجليزية، من الأحسن تستعمل prompts بالإنجليزية فالبداية.
الخطوة الثالثة: فهم معاملات التوليد
المثال كيستعمل جوج معاملات مهمّين ديال أخذ العينات:
temperature=0.8: كيتستعمل لضبط توزيع احتمالات token المرشّحة. وحدة التوليد فالمشروع كتدعم استراتيجية درجة الحرارة.top_k=50: كيختار غير من بين أول 50 token مرشّحة ذات الاحتمال الأعلى. المشروع كيدعم حتى التوليد الجشع وتوليد top-k.
أثناء التعلّم، تقدر تخلي نص الـprompt ثابت وتبدّل غير درجة الحرارة أو top-k، ومن بعد تقارن نتائج الإكمال. بهاد الطريقة غادي تشوف مباشرة كيفاش كتأثر استراتيجية التوليد على الخرج، ولكن اختيار المعاملات خاصو يتوافق مع الهدف ديال التجربة.
الخطوة الرابعة: تشغيل العرض عبر Gradio
إلى بغيتي تدخل prompt من المتصفح وتشوف نتيجة الإكمال واحتمالات الكلمات المرشّحة فكل خطوة، ثبّت Gradio وشغّل برنامج العرض الموجود فالمستودع:
pip install gradio
python demo/app.py
العرض عبر الويب مناسب لمراقبة توقعات النموذج فكل خطوة، بينما سكريبتات الفصول أنسب لدراسة طريقة حساب مكوّن واحد. باستعمال بجوج، تقدر تربط النص النهائي بالتغيّرات الداخلية فالأحجام الاحتمالية.
الخطوة الخامسة: تشغيل الاختبارات
من الأحسن تشغّل الاختبارات من بعد ما تبدّل الانتباه أو تحميل الأوزان أو منطق التوليد. الاختبارات الافتراضية كتستعمل أوزان عشوائية للمقارنة، وما كتحتاجش لتحميل نموذج مدرّب مسبقاً، وغالباً كتكمّل بسرعة:
pytest tests/ -vإلى بغيتي حتى تستعمل أوزان GPT-2 الحقيقية للمطابقة الإضافية، شغّل:
TEST_PRETRAINED=1 pytest tests/ -vالأمر الثاني كيحمّل الأوزان الحقيقية زيادة على ذلك، وبالتالي أول تشغيل خاصو ينتظر حتى يكمل التحميل.
نظرة سريعة على بنية المستودع
gpt2/config.py: إعدادات النموذج، وفيها مواصفات 124M و355M و774M و1.5B.gpt2/model.py: LayerNorm وAttention وFFN وBlock والنموذج الأساسي GPT.gpt2/load_weights.py: تحميل الأوزان الرسمية فالنموذج المكتوب يدوياً.gpt2/generate.py: منطق التوليد الجشع وتوليد درجة الحرارة وtop-k.chapters/01-inference/: سكريبتات العرض الموافقة لفصول الدرس.docs/01-inference/: المسودات الأصلية لمقالات الدرس.demo/app.py: العرض عبر الويب باستعمال Gradio.tests/: فحوصات الأشكال واختبارات المطابقة مع HuggingFace.
تقنيات متقدمة: ثلاثة تفاصيل أساسية للمطابقة مع HuggingFace
1. التطبيق الصحيح للقناع السببي
GPT-2 هو نموذج لغوي ذاتي الانحدار. كل كلمة فالسلسلة تقدر تقرا غير نفسها والكلمات اللي قبل منها، وما تقدرش تشوف token اللي من بعد قبل الوقت. إلى ما تطبّقش القناع السببي، حتى إلا تحمّلات الأوزان الرسمية بنجاح، غادي يخرّج النموذج نتائج خاطئة.
2. التعامل مع التبديل أثناء نقل الأوزان
التطبيق الأصلي ديال GPT-2 كيستعمل Conv1D، وشكل الأوزان ديالو هو [in, out]؛ أما nn.Linear ديال PyTorch كيستعمل [out, in]. لذلك، ملي كتنقل المعاملات الرسمية للطبقة الخطية المكتوبة يدوياً، خاصك تدير transpose.
وزيادة على ذلك، c_attn كيجمع معاملات Query وKey وValue فبلاصة وحدة. باش تطابق التطبيق اليدوي، خاصك أولاً تقسّمها لثلاثة أجزاء مناسبة، ومن بعد تحط كل جزء فالمكان الصحيح.
3. استعمال تقريب tanh ديال GELU
GPT-2 كيستعمل النسخة التقريبية بـ tanh من GELU، بينما nn.GELU() ديال PyTorch كيستعمل افتراضياً النسخة الدقيقة. إلى بغيتي مطابقة عنصر بعنصر، خاصك تضبط:
nn.GELU(approximate="tanh")هاد التفاصيل الثلاثة باينة صغيرة، ولكن كتأثر مباشرة على واش النموذج المكتوب يدوياً يقدر يعاود نفس نتائج التطبيق الرسمي. ملي كتحدّد مصدر الخطأ، تقدر تفحص بالتتابع القناع، وأشكال المعاملات، ونسخة دالة التنشيط.
طريقة مقترحة للتعلّم وتصحيح الأخطاء
- بدا بفهم العلاقة العامة: GPT-2 كيستعمل غير جزء Transformer ديال فك الترميز، وذلك من خلال الرسم المتحرك للبنية.
- شغّل سكريبت الفصل الحالي، وسجّل أشكال المدخلات والمخرجات والتنسورات الوسيطة.
- ملي تكون مصفوفة الانتباه صعيبة الفهم، قارنها مع التصوير المرئي للمصفوفة على الإنترنت وفحصها خانة بخانة.
- من بعد ما تكمل مكوّناً، قرا التطبيق المقابل ديالو فـ
gpt2/model.py. - من بعد تعديل التطبيق، شغّل أولاً اختبار الأوزان العشوائية، ومن بعد اختبار الأوزان الحقيقية حسب الحاجة.
- فالأخير، استعمل مثال توليد النصوص وصفحة Gradio باش تراقب سلوك النموذج كامل.
هاد الترتيب كيربط بين الرسم البنيوي، وحساب المصفوفات، وكود الفصول، والنموذج الكامل، والخرج النهائي، وكيجنبك تغرق من الأول فالبنية متعددة الطبقات ديال GPT-2 كامل.
الخلاصة
NamiGPT كيوفّر مسار تعلّم كيمتدّ من الحسابات الأساسية ديال المصفوفات حتى للاستدلال الكامل ديال GPT-2. تقدر تبدا بتشغيل سكريبتات الفصول المستقلة باش تفهم كل مكوّن، ومن بعد تحمّل الأوزان الرسمية ديال OpenAI باش تكمل نصوص بالإنجليزية، وفالأخير تتحقق من الفهم والتعديلات ديالك باستعمال التصوير البصري واختبارات التوافق مع HuggingFace.
كود المشروع مرخّص بموجب رخصة MIT؛ والمقالات اللي فالمجلد docs/ مرخّصة بموجب رخصة CC BY-NC 4.0، وإعادة النشر خاصها تذكر المصدر وممنوع الاستعمال التجاري.