
LLaMA Factory (اللي تبدّل السمية ديالو دابا لـ LlamaFactory) هو إطار موحّد للضبط الدقيق ديال النماذج اللغوية الكبيرة. المشروع بدا به فريق الدكتور Zheng Yaowei من جامعة Beihang، وكيستند أكاديمياً على ورقة ACL 2024. الإطار مصمّم على أساس «CLI بلا كود + واجهة Web»، والهدف ديالو هو تبسيط مسار الضبط الدقيق. حصل LlamaFactory فـ GitHub على أكثر من 72 000 نجمة، وولا مرجعاً فمجال الضبط الدقيق ديال النماذج الكبيرة.
>
1. نظرة عامة على المشروع
البُعد|التفاصيل
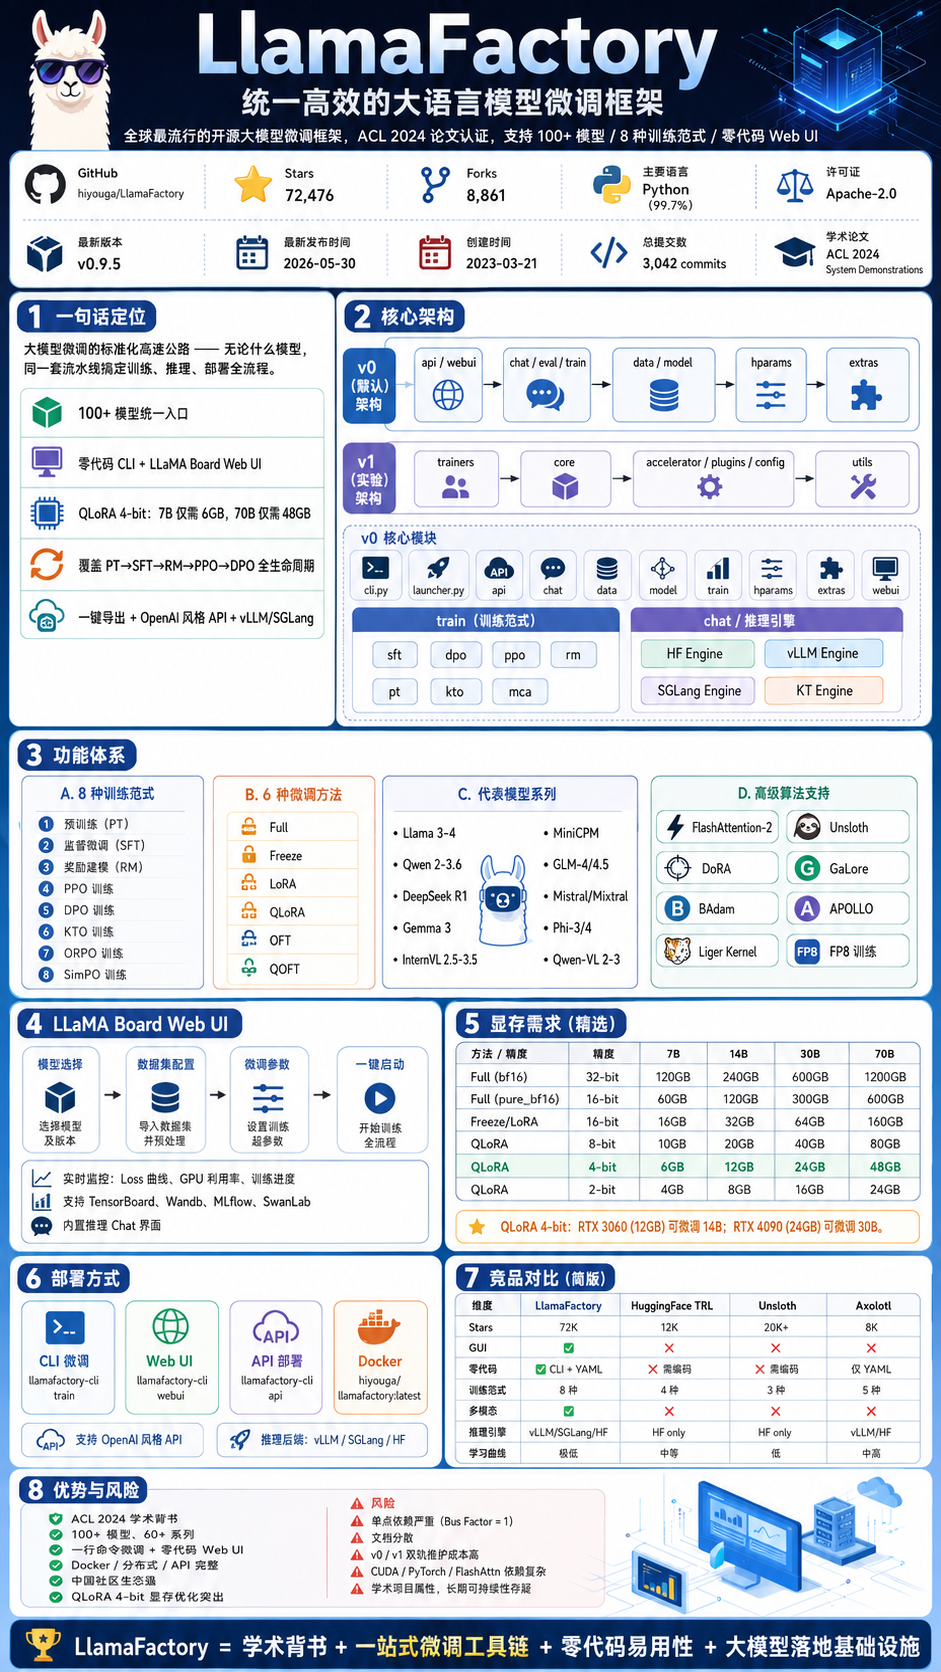
الاسم الكامل للمشروع|LlamaFactory (الاسم القديم LLaMA-Factory)
عنوان GitHub|github.com/hiyouga/LlamaFactory
النجوم|72,476 ⭐
Forks|8,861
اللغة الرئيسية|Python (99.7%)
الرخصة|Apache-2.0
تاريخ الإنشاء|2023-03-21
آخر إصدار|v0.9.5 (2026-05-30)
مجموع الـ commits|3,042 commits
المساهم الرئيسي|hiyouga (Zheng Yaowei، 2,188 commits، أي 72% من مجموع الإيداعات)
الورقة الأكاديمية|ACL 2024 System Demonstrations
حجم المستودع|~412.9 MB
المشاكل المفتوحة|57
المؤسس Zheng Yaowei (hiyouga) طالب دكتوراه فجامعة Beihang. نشر بصفته المؤلف الأول بزاف ديال الأوراق فمؤتمرات دولية مرموقة بحال ACL وCVPR وWWW، وكان مراجعاً فمؤتمرات بحال AAAI وEMNLP. ومن بين الجوائز اللي حصل عليها: الجائزة الوطنية الأولى فـ Huawei Cup وBlue Bridge Cup، وشخصية السنة بين طلبة Beihang، وجائزة المساهمة المتميزة فالمصادر المفتوحة ضمن منظومة Ascend. ومن أعضاء الفريق المتعاونين أساتذة Beihang: Zhang Richong وZhang Junhao وYe Yanhan وLuo Zheyan وFeng Zhangchi وMa Yongqiang وغيرهم.
2. موقع المشروع والقيمة الأساسية ديالو
2.1 الموقع فـ جملة وحدة
سير عمل موحّد للضبط الدقيق ديال النماذج الكبيرة: مسار موحّد صالح لأي نموذج، وكيشمل جميع المراحل من تحضير البيانات وتدريب النموذج، مروراً بالاستدلال والتحقق، حتى النشر.
2.2 المشاكل الأساسية اللي كيحلّها
المشكل|حل LLaMA Factory
مسارات الضبط الدقيق كتختلف من نموذج لآخر، وتبديل النماذج مكلف|تصميم «فصل» الخوارزمية عن النموذج والبيانات، مع مدخل موحّد لأكثر من 100 نموذج
كود الضبط الدقيق صعيب وكيحتاج لخلفية فالتعلم العميق|CLI بلا كود + واجهة LLaMA Board Web (Gradio)
الذاكرة ديال GPU ما كافياش، وGPU الاستهلاكية ما كتقدرش تدرّب النماذج الكبيرة|QLoRA 4-bit: غير 6GB لنموذج 7B و48GB لنموذج 70B
مجتمع المصادر المفتوحة ناقصو سلسلة أدوات متكاملة|تغطية دورة الحياة كاملة من PT→SFT→RM→PPO→DPO
النشر ديال الاستدلال معقد|تصدير بنقرة وحدة + API على طريقة OpenAI + vLLM/SGLang
2.3 فلسفة التصميم: «فصل» الخوارزمية عن النموذج والبيانات
فواحد الحوار، شبّه Zheng Yaowei عملية استدلال النموذج بالسيارات اللي كتسافر فطريق سيار موحّد؛ فالنموذج كيمثّل أنواع مختلفة ديال السيارات، والبيانات كتمثّل الحمولة اللي محمّلة فالسيارة. إلا قدر النموذج يخدم مزيان فهاد الطريق السيار، فالضبط الدقيق كيكمّل غير بتعديل المعاملات.
3. تحليل معمّق للهندسة التقنية
3.1 تصميم متوازٍ بهندستين
كتوفّر LLaMA Factory فـ نفس الوقت جوج هياكل: v0 (الإصدار المستقر) وv1 (الإصدار التجريبي)، ويمكن التبديل بيناتهم باستعمال متغير البيئة USE_V1.
v0 (الافتراضي): api/webui → chat/eval/train → data/model → hparams → extras
v1 (التجريبي): trainers → core → accelerator/plugins/config → utils
هندسة v0 هي التطبيق الرئيسي الحالي، وكتوفّر الوظائف الكاملة مع توثيق شامل. أما هندسة v1 فما زالت فمرحلة التجريب، وكتعتمد تصميماً طبقياً أكثر modularité.
3.2 شرح الوحدات الأساسية ديال v0
src/llamafactory/
├── cli.py              # مدخل CLI وتوزيع أمر llamafactory-cli
├── launcher.py          # المشغّل، كيوزّع حسب USE_V1
├── api/                 # REST API على طريقة OpenAI
│   ├── app.py           # تطبيق FastAPI
│   ├── chat.py          # نقطة المحادثة
│   └── protocol.py      # تعريف البروتوكول
├── chat/                # طبقة محرك الاستدلال
│   ├── base_engine.py   # الصنف الأساسي المجرّد
│   ├── hf_engine.py     # الاستدلال الأصلي ديال HuggingFace
│   ├── vllm_engine.py   # الاستدلال عالي الأداء ديال vLLM
│   └── sglang_engine.py # الاستدلال ديال SGLang
├── data/                # طبقة معالجة البيانات
│   ├── template.py      # تسجيل قوالب Prompt لأكثر من 100 نموذج
│   ├── mm_plugin.py     # معالجة متعددة الوسائط (الصور/الفيديو/الصوت)
│   ├── loader.py        # محمّل مجموعات البيانات
│   ├── processor/       # معالجات حسب مرحلة التدريب
│   └── converter.py     # تحويل الصيغ (Alpaca/ShareGPT)
├── model/               # طبقة النموذج
│   ├── loader.py        # تحميل النموذج والمجزّئ، والتكميم، وLoRA
│   └── patcher.py       # رقع توافق النموذج
├── train/               # طبقة التدريب
│   ├── sft/             # الضبط الدقيق الخاضع للإشراف
│   ├── dpo/             # تحسين التفضيلات DPO
│   ├── ppo/             # التعلم المعزز PPO
│   ├── rm/              # نمذجة المكافأة
│   ├── pt/              # التدريب القبلي
│   ├── kto/             # تدريب KTO
│   └── mca/             # تكييف Megatron-Core
├── hparams/              # طبقة إعداد المعاملات
│   ├── model_args.py    # معاملات النموذج
│   ├── data_args.py     # معاملات البيانات
│   ├── finetuning_args.py # معاملات الضبط الدقيق
│   └── training_args.py # معاملات التدريب (كتورّث HF TrainingArguments)
├── extras/               # حزمة الأدوات
│   ├── constants.py     # الثوابت/التعدادات العامة
│   └── packages.py      # التحقق من الاعتماديات
└── webui/                # واجهة LLaMA Board Web
    ├── interface.py     # بناء واجهة Gradio
    ├── runner.py        # تشغيل مهام التدريب
    └── components/      # مكوّنات الواجهة
3.3 مسار التدريب (v0 Training Flow)
llamafactory-cli train xxx.yaml
  → run_exp() [tuner.py]
    → read_args() → تحليل إعدادات YAML/JSON
    → get_train_args() → إنشاء 4 dataclass مهيكلة:
        ModelArguments + DataArguments + FinetuningArguments + TrainingArguments
    → التوجيه لوظيفة التدريب المناسبة:
        run_sft / run_dpo / run_ppo / run_rm / run_pt / run_kto
    → (اختياري) export_model() → دمج أوزان LoRA وتصديرها
3.4 مصفوفة محركات الاستدلال
المحرك|الخصائص|مجال الاستعمال
HF Engine|HuggingFace الأصلي، بأفضل توافق|التطوير والتصحيح، والاستدلال على نطاق صغير
vLLM Engine|تسريع الاستدلال بنسبة 270%، وPagedAttention|الاستدلال عالي الأداء على الإنترنت
SGLang Engine|RadixAttention وتوليد مهيكل|الاستدلال على دفعات والتوليد المعقد
KT Engine|مخصّص لنقل المعرفة|تقطير النماذج
4. منظومة الوظائف
4.1 أنماط التدريب المدعومة (8 × 6 طرق ضبط دقيق = 48 تركيبة)
نمط التدريب|Full|Freeze|LoRA|QLoRA|OFT|QOFT
التدريب القبلي (PT)|✅|✅|✅|✅|✅|✅
الضبط الدقيق الخاضع للإشراف (SFT)|✅|✅|✅|✅|✅|✅
نمذجة المكافأة (RM)|✅|✅|✅|✅|✅|✅
تدريب PPO|✅|✅|✅|✅|✅|✅
تدريب DPO|✅|✅|✅|✅|✅|✅
تدريب KTO|✅|✅|✅|✅|✅|✅
تدريب ORPO|✅|✅|✅|✅|✅|✅
تدريب SimPO|✅|✅|✅|✅|✅|✅
4.2 سلاسل النماذج المدعومة (أكثر من 60 سلسلة و100+ تنويعة)
نماذج مختارة وممثّلة:
سلسلة النماذج|حجم المعلمات|الميزة
Llama 3-4|1B–402B|نموذج Meta مفتوح المصدر الرائد
Qwen 2-3.6|0.5B–397B|السلسلة الكاملة ديال Tongyi Qianwen من Alibaba
DeepSeek R1|1.5B–671B|نسخة مقطّرة من نموذج الاستدلال
Gemma 3|270M–27B|نموذج Google خفيف
InternVL 2.5-3.5|1B–241B|نموذج رؤية ولغة متعدد الوسائط
MiniCPM|0.5B–9B|محسّن للنشر على الأجهزة الطرفية
GLM-4/4.5|9B–355B|سلسلة ChatGLM ديال Zhipu
Mistral/Mixtral|7B–8x22B|مزيج خبراء MoE
Phi-3/4|3.8B–14B|نموذج Microsoft صغير وعالي الأداء
Qwen-VL 2-3|2B–235B|نموذج رؤية ولغة
4.3 دعم الخوارزميات المتقدمة
الخوارزمية|الوظيفة|الإصدار ديال الإدماج
FlashAttention-2|تسريع حساب الانتباه|2023-09
Unsloth|تسريع التدريب بنسبة 170% + اقتصاد 50% من ذاكرة GPU|2023-12
DoRA|تحليل أوزان LoRA|2024-02
GaLore|تحسين منخفض الرتبة للتدرجات|2024-03
BAdam|تحسين بالانحدار المنسّق على الكتل|2024-04
APOLLO|محسّن من الرتبة العليا|2025-Q1
Liger Kernel|تسريع نوى Triton|2025
تدريب FP8|دعم Transformer Engine|2025
4.4 واجهة LLaMA Board Web UI
واجهة بصرية بلا كود مبنية على Gradio
اختيار النموذج → إعداد مجموعة البيانات → معلمات الضبط الدقيق → تشغيل التدريب بنقرة وحدة
مراقبة مباشرة: منحنى Loss، ونسبة استعمال GPU، وتقدّم التدريب
دعم سجلات TensorBoard وWandb وMLflow وSwanLab عبر خلفيات متعددة
واجهة Chat مدمجة للاستدلال، وتقدر تجرّب النموذج مباشرة من بعد التدريب
4.5 طرق النشر
# الضبط الدقيق عبر CLI (أمر واحد)
llamafactory-cli train examples/train_lora/qwen3_lora_sft.yaml

# واجهة الويب
llamafactory-cli webui

# نشر API بنمط OpenAI
API_PORT=8000 llamafactory-cli api examples/inference/qwen3.yaml

# Docker
docker run -it --rm --gpus=all hiyouga/llamafactory:latest
خامساً، متطلبات العتاد (تقدير ذاكرة GPU)
الطريقة|الدقة|7B|14B|30B|70B
Full (bf16)|32-bit|120GB|240GB|600GB|1200GB
Full (pure_bf16)|16-bit|60GB|120GB|300GB|600GB
Freeze/LoRA|16-bit|16GB|32GB|64GB|160GB
QLoRA|8-bit|10GB|20GB|40GB|80GB
QLoRA|4-bit|6GB|12GB|24GB|48GB
QLoRA|2-bit|4GB|8GB|16GB|24GB
الكمّيّة QLoRA بـ4‑bit كتخلّي ممكن تدير الضبط الدقيق لنموذج فيه 14 B ديال المعلمات فوق RTX 3060 وحدة (12 GB ديال ذاكرة GPU)، ولنموذج فيه 30 B ديال المعلمات فوق RTX 4090 وحدة (24 GB ديال ذاكرة GPU).
سادساً، تطوّر الإصدارات
الإصدار|التاريخ|التغييرات الرئيسية
v0.1.0|2023-03|الإصدار الأول، مع دعم الضبط الدقيق لـ LLaMA
التكرارات المبكرة|2023|SFT + LoRA/QLoRA، وDPO، وWeb UI، وFlashAttention-2، وUnsloth
التكرارات المبكرة|2024 Q1-Q3|DoRA، وGaLore، وBAdam، وFSDP+QLoRA، وvLLM، وLLaVA متعدد الوسائط، ونشر الورقة العلمية
v0.9.1|2025 Q1|Llama 3.2 Vision، وLLaVA-NeXT، وPixtral، وVideo-LLaVA
v0.9.2|2025 Q1|MiniCPM-o، وSwanLab، ومحسّن APOLLO
v0.9.3|2025 Q2|Llama 4، وGemma 3، وQwen3، وInternVL3، وQwen2.5-Omni
v0.9.4|2025-12|🔄 تبدّل اسم المستودع إلى LlamaFactory، والتخلّي عن Python 3.9-3.10
v0.9.5|2026-05-30|التوافق مع Qwen3.5/3.6، وGemma 4، وTransformers v5
v1.x (تجريبي)|2026|معمارية جديدة trainers → core → accelerator، وإعادة كتابة معيارية
شرح المحطات الرئيسية
نشر ورقة ACL 2024 —— الدعم الأكاديمي خلّى عدد Stars يطلع من 10 آلاف حتى لأكثر من 30 ألف
النصف الثاني من 2024 —— دعم الوسائط المتعددة (LLaVA/Video/الصوت) فتح سوق جديد
عام 2025 —— الحفاظ على وتيرة إصدار شهرية، ودعم Qwen3/DeepSeek/Llama4، وولات الخيار الأول فمجتمع المصادر المفتوحة فالصين
تبديل اسم المستودع —— LLaMA-Factory → LlamaFactory، والتخلّي على الاعتماد على علامة Meta
معمارية v1 التجريبية —— كتلمّح لإعادة هيكلة كبيرة قريبة
سابعاً، المنظومة المجتمعية
7.1 مصفوفة منظومة المشاريع
المشروع|الوصف|Stars
LlamaFactory|إطار الضبط الدقيق الأساسي|72K+
EasyR1|التعلّم المعزّز لنماذج VLM (GRPO/DAPO/Reinforce++)|ناشئ
FastEdit|تحرير فعّال لحقائق النماذج|مؤرشف
llamafactory-community|مركز التواصل المجتمعي|-
Easy Dataset|أداة توليد البيانات الاصطناعية|طرف ثالث
DataFlow|خط أنابيب معالجة البيانات|طرف ثالث
7.2 شعبية المجتمع
مجتمع الذكاء الاصطناعي الصيني: مئات ديال الشروحات وتجارب التطبيق فـ CSDN وZhihu و博客园
اعتماد الشركات: موصى به رسمياً من Alibaba Cloud وHuawei Ascend وAmazon AWS وNVIDIA
المجال التعليمي: كتستعملو جامعة Fudan وعدة جامعات أخرى كأداة لتدريس مقررات النماذج الكبيرة
التكييف مع الصينية: دعم أصلي لـ ModelScope (مجتمع魔搭) وتنزيلات النسخ المرآة من OpenMind Hub
LLaMA Factory Online: كان كيوفّر خدمة منصة عبر الإنترنت، وتسدّات الخدمة فـ 2026-06-20
7.3 مقارنة مع المنافسين
الإطار|Stars|الميزة الرئيسية|دعم النماذج|سهولة الاستعمال
LlamaFactory|72K|واجهة GUI/CLI متكاملة، ودعم من ورقة ACL|100+|⭐⭐⭐⭐⭐
HuggingFace TRL|12K|سلسلة أدوات HF الرسمية، مندمجة بعمق مع المنظومة|جميع نماذج HF|⭐⭐⭐
Axolotl|8K|مدفوع بـ YAML، وتخصيص للمستخدمين المتقدمين|النماذج الرئيسية|⭐⭐⭐
Unsloth|20K+|تحسين أقصى للأداء (تسريع 2-5x)|LLaMA/Mistral وغيرها|⭐⭐⭐⭐
Firefly|5K|تحسين النماذج الكبيرة الصينية|خصوصاً النماذج الصينية|⭐⭐⭐
LLaMA-Adapter|6K|موجّه للبحث الأكاديمي|سلسلة LLaMA|⭐⭐
المزايا الأساسية ديال LlamaFactory:
الإطار الوحيد اللي كيجمع فآن واحد بين ورقة ACL + 70 ألف Stars + حالات استعمال تجارية + واجهة GUI بلا كود
أوسع تغطية للنماذج (من GPT-2 حتى Llama 4، ومن النصوص فقط حتى الوسائط المتعددة)
أقوى منظومة فالمجتمع الصيني (نسخ HuggingFace المرآة + تكامل ModelScope)
ثامناً، تحليل SWOT
8.1 نقاط القوة (Strengths)
نقطة القوة|التفاصيل
🔬 المصداقية الأكاديمية|ورقة ACL 2024، وأكثر من 500+ اقتباس أكاديمي
🎯 عتبة استعمال منخفضة بزاف|ضبط دقيق بأمر واحد، وتشغيل بلا كود عبر Web UI
🌐 أوسع تغطية للنماذج|100+ نموذج، و60+ سلسلة، ونص/رؤية/فيديو/صوت
🇨🇳 منظومة المجتمع الصيني|نسخ ModelScope/OpenMind المرآة، وكمية كبيرة ديال الشروحات بالصينية
🔧 سلسلة أدوات بمستوى صناعي|Docker/النشر الموزّع/API كاملين
💾 تحسين أقصى لذاكرة GPU|تشغيل 70B على GPU استهلاكية باستعمال QLoRA 4-bit
8.2 نقاط الضعف (Weaknesses)
نقطة الضعف|التفاصيل
👤 اعتماد كبير على شخص واحد|hiyouga مسؤول على 72% من الإسهامات (2,188/3,042)، وBus Factor = 1
📚 توثيق متفرّق|README طويل بزاف (68KB)، والمعلومات متشتتة بين Wiki وReadTheDocs ومقالات المجتمع
🐛 تراكم Issues|غير 57 Open Issues، ولكن النقاشات فقسم Issues كثيرة بزاف
🏗️ انقسام بين مساري v0/v1|كلفة صيانة معماريتين مرتفعة، وv1 مازال ما استقرّش مدة طويلة
📦 تعقيد تبعيات الحزم|مصفوفة إصدارات CUDA/PyTorch/FlashAttn كتوقع فالأخطاء بسهولة
🔒 طابع المشروع الأكاديمي|ما كايناش فرقة تشغيل متفرغة، والاستدامة على المدى الطويل مشكوك فيها
8.3 الفرص (Opportunities)
الفرصة|التفاصيل
🚀 سيناريوهات ضبط الوكلاء|الطلب على الضبط الدقيق لـ Function Calling / Tool Use كيزيد بسرعة
🎥 التوسع متعدد الوسائط|سوق واعد لضبط نماذج الفيديو/الصوت/3D
☁️ SaaS سحابي أصلي|رغم توقّف LLaMA Factory Online، مازال الطلب على الاستضافة الموجّهة للشركات موجود
🏢 سوق التدريب للشركات|دورات الضبط الدقيق للنماذج الكبيرة وأنظمة الشهادات
🔗 تكامل MCP|كخلفية للضبط الدقيق ضمن البنية التحتية لوكلاء الذكاء الاصطناعي
8.4 التهديدات (Threats)
التهديد|التفاصيل
🏢 أطر مطوّرة داخلياً من الشركات الكبرى|Alibaba PAI وHuawei ModelArts كيوفرو حلولاً متكاملة
🔄 منافسة الأدوات الرسمية ديال HF|منظومة HuggingFace TRL/peft كتحسّنات باستمرار
📉 تراجع الحاجة للضبط الدقيق|Prompt Engineering + RAG كيعوّضو جزئياً بعض حالات استعمال الضبط الدقيق
👨🎓 تخرّج المؤسس|من بعد تخرّج الدكتور Zheng Yaowei، ممكن ينقص مستوى صيانة المشروع
تاسعاً، تقييم المخاطر
فئة المخاطر|مستوى المخاطر|التوضيح
Bus Factor|🔴 مخاطر عالية|مساهم واحد أساسي مسؤول على 72% من الكوميتات، وإذا مشى فاحتمال يوقف المشروع كبير بزاف
الدَّين التقني|🟡 مخاطر متوسطة|بنية مزدوجة v0/v1، README فيه 68KB، وتشتّت التوثيق
سلسلة الاعتماديات|🟡 مخاطر متوسطة|كلفة كبيرة فالحفاظ على مصفوفة إصدارات CUDA/PyTorch/FlashAttn
التجاريّة|🟢 مخاطر منخفضة|رخصة Apache-2.0 بلا قيود تجارية
صحة المجتمع|🟢 مزيانة|72 ألف Stars، مجتمع عالمي ناشط، واعتماد واسع من الشركات
عاشراً، النقط التقنية والابتكار
10.1 بنية «الطريق السيار الموحّد»
فالتدقيق التقليدي، كل موديل كيحتاج تكييف بوحدو. LLaMA Factory كتستعمل آلية تسجيل القوالب مع تقنية monkey‑patch، وهاد الشي كيهبّط بزاف من كلفة التكييف.
# إضافة موديل جديد كتحتاج غير لـ 3 خطوات:
# 1. تسجيل قالب Prompt فقاموس TEMPLATES داخل template.py
# 2. إضافة رقعة توافق الموديل فـ patcher.py (إلى كانت ضرورية)
# 3. إضافة دعم الوسائط المتعددة فـ mm_plugin.py (إلى كان ضروري)
10.2 نظام إعدادات المعايير فـ 4 طبقات
ملف إعدادات YAML/JSON
  → التحليل عبر parser.py
    → ModelArguments (اختيار الموديل، والكمّية)
    → DataArguments (مجموعة البيانات، القالب، والمعالجة المسبقة)
    → FinetuningArguments (رتبة/هدف LoRA، وطريقة التدريب)
    → TrainingArguments (وارثة من HF، التوزيع/السجلات/نقاط الحفظ)
10.3 توحيد أنبوب البيانات
هاد الأداة كتدعم جوج صيغ رئيسية للبيانات: Alpaca وShareGPT، وكتقدر تحوّل أوتوماتيكياً أكثر من 50 مجموعة بيانات جاهزة، وكتتوافق مع صيغ JSON وJSONL وCSV وParquet وArrow وغيرها.
10.4 دعم تدريجي للكمّية
كتدعم من الدقة الكاملة بـ 16 بت حتى QLoRA بـ 2 بت، يعني ستة مستويات ديال الدقة، وكتخدم فبيئات عتاد مختلفة بحال عناقيد خوادم A100 والحواسيب المحمولة العادية.
حادي عشر، مصفوفة مقارنة المنافسين
البُعد|LlamaFactory|HuggingFace TRL|Unsloth|Axolotl
Stars|72K|12K|20K+|8K
دعم الموديلات|أكثر من 100 سلسلة|جميع موديلات HF|LLaMA/Qwen/Mistral|السلاسل الرئيسية
GUI|✅ LLaMA Board|❌|❌|❌
بلا كود|✅ CLI + YAML|❌ خاص البرمجة|❌ خاص البرمجة|غير YAML
نماذج التدريب|8|4 (SFT/DPO/PPO/GRPO)|3|5
عمق الكمّية|2-16bit|4-16bit|4-16bit|4-16bit
الوسائط المتعددة|✅ صور/فيديو/صوت|❌|❌|❌
المنظومة الصينية|✅ ModelScope + 魔搭|⚠️ خاص تجاوز الحجب|⚠️ خاص تجاوز الحجب|❌
الأبحاث الأكاديمية|ACL 2024|-|-|-
محرك الاستدلال|vLLM/SGLang/HF|HF فقط|HF فقط|vLLM/HF
منحنى التعلّم|ساهل بزاف|متوسط|ساهل|متوسط للصعب
ثاني عشر، أهم النقط فالنشر العملي
12.1 البداية السريعة (3 خطوات)
# الخطوة 1: التثبيت
git clone --depth 1 github.com/hiyouga/LlamaFactory.git
cd LlamaFactory
pip install -e ".[torch,metrics]"

# الخطوة 2: تشغيل Web UI
llamafactory-cli webui

# الخطوة 3: حلّ localhost:7860 فالمتصفح، واختار الموديل → مجموعة البيانات → التدريب!
12.2 نصائح لبيئة الإنتاج
# النشر عبر Docker (موصى به)
docker run -it --rm --gpus=all \
    -v ./hf_cache:/root/.cache/huggingface \
    -v ./data:/app/shared_data \
    -v ./output:/app/output \
    -p 7860:7860 -p 8000:8000 \
    hiyouga/llamafactory:latest

# النشر عبر API (متوافق مع OpenAI)
API_PORT=8000 llamafactory-cli api \
    examples/inference/qwen3.yaml \
    infer_backend=vllm
12.3 ملاحظات لمستخدمي Windows
خاص تثبّت يدوياً نسخة PyTorch GPU:
pip install torch torchvision torchaudio --index-url download.pytorch.org/whl/cu126QLoRA كتحتاج تثبيت نسخة bitsandbytes مُجمّعة مسبقاً خاصة بـ Windows
FlashAttention-2 فـ Windows كتحتاج التجميع اليدوي
عيّن
dataloader_num_workers: 0باش تتفادى أخطاء التسلسل
ثالث عشر، آفاق المستقبل
استقرار بنية v1:متوقّع الفرع التجريبي يولي هو البنية الرئيسية فـ 2026-2027، مع مستوى أعلى من الوحداتية
تعميق تدقيق Agent:تدقيق Tool Use / Function Calling غادي يولي وظيفة معيارية
تدقيق موديلات الاستدلال (Reasoning):تقطير DeepSeek-R1 + تدقيق GRPO (مشروع EasyR1)
استضافة سحابية أصلية:من بعد ما تسدات LLaMA Factory Online، ممكن يبانوا حلول استضافة من أطراف ثالثة
توحيد تدريب الوسائط المتعددة:تدقيق النصوص/الصور/الفيديو/الصوت داخل نفس الإطار
رابع عشر، التنقيط والخلاصة
البُعد|النقطة|التقييم
البنية التقنية|9.5/10|تصميم وحداتي، تطوّر البنية المزدوجة، ومصفوفة غنية ديال المحركات
اكتمال الوظائف|10/10|8 نماذج تدريب × 6 طرق تدقيق × أكثر من 100 موديل
سهولة الاستعمال|10/10|تدقيق بأمر واحد + Web UI بلا كود، الأفضل فالمجال
جودة التوثيق|7.5/10|README مفصّل ولكن طويل بزاف، والتشتّت كبير
نشاط المجتمع|9.5/10|72K Stars، وشعبية استثنائية فالمجتمع الصيني
الجاهزية للإنتاج|9.0/10|Docker/API/التوزيع كاملين، ومجرّب بشكل واسع فالشركات
الاستدامة|6.5/10|Bus Factor=1، وطابع المشروع الأكاديمي كيخلّي المدى الطويل محلّ شك
الابتكار|8.5/10|بحث ACL، وآلية تسجيل القوالب، ونظام المعايير ذي الأربع طبقات
النقطة الإجمالية: 9.
الخلاصة فجملة وحدة
LLaMA Factory هو إطار مفتوح المصدر لتدقيق الموديلات اللغوية الكبيرة، مبني على بحث ACL 2024، وحاصل على اعتراف المجتمع بحوالي 72 000 نجمة فـ GitHub. الإطار كيتبع مبدأ فصل «الخوارزمية‑الموديل‑البيانات»، وكيقدّم واجهة سطر الأوامر (CLI) وWeb UI بلا كود، وكيتيح تدقيق أكثر من 100 موديل، وبهذا كيهبّط بشكل كبير العتبة التقنية لتدقيق الموديلات الكبيرة. ويمكن استعمالو كبنية تحتية لتطبيقات الموديلات الكبيرة.