

إلى بغيتي تركّب فالحاسوب ديالك إنسان رقمي بالذكاء الاصطناعي كيقدر يسمع، يهضر، ويحرك فمو، ويتحاور معاك، بلا ما تستعمل أدوات الذكاء الاصطناعي ولا تخلّص اشتراكات غالية، تقدر تربط بين التعرّف على الصوت، ونموذج لغوي محلي، وتركيب الصوت، ومزامنة حركة الفم، وتحصل على نظام تفاعلي فوري خدام فالحاسوب ديالك.
فهاد المقال، غادي نبداو من تجهيزات الهاردوير ونديرو النشر كامل فبيئة Windows + WSL2. النتيجة النهائية هي: صفحة ويب فيها الإنسان الرقمي اللي صمّمتي، وكتتحاور معاه بالميكروفون، وهو كيجاوبك بصوت مستنسخ من الصوت ديالك.
أولا: كيفاش خدام النظام كامل
هاد الحل ما كيعتمدش على موديل واحد، ولكن على مجموعة ديال المكوّنات:
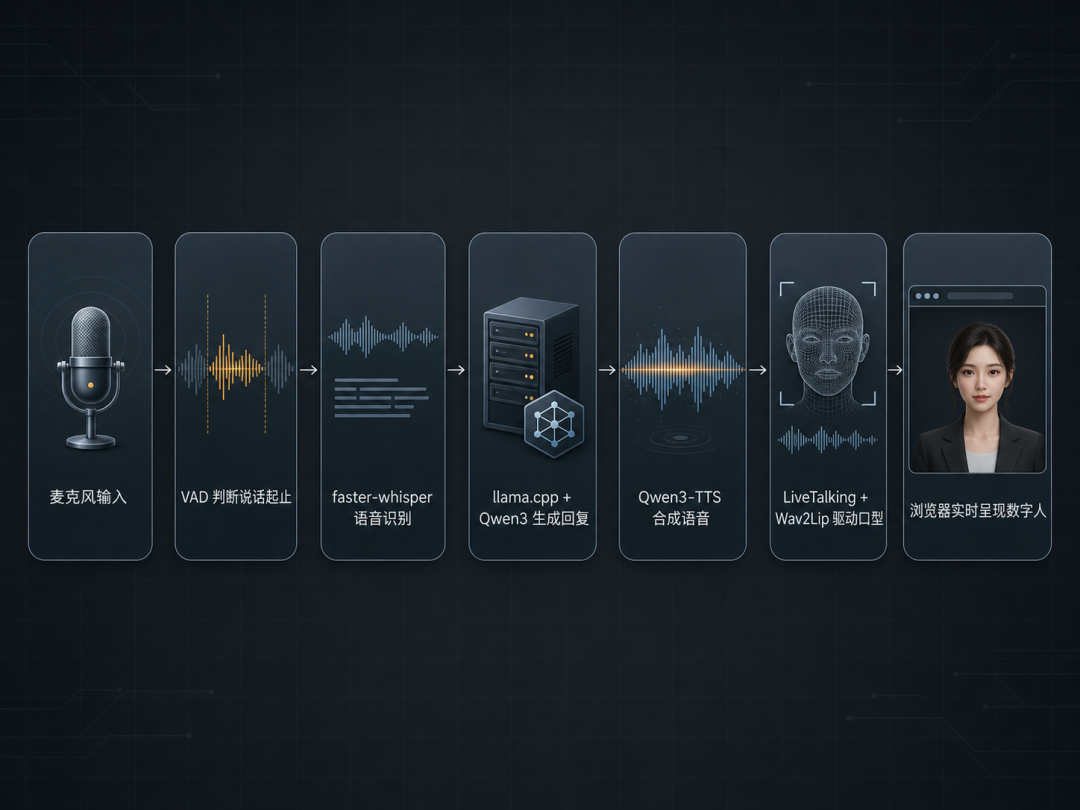
llama.cpp مسؤول على تشغيل النموذج اللغوي المحلي؛ وfaster-whisper كيحوّل كلام المستخدم لنص؛ وQwen3-TTS كينتج صوت الجواب اعتمادا على الصوت المرجعي؛ أما LiveTalking وWav2Lip فكيحوّلو الصوت لحركات فم متناسقة معاه.
ثانيا: متطلبات الهاردوير وحساب ذاكرة الفيديو
الحد الأدنى:
بطاقة NVIDIA: ذاكرة فيديو 8GB
الرام: 16GB
المساحة المتاحة فالقرص: 60GB على الأقل
النظام: Windows 10/11، مع دعم WSL2
الإعدادات الموصى بها:
بطاقة NVIDIA: ذاكرة فيديو 16GB أو أكثر
الرام: 32GB أو أكثر
من الأفضل تستعمل SSD لتخزين النماذج وملفات WSL
كمثال، مع نموذج Qwen3 14B بنسخة مضغوطة، غادي تتوزع ذاكرة الفيديو تقريبا هكذا:
المكوّن|الاستهلاك التقريبي لذاكرة الفيديو
Qwen3-14B Q4_K_M|حوالي 9GB
faster-whisper large-v3|حوالي 3GB
Qwen3-TTS 1.7B|حوالي 4GB
Wav2Lip 256|حوالي 1.3GB
المجموع|حوالي 17GB
بطاقة بذاكرة فيديو 24GB غادي تشغّل هاد التركيبة براحة أكثر. أما 16GB، فتقدر تستعمل موديل 8B وتنقص طول السياق؛ وحوالي 8GB، من الأحسن تبدا بموديل 4B ونموذج متوسط للتعرّف على الصوت.
ثالثا: إعداد شبكة وذاكرة WSL2
1. أولا، صايب ملف .wslconfig فمجلد المستخدم ديال Windows:
C:\Users\اسم_المستخدم_ديالك\.wslconfig2. دخل فيه هاد المحتوى:
[wsl2]
memory=32GB
networkingMode=mirrored

[experimental]
hostAddressLoopback=true
تقدر تبدّل memory حسب الرام الفعلية، وعادة يكفي تخصّص من النصف حتى لثلاثة أرباع الذاكرة الفيزيائية. hostAddressLoopback=true مهم بزاف للتواصل عبر WebRTC بين Windows وWSL فالحاسوب نفسه. إلا ما كانش، اتصال WebRTC فالمراحل الجاية غادي يفشل ديما بلا ما يبان السبب؛ والمتصفح غادي يبيّن خطأ فتحليل JSON، ولائحة مرشحي ICE غادي تكون خاوية.
3. من بعد التعديل، نفّذ فـ PowerShell:
wsl --shutdownمنين تعاود تدخل لـ WSL، غادي تولّي الإعدادات خدامة.
رابعا: تشغيل النموذج اللغوي المحلي فـ Windows
1. حضّر llama.cpp
حمّل نسخة llama.cpp المناسبة لـ Windows وفكّ الضغط عليها فمجلد ثابت، مثلا:
E:\llama.cppرابط تحميل النسخة المستقرة: https://pan.quark.cn/s/0073852e4042
2. اختار النموذج حسب ذاكرة الفيديو
نطاق ذاكرة الفيديو|النموذج المقترح|رابط التحميل
16GB أو أكثر|Qwen3-14B-Instruct Q4_K_M|https://pan.quark.cn/s/f48c2144ac71
8–16GB|Qwen3-8B GGUF Q4_K_M|https://pan.quark.cn/s/78b8643f1be3
أقل من 8GB|Qwen3-4B GGUF|https://pan.quark.cn/s/fd588898ccbf
حط الملف .gguf اللي حمّلتيه فـ:
E:\llama.cpp\models3. شغّل خدمة الاستدلال
فـ موجه أوامر Windows، نفّذ:
cd /d E:\llama.cpp
llama-server -m E:\llama.cpp\models\Qwen3-14B-Instruct-Q4_K_M.gguf ^
  -np 1 -c 8192 -fa on --temp 1.0 --top-p 0.95 ^
  --host 0.0.0.0 --port 8090
شنو كيديرو بعض المعاملات:
host 0.0.0.0: كيسمح لـ WSL يوصل لخدمة النموذج فـ Windows؛
c 8192: كيحدّد طول السياق، وكافي للمحادثات القصيرة؛
temp 1.0: كيخلي الأجوبة أقل جمودا؛
port 8090: كيحدّد منفذ الخدمة.
خاص نافذة الأوامر هادي تبقى خدامة. إلا قال لك إن المنفذ مستعمل، ولكن الفحص العادي ما بيّنش حتى عملية، تقدر تشوف واش Hyper-V حاجز المنفذ:
netsh interface ipv4 show excludedportrange protocol=tcpإلا لقيتي تعارض، أسهل حل هو تبدّل المنفذ فخدمة النموذج وفالسكريبت اللي كينادي عليها فآن واحد.
خامسا: صنع صورة الخلفية وفيديو الإنسان الرقمي
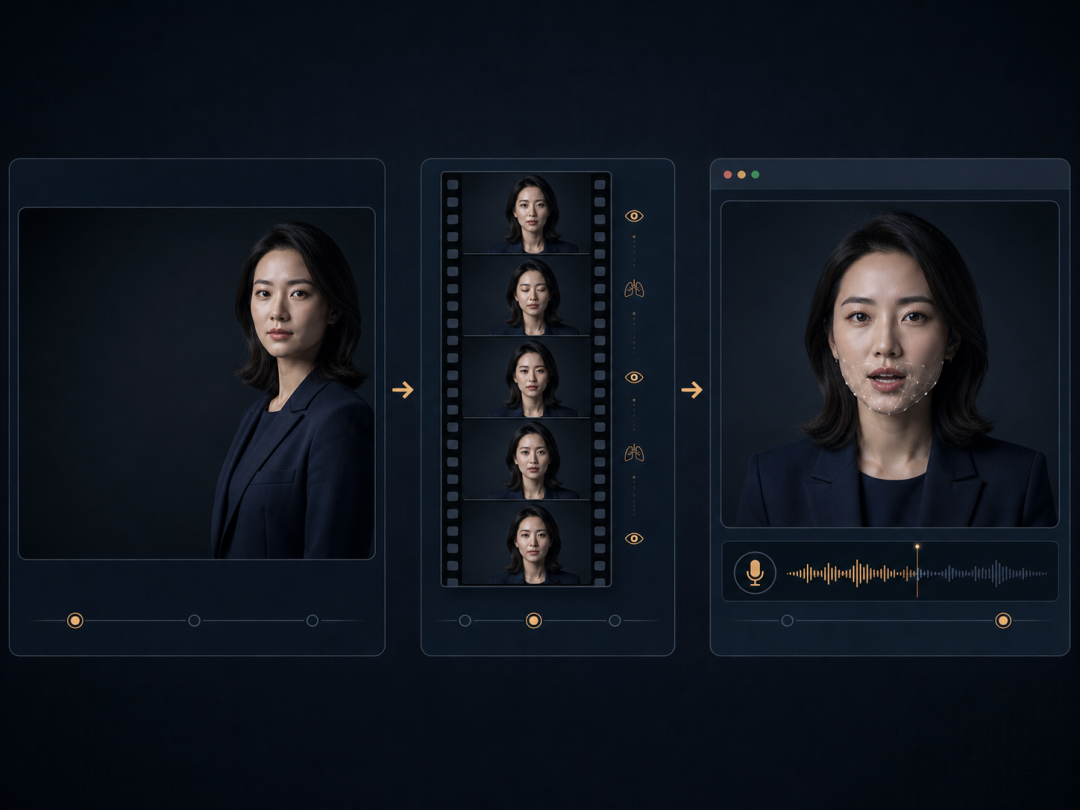
1. صمّم أولا صورة ديال الإنسان الرقمي اللي عجباك
الصورة ما خاصهاش تكون غير زوينة، بل خاصها حتى تخلّي مساحة لتصميم صفحة الويب من بعد ولتوليد حركة الفم. تكوين مستقر نسبيا هو:
استعمل نسبة 16:9؛
خلي الشخصية فالثلث اللي على اليمين؛
خلّي فاليسار مساحة كبيرة ومظلمة باش تحط الكرة الضوئية التفاعلية والترجمة؛
الشفايف تكون مسدودة بشكل طبيعي، بلا ما تبان السنان؛
ما تخليش اليد تغطي الفم أو الذقن أو حدود الوجه؛
استعمل ضوء جانبي خافت باش تنقص الإحساس المزعج اللي ممكن يسببو الضباب الخفيف فجهة الفم.
تقدر تستلهم من هاد الفكرة ديال البرومبت، وبدّل الشخصية واللباس والمشهد كيف بغيتي:
بورتريه جانبي سينمائي بإضاءة منخفضة، امرأة بالغة جالسة فالجهة اليمنى من الصورة، ضوء ناعم على حدود الوجه،
مساحة كبيرة ومظلمة فالجهة اليسرى، تعبير طبيعي، شفايف مسدودة، الكاميرا ثابتة،
ملمس جلد واقعي، تكوين أفقي بنسبة 16:9.
فالكلمات السلبية تقدر تزيد: فم محلول، بروز السنان، الشخصية فالوسط، خلفية مشرقة ومشوشة، يد كتغطي الفم، نص، علامة مائية، جلد بلاستيكي، أسلوب كرتوني.
2. ولّد فيديو ديال الإنسان الرقمي مدته 5 ثواني باستعمال ComfyUI + Wan2.2
حمّل وثبّت ComfyUI، ومن بعد اختار Workflow ديال تحويل الصورة لفيديو الخاص بـ Wan2.2، وخلي الصورة الأساسية هي الإطار الأول. فالمرة الأولى، من الأفضل تستعمل هاد الإعدادات المحافظة:
المعامل|القيمة المقترحة
الدقة|حسب نسبة الصورة الأساسية؛ المثال ديال الدليل الأصلي هو 704 × 896
المدة|5 ثواني
معدل الإطارات|25 fps
Prompt Enhance|موقوف
رابط تحميل ComfyUI: https://pan.quark.cn/s/bb9d21f1e724
البرومبت خاصو يوصف الحركة فقط، وما تعاودش توصف ملامح الشخصية. مثلا:
الشخصية كتبقى فبلاصتها، غير تنفس خفيف، ترمش ببطء مرة وحدة، وتحرك راسها حركة طبيعية وصغيرة بزاف قبل ما ترجع للوضعية الأولى،
الشفايف ديما مسدودة، الكاميرا ثابتة بلا تقريب أو إبعاد أو تحريك.
صدّر الملف وسميه: idle.mp4
حيت حركة الفم الحقيقية ديال الكلام غادي يولّدها Wav2Lip مباشرة، ما كاينش داعي تصايب فيديوهات إضافية بحال «كيهضر» أو «كيصنت».
هادو بعض الأخطاء الشائعة:
ما تفعّلش تحسين البرومبت، وخلي prompt_enhance موقوف، وإلا ممكن النموذج يعاود يصمّم الشخصية أو المشهد؛
خاص نسبة الإخراج تبقى مطابقة لنسبة الصورة الداخلة. إلا استعملتي صورة أفقية بنسبة 16:9، بدّلها لحجم أفقي كيدعمو الـWorkflow، باش ما تتمطّطش الصورة ولا يتقصّ جزء من الشخصية؛
كتب فـالبرومبت الحركة فقط، لأن إعادة وصف المظهر ممكن تخلّي الشخصية تتحرك من بلاصتها؛
فيديو مدته 5 ثواني كافي باش يدير حلقة انتظار، وإطالة الفيديو بلا سبب كتزيد احتمال التكرار أو التشوّه.
سادسا: تسجيل الصوت المرجعي (استنساخ الصوت)
Qwen3-TTS كيقلّد نبرة الصوت وطريقة الكلام اعتمادا على الصوت المرجعي. من الأفضل تسجّل مقطعا مدته 5–15 ثانية، بهاد الشروط:
يكون غير شخص واحد كيهضر؛
المكان هادئ، بلا موسيقى ولا صدى واضح؛
سرعة الكلام طبيعية، والمشاعر تكون قريبة من الأسلوب اللي بغيتي تستنسخ؛
احتافظ كذلك بنص مكتوب مطابق للكلام كلمة بكلمة.
من بعد التسجيل، صدّر الملف (بصيغة wav أو mp3)، وحطّه فمجلد AI فسطح المكتب، وسميه: ref.wav. كتب الكلام اللي قلتي فالتسجيل حرفيا، حيث غادي تحتاج تدخلو فالإعدادات من بعد. وخاصك تعرف أن المشاعر حتى هي كتتستنسخ، لذلك تقدر تستعمل فالتسجيل النبرة اللي بغيتي.
بالنسبة للصوت المرجعي، حمّل «حزمة النشر بنقرة وحدة». هاد السكريبتات كتستعمل لتثبيت بيئة المحادثة الصوتية، وتشغيل الخدمات المختلفة، ومعالجة مزامنة الصوت والصورة. وبما أن السكريبتات ممكن تتبدّل مع إصدارات المشروع، من الأحسن تراجع بسرعة روابط التحميل والمنافذ وأسماء النماذج قبل الاستعمال. الحزمة فيها:
الملف|الاستعمال
install-voice.sh|تثبيت جزء المحادثة الصوتية بنقرة وحدة
start-voice.sh|تشغيل / إيقاف / عرض سجلات الخدمة الصوتية
start-livetalking.sh|تشغيل / إيقاف خدمة حركة الفم
avatar-sync.js|تحويل الصوت + طبقة خلفية الإنسان الرقمي
wav2lip256.pth|أوزان نموذج حركة الفم
wav2lip256_avatar1.tar.gz|الشخصية النموذجية الرسمية (للتحقق من السلسلة)
رابط تحميل حزمة النشر بنقرة وحدة: https://pan.quark.cn/s/d4fc5bfc88eb
سابعا: رتّب الملفات
فالأخير، حط ملف فيديو الإنسان الرقمي ديال 5 ثواني idle.mp4، وملف الصوت ref.wav` معا فمجلد AI فسطح المكتب. البنية النهائية للمجلد:
C:\Users\اسم_المستخدم_ديالك\Desktop\AI\
├── install-voice.sh
├── start-voice.sh
├── start-livetalking.sh
├── avatar-sync.js
├── wav2lip256.pth
├── wav2lip256_avatar1.tar.gz
├── idle.mp4
└── ref.wav
ثامنا: تثبيت WSL2 (Ubuntu 24.04 مع دعم GPU)
حلّ PowerShell بصلاحيات المسؤول:
wsl --update
wsl --install -d Ubuntu-24.04
من بعد ما يكمل التثبيت، عاود شغّل الحاسوب باش يخدم ملف .wslconfig اللي حضّرناه فالخطوة الأولى. من بعد إعادة التشغيل، حلّ Terminal ديال Ubuntu، عيّن اسم المستخدم وكلمة السر، وتأكد من تمرير بطاقة الرسوميات:
nvidia-smiإلا بانت لك معلومات البطاقة والتعريف، فهذا كيعني أن تمرير GPU خدام مزيان.
ما تعاودش تثبّت تعريف بطاقة الرسوميات داخل WSL. التعريف كيتثبت غير فـ Windows، وWSL كيستعمل CUDA اللي كيوفرو النظام المضيف؛ وإعادة تثبيت تعريف البطاقة داخل WSL ممكن تغطي على libcuda.so وتخلي GPU ما يبقاش خدام.
تاسعا: نسخ حزمة التثبيت إلى WSL
فـ Terminal ديال Ubuntu، بدّل المسار باسم مستخدم Windows ديالك:
#النسخ (بدّل المسار باسم المستخدم ديالك):
mkdir -p ~/setup
cp -r "/mnt/c/Users/اسم_المستخدم_ديالك/Desktop/AI/." ~/setup/
cd ~/setup
ls -la

#تحويل نهايات الأسطر:
sudo apt update
sudo apt install -y dos2unix
dos2unix *.sh

#إضافة صلاحيات التنفيذ:
chmod +x *.sh
علاش خاص تحويل نهايات الأسطر: ملفات النصوص ديال Windows كتستعمل غالباً CRLF، وإلا ما تحوّلاتش يقدرو يبانُو أخطاء بحال bash^M ولا bad interpreter، وهاد النقطة كتعطل بزاف ديال الناس.
تشغيل بزاف ديال ملفات Python مباشرة من /mnt/c كيكون غالباً أبطأ، وكيقدر يسبب حتى مشاكل فالصلاحيات. نسخها للمجلد الرئيسي ديال Linux كيكون أكثر استقراراً.
عاشراً، تثبيت وتجريب وحدة المحادثة الصوتية
1. شغّل سكريبت التثبيت
cd ~/setup
./install-voice.sh
عملية التثبيت غادي تنشئ بيئة Python، وتوجد كشف النشاط الصوتي وfaster-whisper وQwen3-TTS ومكونات الواجهة الأمامية. على حساب سرعة الشبكة والقرص الصلب، العملية تقدر تاخذ شي عشر دقايق.
2. وحّد صيغة الصوت المرجعي
ffmpeg -i ~/setup/ref.wav -ac 1 -ar 16000 -c:a pcm_s16le ~/s2s/ref.wav

# تأكد من الصيغة: خاصها تكون pcm_s16le / 16000 / قناة وحدة:
ffprobe -v error \
  -show_entries stream=sample_rate,channels,codec_name \
  -show_entries format=duration \
  -of default=nw=1 ~/s2s/ref.wav
خاص نتيجة الفحص تكون مستوفية لهاد الشروط:
الترميز: pcm_s16le
معدل أخذ العينات: 16000
القنوات: مونو
3. دخل النص الحرفي ديال الصوت المرجعي
بدّل النص اللي تحت بالمحتوى اللي تقال فعلاً فالتسجيل:
sed -i 's|^REF_TEXT=.*|REF_TEXT="كتب هنا النص الحرفي المطابق تماماً للتسجيل"|' ~/setup/start-voice.sh
grep -n "^REF_TEXT=" ~/setup/start-voice.sh
إلا كان النص الحرفي ناقص فيه شي كلمات، ولا فيه أخطاء، ولا اختلاف كبير فالتنقيط، غادي تنقص جودة الاستنساخ.
4. التشغيل الأول
cd ~/setup
./start-voice.sh
ومن بعد حلّ فمتصفح Windows:
http://localhost:7860/سمح للمتصفح يستعمل الميكروفون، وكليكي على زر التفاعل فالصفحة باش تجرّب. فالمرة الأولى من الأفضل تدخل للإعدادات، وتهبط NOISE GATE لأقصى اليسار ولا تسدو مباشرة، حيث إلا ما درتيش هكا حتى الهضرة العادية تقدر تتحسب ضجيجاً فالخلفية وتتصفّى.
حادي عشر، تثبيت LiveTalking (مزامنة حركة الفم) وWav2Lip
حلّ ترمينال جديد ديال Ubuntu، ودخل لـ WSL، ومن بعد نفّذ الأوامر بالترتيب:
mkdir -p ~/livetalking
cd ~/livetalking
git clone https://github.com/lipku/LiveTalking.git
cd LiveTalking

uv venv --python 3.10 .venv-lt
source .venv-lt/bin/activate

uv pip install torch==2.5.0 torchvision==0.20.0 torchaudio==2.5.0 \
  --index-url https://download.pytorch.org/whl/cu124

uv pip install -r requirements.txt
sudo apt install -y ffmpeg libgl1 libglib2.0-0
إلا ما كانش uv مثبت فالنظام، ثبّتو أولاً باتباع تعليمات التثبيت الرسمية ديالو، ومن بعد عاود نفّذ الأوامر اللي فوق.
حطّ نموذج حركة الفم والإنسان الرقمي الافتراضي:
cd ~/livetalking/LiveTalking

# انتبه: خاص الاسم يتبدل لـ wav2lip.pth
cp ~/setup/wav2lip256.pth models/wav2lip.pth

# الشخصية النموذجية الرسمية
tar -xzf ~/setup/wav2lip256_avatar1.tar.gz -C data/avatars/

# تأكد
ls -lh models/ && ls data/avatars/
مهم: الملف الأصلي سميتو wav2lip256.pth، ولكن من بعد النسخ خاص الاسم يكون wav2lip.pth، حيث المشروع كيقلب افتراضياً على الأوزان بهاد الاسم.
جرّب أولاً الإنسان الرقمي النموذجي الرسمي:
cd ~/livetalking/LiveTalking
source .venv-lt/bin/activate

python app.py --transport webrtc --model wav2lip \
  --avatar_id wav2lip256_avatar1 \
  --stun 'stun:stun.l.google.com:19302'
حلّ فالمتصفح:
http://localhost:8010/index.htmlمن بعد ما ينجح الاتصال، صيفط نص بالصينية. إلا بان الصوت وحركة الشخصية ومزامنة حركة الفم فالنفس الوقت، فهاد المرحلة دازت بنجاح فعلاً.
تقدر تستعمل inferfps وfinalfps اللي فالسجل ديال الترمينال باش تراقب الأداء فالوقت الحقيقي. غالباً كنتمناو بجوج يوصلو لحوالي 25 ولا أكثر. إلا كان inferfps ناقص بوضوح، خاصك تنقص حمل النموذج ولا تبدّل لإعداد أخف.
الكثير من الشروحات فالإنترنت كتنصح بـ MuseTalk؛ الجودة ديالو أحسن، ولكن متطلبات الصورة ديال الإنسان الرقمي فهاد المرة ماشي كبيرة. استهلاك الذاكرة ديالو غير حوالي 1.3GB، وبالنسبة للصور اللي فيها إضاءة ضعيفة أو وجه جانبي أو الشخصية ما كتاخذش مساحة كبيرة، نقدروا نوصلو لنتيجة مقبولة بتكلفة قليلة، بينما MuseTalk كيستهلك 12G من الذاكرة. وزيد على هاد الشي، النشر المحلي بالكامل ما كيحتاجش stun، ولكن ما تستعملش سلسلة فارغة، حيث WebRTC يقدر يفشل فالتشغيل بسبب صيغة عنوان STUN غير صحيحة.
ثاني عشر، حوّل الفيديو لشخصية رقمية ديالك
وأثناء تشغيل LiveTalking حلّ:
http://localhost:8010/avatar.htmlقدّم مهمة الإنشاء بهاد الطريقة:
الخوارزمية: Wav2Lip
Avatar ID: wav2lip256_myavatar (خلي البادئة wav2lip256_)
ملف الفيديو: idle.mp4 اللي تخلق من قبل
منين تولّي الحالة COMPLETED، شغّل الإنسان الرقمي ديالك:
cd ~/setup
AVATAR_ID=wav2lip256_myavatar ./start-livetalking.sh
إلا بغيتيه يتشغل افتراضياً من بعد، بدّل Avatar ID فالسكريبت:
sed -i 's/wav2lip256_lingdu/wav2lip256_myavatar/' ~/setup/start-livetalking.shإلا بان تمزق واضح حدّ الفم من بعد الإنشاء، فالأولوية هي تفقد واش اليدين ولا الشعر ولا الياقة كيغطيوا الفم والذقن بشكل متكرر ففيديو الانتظار، وما تستعجلش تبدّل النموذج.
ثالث عشر، شغّل النظام كامل بالترتيب الصحيح
المجموعة كاملة ديال الخدمات كتحتاج لثلاث نوافذ ديال الترمينال.
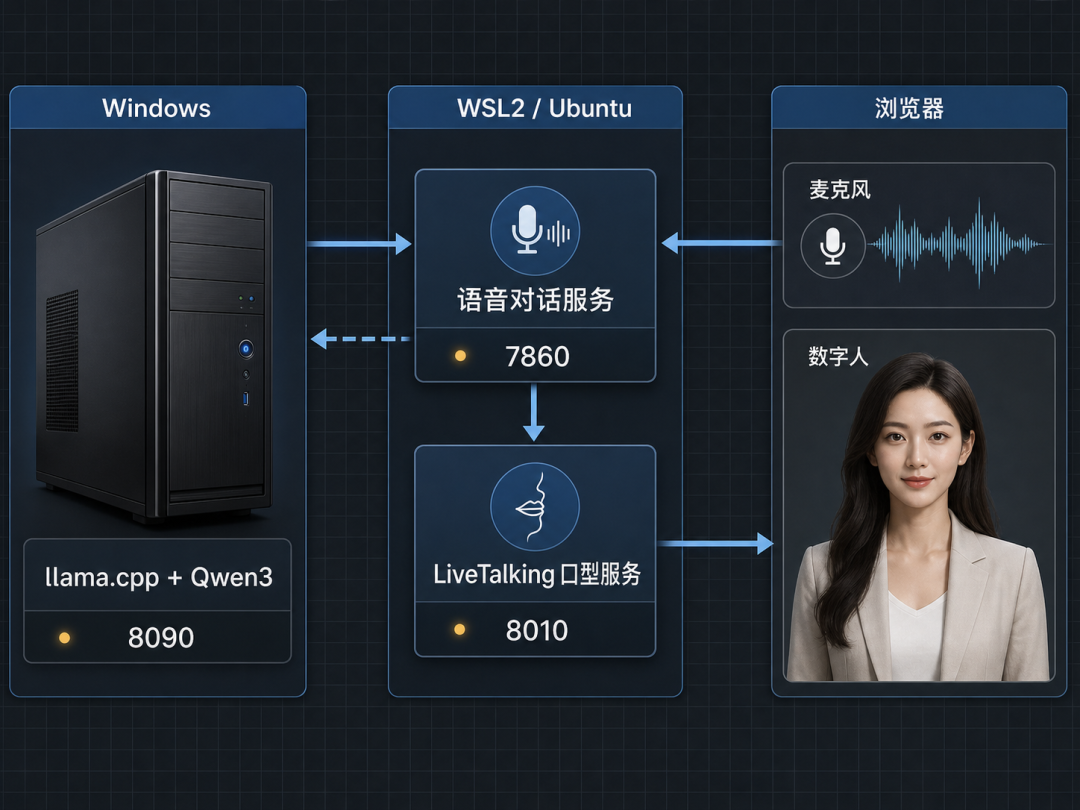
النافذة الأولى: النموذج المحلي الكبير ديال Windows
cd /d E:\llama.cpp
llama-server -m E:\llama.cpp\models\Qwen3-14B-Instruct-Q4_K_M.gguf ^
  -np 1 -c 8192 -fa on --temp 1.0 --top-p 0.95 ^
  --host 0.0.0.0 --port 8090
النافذة الثانية: خدمة حركة الفم ديال WSL
cd ~/setup
./start-livetalking.sh
النافذة الثالثة: خدمة الصوت ديال WSL
cd ~/setup
./start-voice.sh
فالأخير حلّ http://localhost:7860/، وإذا لزم الأمر ضغط Ctrl + F5 باش تدير تحديث إجباري. كليكي أولاً فالصفحة باش الإنسان الرقمي يدير الاتصال، ومن بعد كليكي على زر التفاعل الصوتي وبدا الهضرة.
باش تسدّ الخدمات نفّذ:
./start-voice.sh stop
./start-livetalking.sh stop
نافذة llama.cpp ديال Windows تقدر توقفها مباشرة بالضغط على Ctrl + C.
رابع عشر، إعداد شخصية طبيعية وبزمن استجابة قصير
فصفحة الويب، دخل لـ Settings → INSTRUCTIONS وكتب مواصفات الشخصية. ما تكتفيش غير بتكديس صفات بحال «حنون، نشيط، كيتفهم الآخرين»، والأفضل تزيد معاها شي أمثلة ديال محادثات قصيرة باش يتعلم النموذج إيقاع الرد.
تقدر تستعمل هاد القيود:
أنت رفيق افتراضي طبيعي وودود. هضر بطريقة عامية، وجاوب كل مرة غير بجوج ولا ثلاثة ديال الجمل.
ما تستعملش Markdown ولا لوائح ولا ترقيم ولا رموز تعبيرية ولا أوصاف ديال الحركات المسرحية.
ما تعاودش صياغة سؤال المستخدم، جاوب مباشرة. إلا كانت شي معلومة ماشي مؤكدة، وضّح هاد الشي بصراحة.

مثال:
المستخدم: اليوم حاس براسي عيان شوية.
المساعد: ما تضغطش على راسك باش تخدم بكامل الطاقة. شرب شوية دالما وارتاح عشر دقايق، ومن بعد نعالجو الأمر بشوية بشوية.
الردود القصيرة ما كتخليش الحوار يبان حقيقي أكثر فحسب، بل كتقصّر بوضوح الوقت اللازم لانتظار تركيب الصوت كامل. تعطيل Markdown والرموز التعبيرية الهدف منو هو منع TTS من قراءة الرموز ولا علامات التنسيق. /no_think كتستعمل لإيقاف الاستدلال الطويل غير الضروري، وبالتالي تنقيص التأخر قبل الجملة الأولى.
خامس عشر، نقص المقاطعة والدخول فالهضرة
أصعب حاجة فالإعداد ديال نظام الصوت الفوري غالباً ماشي هي النموذج، ولكن «إمتى نعتابرو المستخدم سالا الهضرة». فالهضرة بالصينية كاينين بزاف ديال الوقفات فالوسط، وإلا كان الحكم على الصمت قصير بزاف غادي يبدا النظام يقاطع بزاف.
تقدر تجرّب هاد المعاملات فـ ~/setup/start-voice.sh:
MIN_SILENCE_MS=1200
VAD_THRESH=0.6
MIN_SPEECH_MS=500
SPEECH_PAD_MS=300
معاني المعاملات:
MIN_SILENCE_MS: شحال خاص من الصمت باش تتحسب الجملة سالات؛ بدا بـ 1200ms، وإلا حسّيتي بالاستجابة بطيئة نقصها لـ 900ms؛
VAD_THRESH: عتبة النشاط الصوتي؛ فالجو المزعج تقدر تطلعها لـ 0.7؛
MIN_SPEECH_MS: تصفية الأصوات القصيرة بزاف؛
SPEECH_PAD_MS: الاحتفاظ بشوية ديال التخزين المؤقت قبل الصوت ومن بعدو، باش ينقص تقطيع الكلمات.
راقب السجل:
tail -f ~/s2s/logs/s2s.log | grep -E "soft-ended|discard"إلا بدّلتي المعاملات وبقى سلوك السجل ما تبدلش نهائياً، فعادةً المشكل ماشي فأن المعاملات ما خداماش، ولكن فأن الخدمة ما تعاوداتش تشغلات فعلياً.
سادس عشر، كيفاش تنقص الحمل إلا ما كفاتش ذاكرة GPU
بالترتيب من الأكثر فائدة للأقل، جرّب هاد الخطوات:
بدّل Qwen3-14B بـ Qwen3-8B، وتقدر توفّر تقريباً 3GB؛
بدّل لـ Qwen3-4B، وتقدر توفّر تقريباً 6GB؛
بدّل نموذج التعرف على الكلام لـ `medium`، وتقدر توفّر حوالي 1.5GB؛
نقص سياق llama.cpp من `-c 8192` لـ `-c 4096`، وغادي توفّر حتى حوالي 1GB؛
خلي Wav2Lip، وما تبدلوش بنموذج أثقل لحركة الفم ملي تكون الذاكرة مضغوطة.
محادثة الصوت فكل دورة كتكون غالباً غير جوج ولا ثلاثة ديال الجمل. الفرق بين 14B و8B فـ«الإحساس بالصوت» ماشي بالضرورة أكبر من الفرق فالتجربة اللي كيسببو وقت الانتظار. ملي تكون الذاكرة قليلة، عطِ الأولوية للاستقرار وقلة التأخر.
سابع عشر، دليل سريع للأعطال الشائعة
المشكل|السبب وطريقة المعالجة
bad interpreter ولا كيبان ^M|السكريبت فيه أسطر بنمط Windows، نفّذ `dos2unix *.sh
WebRTC ما كيتاصلش نهائياً|راجع `hostAddressLoopback=true` فـ `.wslconfig`، ومن بعد نفّذ `wsl --shutdown`
الصفحة كتعطي خطأ فـ تحليل JSON|غالباً الواجهة الخلفية رجّعات خطأ 500، خاصك تشوف الخطأ الحقيقي فـ التيرمينال اللي تشغّل فيه الخدمة
malformed/uri:invalid scheme|عنوان STUN خاوي ولا مكتوب بطريقة غير صحيحة، دخّل عنوان `stun:` صالح
الصفحة كتتحل ولكن الكلام ما كيردّش|سدّ ولا نقص NOISE GATE، وتأكد باللي المتصفح واخد صلاحية الميكروفون
الشخصية الرقمية كتقاطع بزاف|طلّع `MIN_SILENCE_MS`، ومن الأحسن تبدا من 1200ms
الجواب ما عندوش علاقة بالسؤال|عالج أولاً التقطيع الغلط ديال الكلام، وتأكد باللي ما كايناش جوج عمليات ديال التفريغ الفوري خدامة وكتتعارض
الصوت كيتبدل بزاف من مرة لمرة|تأكد واش كتستعمل موديل TTS Base، وراجع الصوت المرجعي والنص المكتوب حرفياً
الصوت بحال إلا تبدلات نبرتو|راجع إعدادات معدل أخذ العينات فـ `avatar-sync.js`، وغالباً خاصها تكون متوافقة مع صوت 16000Hz
فشل ربط المنفذ ولكن ما لقيتي حتى عملية|شوف نطاق المنافذ المحجوزة ديال Hyper-V، وبدّل لمنفذ ماشي محجوز
الـGPU عامر ولكن ما كاين حتى تقدم لمدة طويلة|ممكن تكون ذاكرة الفيديو رجعات لذاكرة النظام؛ نقص حجم الموديل، ولا راجع فـ لوحة تحكم NVIDIA سياسة رجوع CUDA لذاكرة النظام
ما كاينش الميكروفون ملي كتستعمل IP ديال الشبكة المحلية|المتصفح غالباً كيشترط localhost ولا HTTPS باش يسمح بالوصول للميكروفون
الخدمة كتتعطل من بعد ما الكمبيوتر كيفيق من السكون|نفّذ `wsl --shutdown` ومن بعد عاود شغّل الخدمات الثلاثة
ملي كتعاد التشغيل كيبان بأن المنفذ مستعمل|شغّل أولاً جوج أوامر `stop`، وتأكد باللي العمليات القديمة سالات قبل ما تعاود التشغيل
十八、اختياري: دير سكريبت للتشغيل بضغطة وحدة
من بعد ما تتأكد باللي الخدمات الثلاثة كل وحدة خدامة بوحدها وباستقرار، تقدر تنشئ فـ Windows ملف start-ai-avatar.bat:
@echo off
start "llama-server" cmd /k "cd /d E:\llama.cpp && llama-server -m E:\llama.cpp\models\Qwen3-14B-Instruct-Q4_K_M.gguf -np 1 -c 8192 -fa on --temp 1.0 --host 0.0.0.0 --port 8090"
timeout /t 25

start "livetalking" wsl -d Ubuntu-24.04 -- bash -lc "cd ~/setup && ./start-livetalking.sh"
timeout /t 30

start "voice" wsl -d Ubuntu-24.04 -- bash -lc "cd ~/setup && ./start-voice.sh"
timeout /t 10

start http://localhost:7860/
خاصك تضبط مدة الانتظار على حساب الكمبيوتر ديالك. فـ أول عملية نشر، ما تعتمدش مباشرة على سكريبت المعالجة الدفعية، حيث إلا فشلات شي خطوة غادي يكون صعيب تعرف شنو هي الخدمة اللي فيها المشكل.
十九、الولوج من الهاتف ومشاكل فتح الخدمة للإنترنت
الميكروفون ديال المتصفح صلاحية حساسة. ملي كتفتح الصفحة باستعمال IP عادي ديال الشبكة المحلية، المتصفح يقدر يرفض الإذن حيث الصفحة ماشي فـ سياق آمن. تقنياً تقدر تستعمل أدوات بحال Cloudflare Tunnel باش تربط الصفحة المحلية بعنوان HTTPS، مثلاً:
cloudflared tunnel --url http://localhost:7860ولكن هاد الشي كيعني حتى أن الخدمة المحلية تقدر تولّي قابلة للوصول من الإنترنت. ما تنشرش عنوان مؤقت بلا مصادقة، وبالخصوص ما تعرّضش مباشرة خدمة فيها أصوات خاصة، وسجلات المحادثات، ومواد مصورة للإنترنت. إلا احتجتي تستعملها عن بُعد، خاصك على الأقل تزيد التحكم فـ الولوج، وتسدّ النفق من بعد ما تسالي.
二十、كيفاش تعرف واش النشر نجح بصح
ما تعتبرش “الصفحة كتتحل” معياراً كافياً لإتمام العملية. من الأحسن تدير الاختبار بهاد الترتيب:
1. منفذ 8090 ديال llama.cpp كيولّد بشكل عادي أجوبة بالصينية؛
2. صفحة الصوت كتتعرف على إدخال الميكروفون وكتردّ بصوت مركّب؛
3. الشخصية النموذجية ديال LiveTalking كتخرج الصوت وكتولّد حركة فم متوافقة؛
4. فيديو الانتظار المخصص كيتحوّل بنجاح لـ Avatar؛
5. من بعد ربط الخدمات الثلاثة، الانتظار قبل الجملة الأولى كيكون تقريباً 1–2 ثانية، والمحادثة المتواصلة ما فيهاش مقاطعة متكررة؛
6. أثناء التشغيل لمدة طويلة، ذاكرة الفيديو ما كتطلعش باستمرار، وأوامر إعادة تشغيل الخدمة وإيقافها خدامة مزيان.
التأخير ديال جواب واحد غالباً كيتجمع من مراحل متعددة: التعرف على الكلام، أول token ديال الموديل اللغوي، تركيب الصوت، استدلال حركة الفم، وزيد عليهم التخزين المؤقت حتى يكمل الصوت. إلا بغيتي تحسّن التجربة، بدا أولاً من السجلات باش تعرف شنو هي المرحلة الأبطأ، وما تبدلش جميع الموديلات بشكل عشوائي.
الخلاصة:
الجانب المثير فعلاً فـ هاد الحل ماشي غير “نخليو صورة تهضر”، بل هو ربط عدة وحدات محلية ديال الذكاء الاصطناعي فـ سلسلة كاملة ديال التفاعل الفوري. تقدر تستعملو كرفيق افتراضي، وتقدر حتى تحوّلو لمرشد فـ قاعة عرض، أو مساعد صوتي لسطح المكتب، أو شخصية رقمية للبث المباشر، أو نموذج أولي لشخصية.
فـ أول عملية نشر، أحسن استراتيجية هي التحقق مرحلة بمرحلة: شغّل أولاً الموديل اللغوي، من بعد جرّب الصوت، ثم راجع حركة الفم، وفـ الأخير بدّل للشخصية المخصصة. إلا كان لكل خطوة معيار نجاح واضح، حتى النظام المعقد يقدر يتقسم لمجموعة ديال المشاكل الصغيرة اللي ساهل نحددوها ونعيدو إنتاجها.
ونعاودو نذكروك مرة أخرى: شكل الشخصية الرقمية وصوتها يقدرو يمسّو بحقوق الأشخاص. قبل الاستعمال فـ عرض عمومي ولا لغرض تجاري، ضروري تحصل على ترخيص من مالكي حقوق المواد، وتوضح بشكل صريح باللي هاد المواد كتستعمل فـ نظام ذكاء اصطناعي للتفاعل والحوار مع الشخصية.