

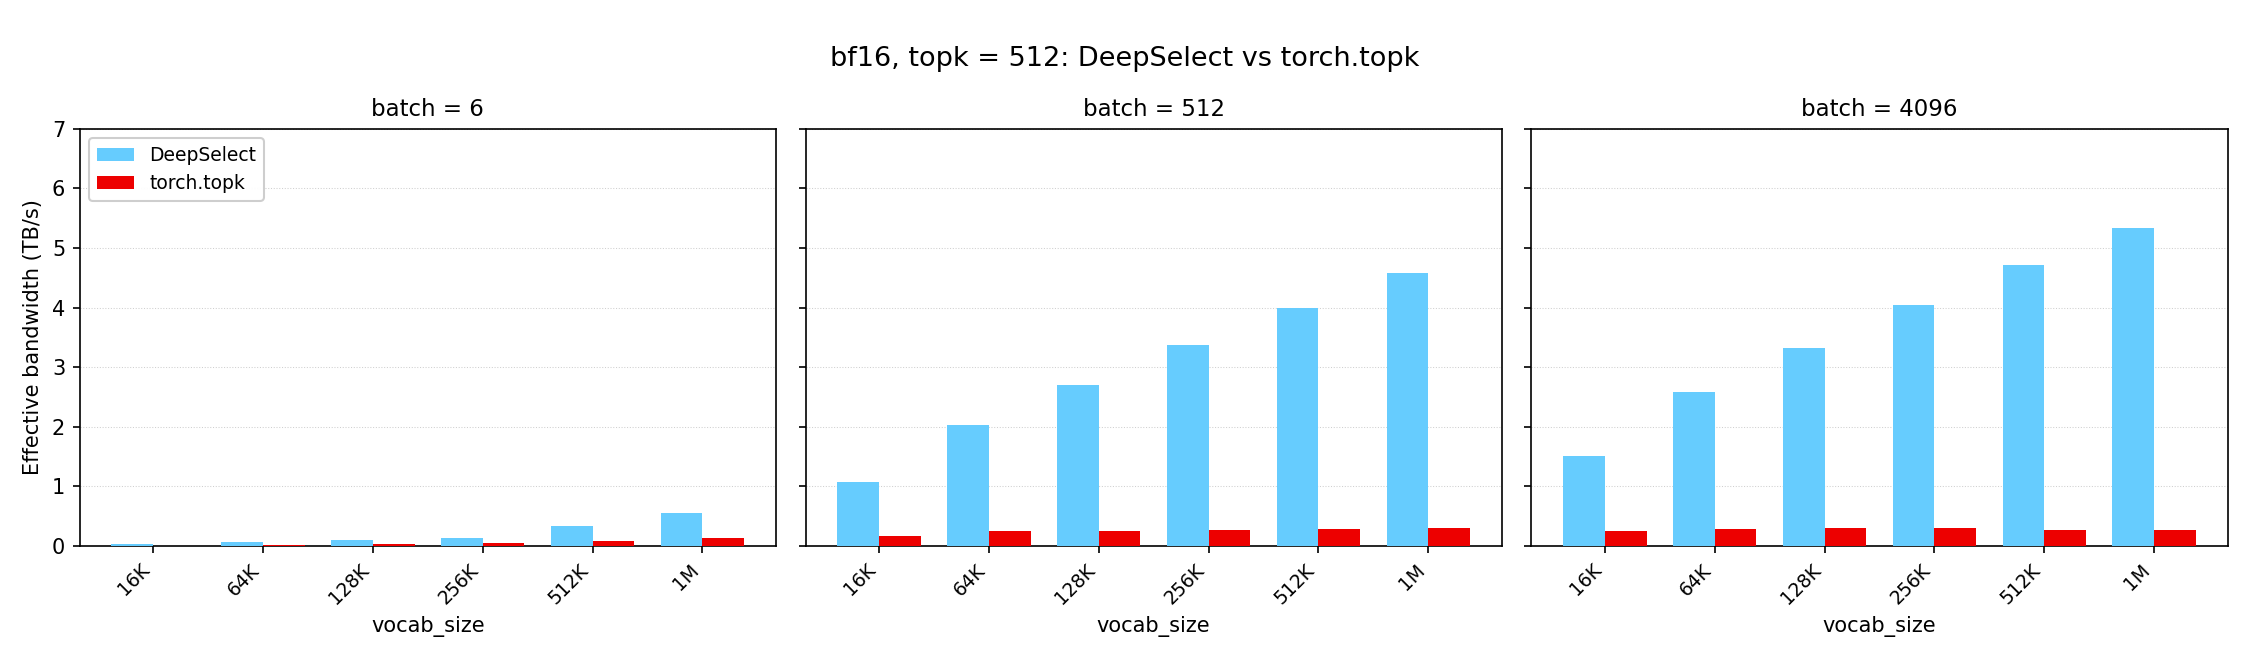
شنو هو DeepSelect؟
DeepSelect هو تطبيق عالي الأداء ديال نواة TopK المستعملة فـ DeepSeek Sparse Attention وأخذ العينات. حسب README ديال المشروع، يقدر يحقق تسريع من 2 حتى لـ 20 مرة مقارنةً بـ torch.topk العادي، بالنسبة لأحمال الخدمة اللي كتدعمها المكتبة.
بلا ما يحاول يحسّن جميع إعدادات TopK الممكنة، كيركّز DeepSelect على جوج ديال السيناريوهات: حمل Lightning Indexer باستعمال مدخلات torch.bfloat16، وحمل أخذ العينات باستعمال مدخلات torch.float32.
أحمال الخدمة المدعومة
سيناريو Lightning Indexer
- نوع المدخلات:
torch.bfloat16 - حجم الدفعة: من 1 فما فوق، مع تحسينات للدفعات الصغيرة والكبيرة
- حجم القاموس: من 1 فما فوق، مع تحسينات للقواميس الصغيرة والكبيرة
- حجم TopK: صغير وما يفوتش
4096
باش تحصل على أداء أحسن، خلّي sorted_index معطّل إلا إلى كان خاص النتائج تكون مرتّبة. إلا ما كانتش القيم ضرورية، عيّن return_value=False باش تتخطّى إخراجها.
سيناريو أخذ العينات
- نوع المدخلات:
torch.float32 - حجم الدفعة: من 1 فما فوق
- حجم القاموس: تقريباً 128K
- حجم TopK: صغير وما يفوتش
4096
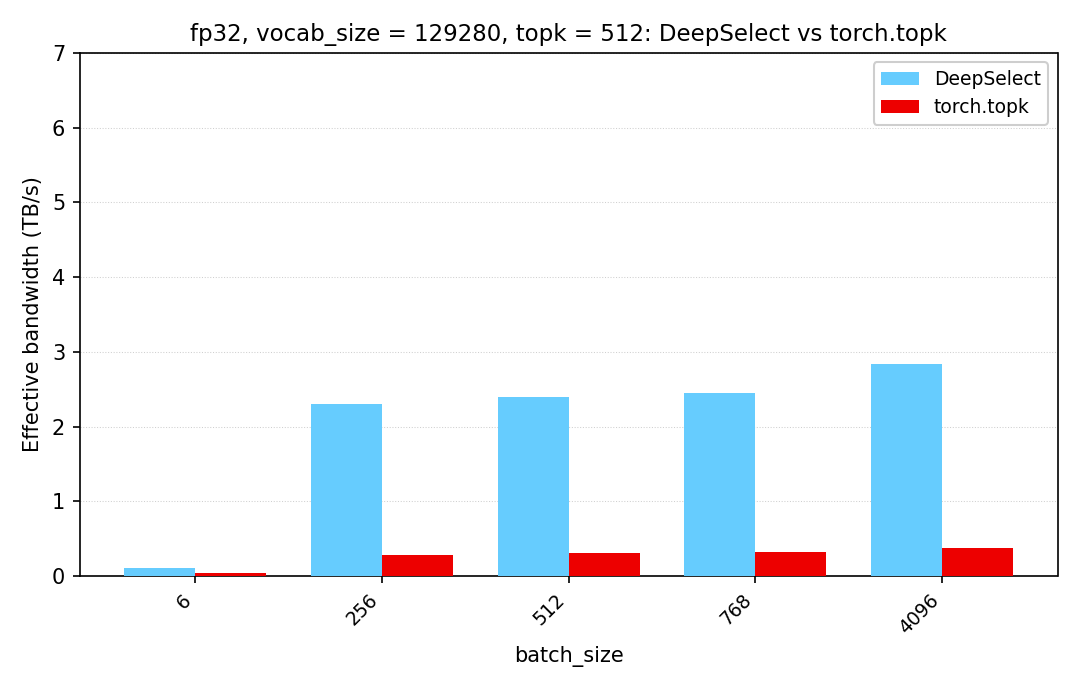
المستودع كيقيّس الأداء باستعمال عرض النطاق الترددي الفعلي ديال الذاكرة، ماشي معدل العمليات بالفاصلة العائمة، حيث إن TopK ما كيدير حتى عملية حسابية بالفاصلة العائمة. والاختبار ديالو كيعرض الأداء مقارنةً بـ torch.topk على نفس المدخلات.
الخصائص الرئيسية
- نوى TopK متخصصة لأحمال DeepSeek Sparse Attention وأخذ العينات
- دعم مدخلات
torch.bfloat16وtorch.float32فـ السيناريوهات المستهدفة ديال كل نوع - إمكانية اختيار إخراج الفهارس بنوع
torch.int32أوtorch.int64 - إخراج اختياري للقيم لتقليل الحمل ملي كتكون الفهارس بوحدها كافية
- صفوف بأطوال مختلفة باستعمال حد أعلى حصري لكل صف
- مخازن إخراج الفهارس كيتكلف بها المستخدم
- التحقق المدمج من قيم NaN
التثبيت
نسخ المستودع، وتهيئة الوحدات الفرعية ديالو، وثبّت الحزمة من مجلد المشروع:
git clone https://github.com/deepseek-ai/DeepSelect.git
cd DeepSelect
git submodule update --init --recursive
pip install -v .
الأمثلة كتستعمل موترات CUDA، لذلك أنشئ المدخلات باستعمال device="cuda".
الاستعمال الأساسي ديال TopK
استورد PyTorch وDeepSelect، وأنشئ موتر إدخال ثنائي الأبعاد، ومن بعد عيّط لـ deep_select.topk:
import torch
import deep_select

batch_size = 4
vocab_size = 204800
topk = 1024

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.bfloat16,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=True,
    indices_type=torch.int32,
    return_value=True,
)

print(values.shape)   # (4, 1024)
print(indices.shape)  # (4, 1024)
خاص المدخل يكون بالشكل (batch_size, vocab_size). البعد الأخير خاصو يكون متجاوراً، وخطوة الصف خاصها تكون من مضاعفات عدد البايتات اللي كيرجعها deep_select.get_stride_requirement()[0].
القيم المرجعة عندها نفس نوع البيانات ديال x. الفهارس كتستعمل النوع المحدد عبر indices_type، اللي يقدر يكون torch.int32 أو torch.int64. مع sorted_index=True، الفهارس المرجعة ديال كل صف كتكون مرتبة تصاعدياً.
إرجاع الفهارس فقط
إلا ما كانش الكود اللي من بعد محتاج للقيم المختارة، عطّل إخراج القيم:
values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=False,
    indices_type=torch.int32,
    return_value=False,
)
كيذكر README أن تخطّي إخراج القيم أسرع تقريباً بـ 10%. تجنّب طلب الإخراج المرتّب إلا إلى كان الترتيب ضروري، حيث إن الفرز كيزيد الحمل.
التعامل مع محاذاة الخطوات
DeepSelect كيفرض متطلبات ديال المحاذاة على صفوف الإدخال وصفوف الإخراج. فحصها وقت التشغيل:
input_alignment, output_alignment = deep_select.get_stride_requirement()

print("Input row-stride alignment:", input_alignment, "bytes")
print("Output row-stride alignment:", output_alignment, "bytes")
إلا ما كانتش خطوة صف واحد المدخل من مضاعفات محاذاة الإدخال المطلوبة، زِد حشوة للموتر قبل ما تمرّرو لـ DeepSelect. خاص البعد الأخير يبقى متجاوراً.
DeepSelect كيمدّد مخرجيْن بجوج بشكل افتراضي. الخطوات ديالهم كتكون محاذاة على deep_select.get_stride_requirement()[1] بايت، وهاد الشي كيعني أن الموترات المرجعة ممكن ما تكونش متجاورة. الكود اللي كيستهلك المخرجات ما خاصوش يفترض خطوات متجاورة قياسية.
استعمال مخزن فهارس موجود
الواجهة كتقبل output_idx= ملي خاص الفهارس تكتب فـ مخزن كيتكلف به المستدعي. خاص هاد المخزن يستوفي نفس متطلب خطوة الإخراج. راجع deep_select/interface.py باش تشوف التوقيع الكامل للدالة قبل ما تهيّئ مخزناً مخصصاً.
التعامل مع الصفوف بأطوال مختلفة
استعمل end باش تعيّن لكل صف حداً أعلى حصرياً. هاد الشي مفيد ملي كتكون الصفوف اللي فـ نفس الدفعة عندها أطوال صالحة مختلفة:
import torch
import deep_select

batch_size = 2
vocab_size = 129280

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.float32,
    device="cuda",
)

end = torch.tensor(
    [129280, 100000],
    dtype=torch.int32,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    1000,
    end=end,
    sorted=True,
    indices_type=torch.int64,
)
هنا، الصف اللول يقدر يستعمل العناصر كاملين ديال 129280، بينما الصف الثاني محدود غير فـ اللولين 100000 عنصر. إلا كان شي صف أقصر من الحجم المطلوب ديال TopK، DeepSelect كيعمر المخرجات ديالو بـ value_oob_fill_value وidx_oob_fill_value.
التعامل مع NaN
التحقق من NaN ديما مفعّل. افتراضياً، abort_when_nan_found=True، وبهذا النواة كتنادي على trap() وكتوقف ملي كتكتاشف NaN. الصفوف اللي الطول الصالح ديالها أقل من أو كيساوي الحجم المطلوب ديال TopK ما كيتدارش ليها التحقق من NaN.
تحقق من بيانات الإدخال أو نقّيها قبل ما تطلق النواة إلا كان ممكن تكون فيها NaN، خصوصاً إلا خليتي سلوك التوقيف الافتراضي مفعّل.
الأداء ونصائح متقدمة
- بقا داخل النطاق المدعوم ديال TopK. DeepSelect كيدعم قيم TopK الصغيرة حتى لـ
4096، شاملة. القيم الأكبر ما مدعومّاش. - طابق الحمل المستهدف. استعمل
torch.bfloat16فحالة Lightning Indexer، وtorch.float32فحالة أخذ العينات الموصوفة فالمشروع. - تجاوز الترتيب إلا أمكن. الترتيب حسب الفهرس أو القيمة كيكلّف فالأداء، لذلك طلبو غير ملي تكون المعالجة اللاحقة محتاجاه.
- تجاوز القيم إلا أمكن. عيّن
return_value=Falseملي غير الفهارس هي اللي غادي تستعمل. - تحقق من المحاذاة بكري. خطط لأشكال التنسورات والحشو اعتماداً على
get_stride_requirement()، عوض ما تصلح التنسورات غير المتوافقة فحلقة حساسة للأداء. - ما تفترضش أن المخرجات متجاورة. DeepSelect كيحاذي strides ديال الصفوف فالمخرجات، والتنسورات الناتجة تقدر ما تكونش متجاورة.
- دير benchmark بالشكل الحقيقي. أداء TopK كيعتمد على نوع الإدخال، وحجم الدفعة، وحجم المفردات، وحجم TopK. جرّب نفس الإعداد بالضبط اللي كيستعملو التطبيق.
تشغيل الـ benchmark المرفق
المستودع فيه وضعية ديال قياس الأداء فسكريبت الاختبارات ديالو:
python3 tests/test.py --perf-onlyهاد الـ benchmark كيقارن DeepSelect مع torch.topk على نفس المدخلات، وكيعرض النسبة باستعمال عرض النطاق الفعلي ديال الذاكرة.
الخلاصة
DeepSelect كيوفّر نوى متخصصة لـ TopK، متوافقة مع أحمال DeepSeek Sparse Attention وأخذ العينات. بدا بتنسور CUDA ثنائي الأبعاد ومحاذى، وخلي topk أقل من أو كيساوي 4096، وعطّل الترتيب أو إخراج القيم ملي ما يكونوش ضروريين. فالإدماج فالإنتاج، تحقق من متطلبات stride، وخذ بعين الاعتبار أن المخرجات تقدر ما تكونش متجاورة، ودير benchmark بنفس أشكال التنسورات اللي كيستعملها التطبيق.