

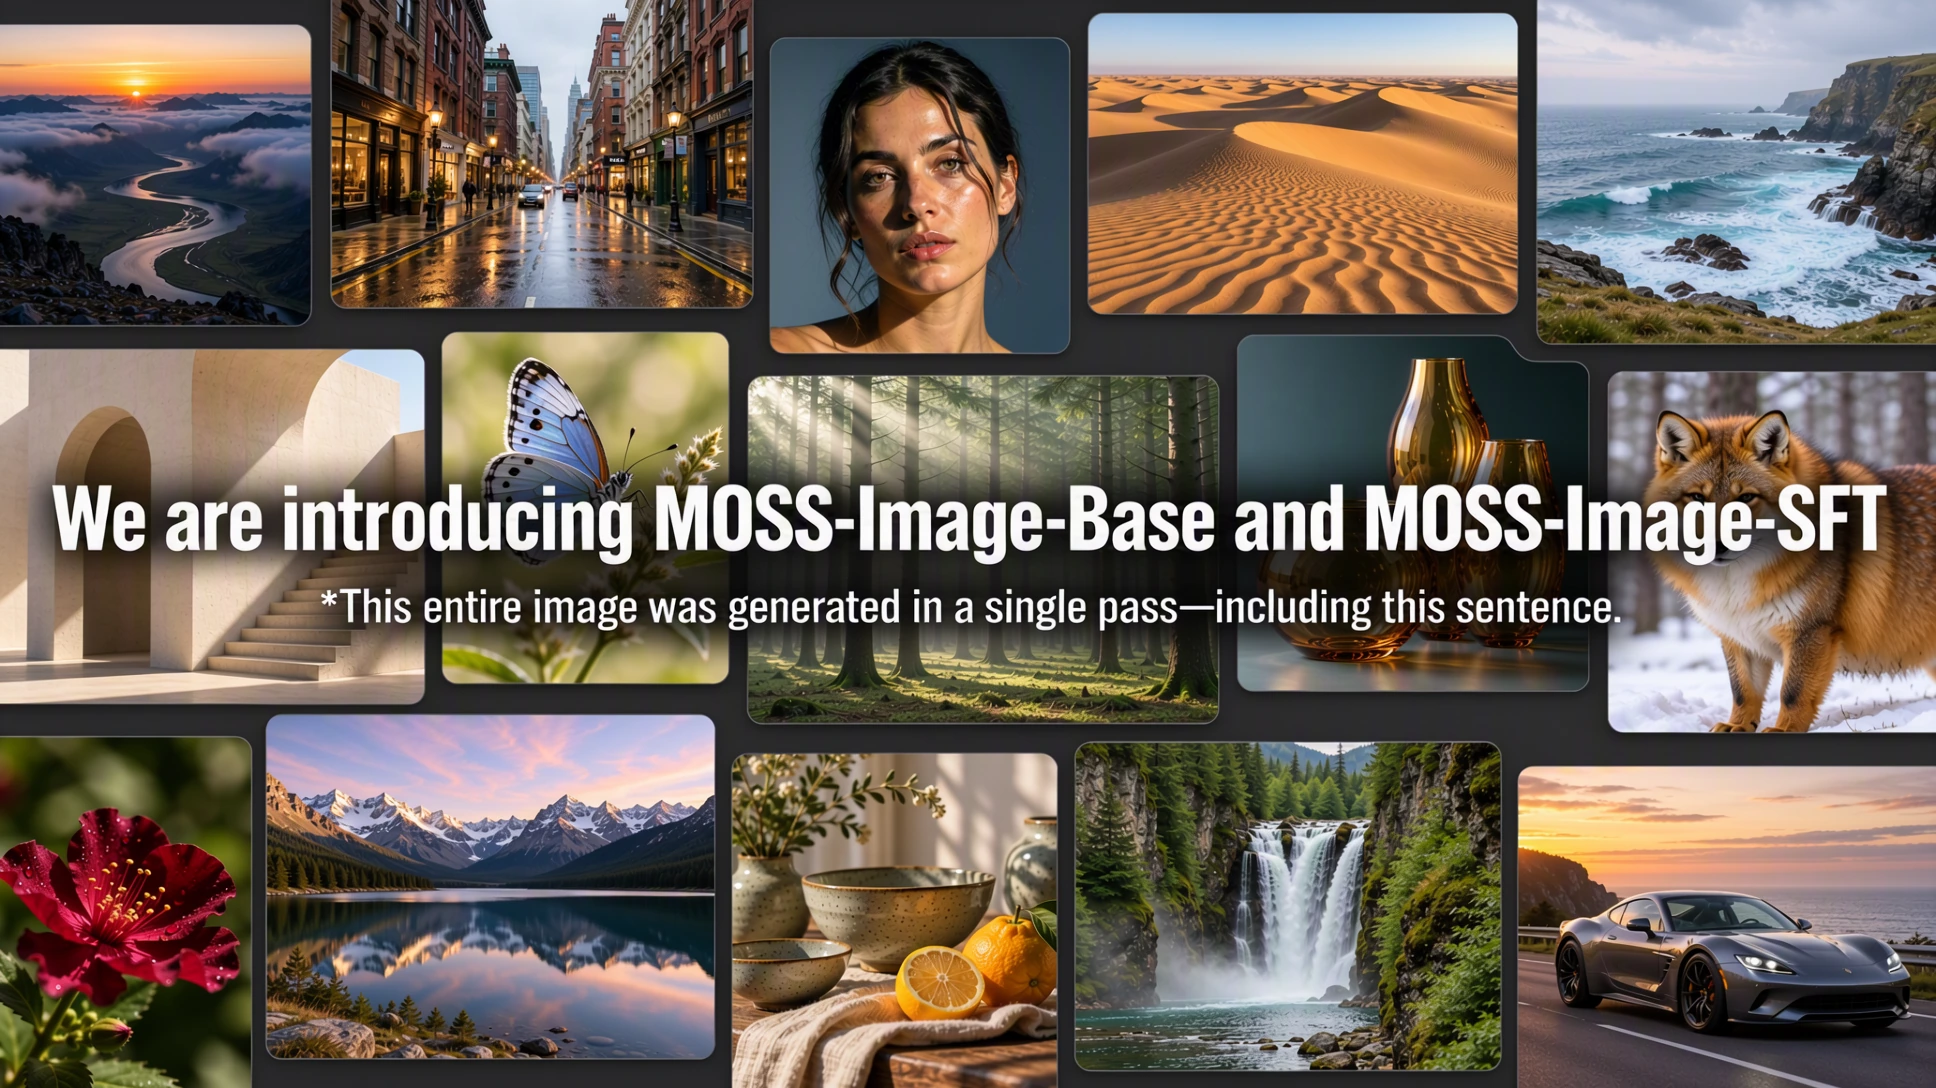
شنو هو MOSS-Image؟
MOSS-Image هو مشروع مفتوح لتوليد الصور من فريق OpenMOSS. كيوفّر موديل أساسي لتحويل النص لصورة وموديل داز من الضبط الدقيق بالإشراف، ومعاه pipeline مخصّص ديال Diffusers، وواجهة Gradio، وإضافة أصلية لـ ComfyUI، وأدوات لتحضير البرومبتات المفصّلة.
المشروع مهيّأ للتكوينات اللي كاتجمع بين العناصر البصرية والنص المقروء. كيدعم برومبتات حتى لـ 4K من التوكنات، ويقدر يولّد ستايلات كاتبدا من الأنمي وكتوصل للصور الواقعية. والـ backbone ديالو بـ 5B مصمّم باش يوفّر توليد صور مدمج وفعّال نسبياً.
الخصائص الرئيسية
- التحكم فالتخطيط: حطّ النصوص والعناصر البصرية باستعمال إدخال JSON منظّم ومربعات الإحاطة.
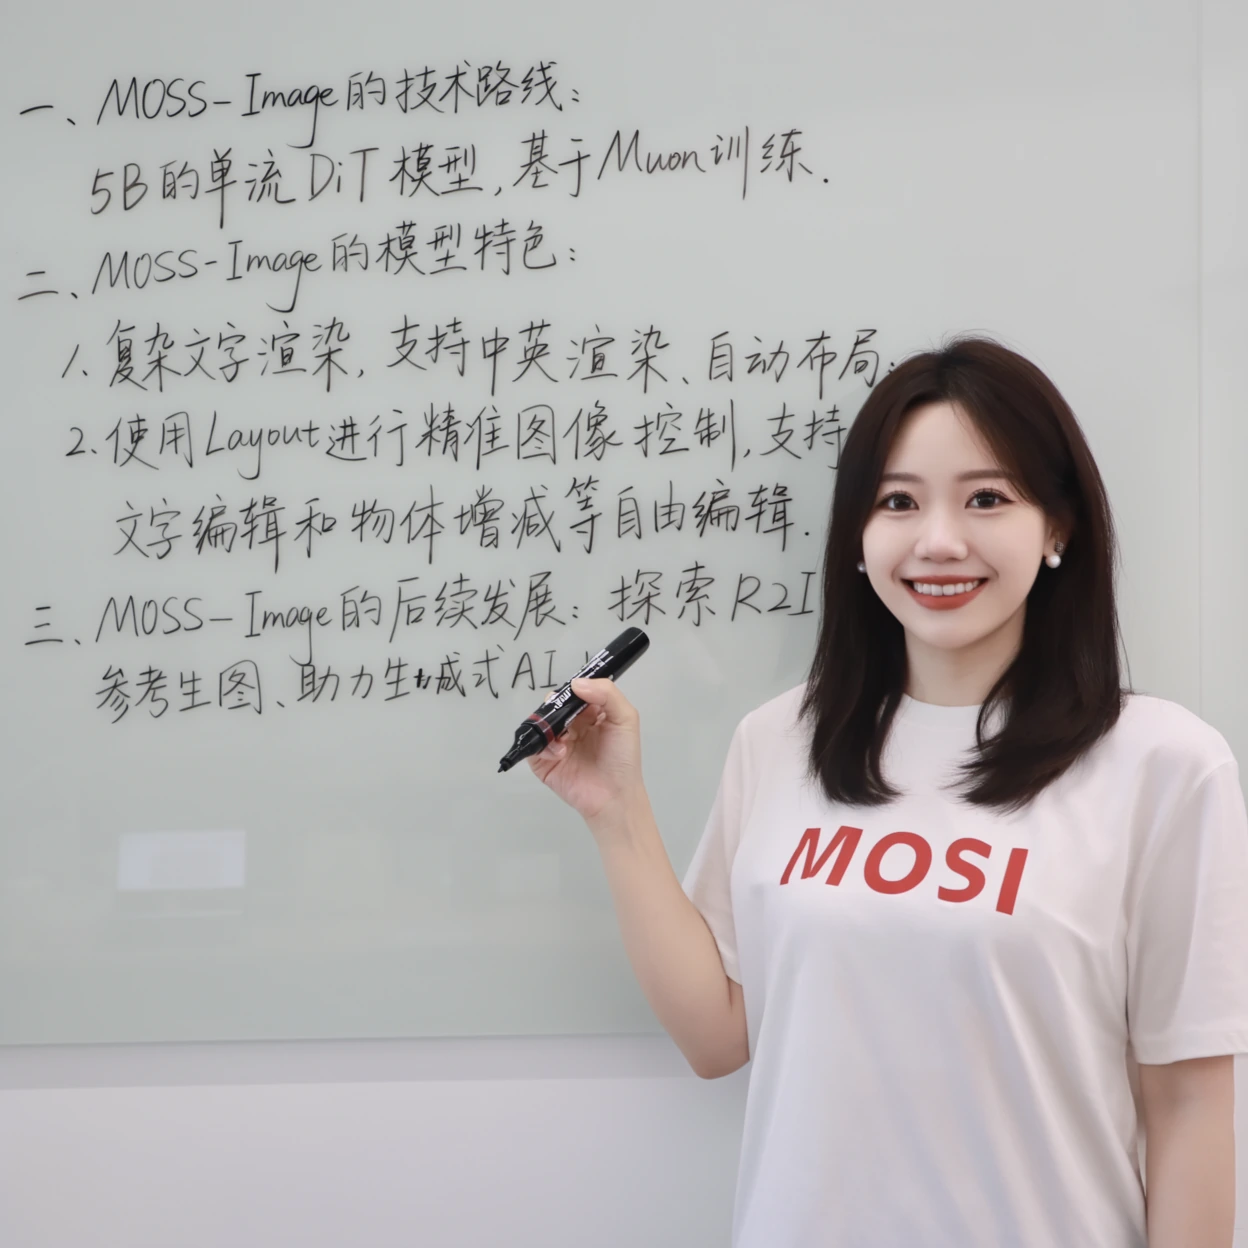
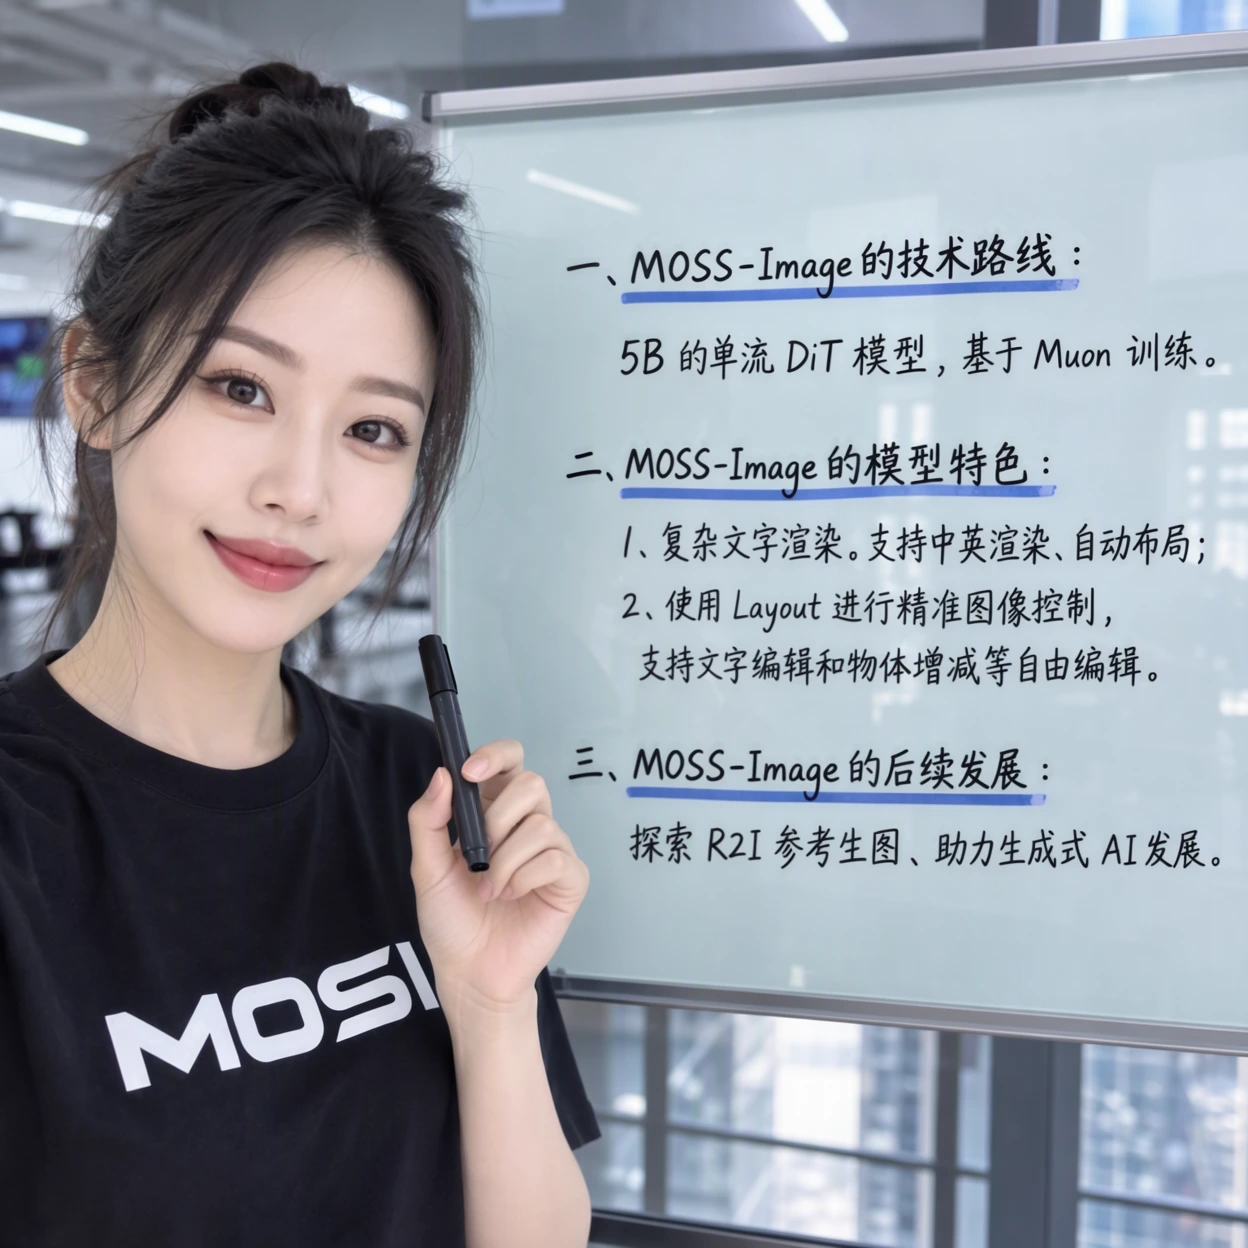
- عرض النصوص: ولّد نصوص واضحة داخل البوسترات، والملاحظات، والسبورات البيضاء، وتكوينات الصور الأخرى.
- البرومبتات الطويلة: صيفط برومبتات نصية فيها حتى لـ 4K من التوكنات.
- ستايلات متعددة: صايب صور بستايل الأنمي وصور واقعية.
- دعم الضبط الدقيق: كيّف الموديل الأساسي مع مهام ومجالات مخصّصة.
- بنية فعّالة: ولّد الصور باستعمال backbone بـ 5B.
- واجهات متعددة: استعمل Python أو Gradio أو ComfyUI أو مهارة تحسين البرومبتات المنفصلة.
اختار موديل
MOSS-Image متوفر بجوج ديال النسخ:
- MOSS-Image-Base: الموديل الأساسي لتحويل النص لصورة. الأوزان ديالو متوفرة فـ Hugging Face وModelScope.
- MOSS-Image-SFT: نسخة مضبوطة دقيقياً انطلاقاً من الموديل الأساسي باستعمال بيانات منتقاة. الأوزان ديالها متوفرة فـ Hugging Face وModelScope.
فالمقارنة اللي وفّرها المشروع، موديل SFT كيخرج تجميع أوضح للنص وتخطيط أكثر تنظيماً ديال السبورة البيضاء. بدا بموديل Base إلا كنت محتاج للـ checkpoint العام الأصلي أو ناوي تدير ليه ضبط دقيق. استعمل SFT إلا كان عرض النص المنظّم مهم بزاف.
ثبّت MOSS-Image
كلونِي المستودع، دخل للمجلد ديالو، صايب بيئة افتراضية، فعّلها، وثبّت المتطلبات:
git clone https://github.com/OpenMOSS/MOSS-Image.git
cd MOSS-Image
python -m venv .venv
source .venv/bin/activate

pip install -r requirements.txt
الأمثلة كتستعمل CUDA وكتنقل الـ pipeline لـ GPU باستعمال pipe.to("cuda"). تأكد باللي بيئة PyTorch ديالك مهيّأة لمنصة GPU اللي ناوي تشغّل فيها الاستدلال.
ولّد صورة باستعمال Python
MOSS-Image كيتحمّل عبر Diffusers باستعمال pipeline مخصّص ديالو. المثال التالي كيطلب من الموديل يصايب مشهد ديال مطبخ فيه تذكير صيني مكتوب بخط اليد:
import torch
from diffusers import DiffusionPipeline

pipe = DiffusionPipeline.from_pretrained(
    "OpenMOSS-Team/MOSS-Image-Base",
    custom_pipeline="pipeline_moss_image",
    trust_remote_code=True,
    torch_dtype={"default": torch.bfloat16, "vae": torch.float32},
)
pipe.scheduler = type(pipe.scheduler).from_config(pipe.scheduler.config)
pipe.to("cuda")

prompt = (
    "A wide view of a refrigerator beside a kitchen counter with a fruit bowl. "
    "A small sticky note on the refrigerator door is handwritten in Chinese:“\n"
    "记得买牛奶和鸡蛋!\n牛奶两盒,鸡蛋一打。\n顺便带一袋面包。”"
)

image = pipe(
    prompt,
    height=1456,
    width=1456,
    num_inference_steps=50,
    guidance_scale=3.0,
    uncond_skip_layers=[22],
    generator=torch.Generator("cpu").manual_seed(42),
).images[0]

image.save("refrigerator_note.png")
فهم المعاملات المهمة
custom_pipeline="pipeline_moss_image"كيختار pipeline ديال MOSS-Image.trust_remote_code=Trueكيسمح لـ Diffusers يحمّل التطبيق المخصّص ديال pipeline ديال الموديل.torch_dtypeكيستعمل bfloat16 افتراضياً، مع الاحتفاظ بـ float32 للـ VAE.heightوwidthكيحددو أبعاد الخرج.num_inference_steps=50كيتبع التوصية الافتراضية ديال المشروع لأخذ العينات.guidance_scale=3.0كيطبّق القيمة الموصى بها للتوجيه الخالي من المصنّف.uncond_skip_layers=[22]كيفعّل تخطّي الطبقة ففرع النفي عند الطبقة 22.manual_seed(42)كيخلي التشغيلات المتكررة بنفس الإعدادات أكثر قابلية لإعادة الإنتاج.
شغّل واجهة Gradio
ثبّت الاعتماديات الاختيارية ديال واجهة المستخدم وشغّل التطبيق المرفق:
pip install -e '.[ui]'
python gradio_app.py --model OpenMOSS-Team/MOSS-Image-Base
حلّ العنوان المحلي اللي كيعرضو Gradio، دخل برومبت إيجابي، اختار أبعاد الصورة، وبدا التوليد. باش تجرّب الـ checkpoint المضبوط دقيقياً، بدّل قيمة model بـ OpenMOSS-Team/MOSS-Image-SFT.
إعدادات أخذ العينات الموصى بها
- Sampler: Flow-matching Euler
- الخطوات: 50
- CFG: 3
- Shift: 5
- تخطّي الطبقات: تخطّي فرع النفي عند الطبقة 22
- البرومبت السلبي فـ Python API: فارغ
هادو هما الإعدادات الافتراضية الموثّقة ديال المشروع، وكيعطيو نقطة انطلاق عملية. راجع دليل المستخدم بالإنجليزية ديال المستودع باش تلقى توصيات إضافية على البرومبتات وإعدادات أخذ العينات.
تحكّم فالتكوين باستعمال تخطيطات JSON
البرومبتات العادية كتوصف شنو خاص الصورة تحتوي، ولكن ما كتحدّدش بدقة فين خاص كل عنصر يكون. عوض ذلك، يقدر MOSS-Image يستقبل تخطيط JSON كيوصف المشهد كامل، والعناصر النصية أو الأشياء كل واحد بوحدو، والمربعات المحدِّدة ديالها.
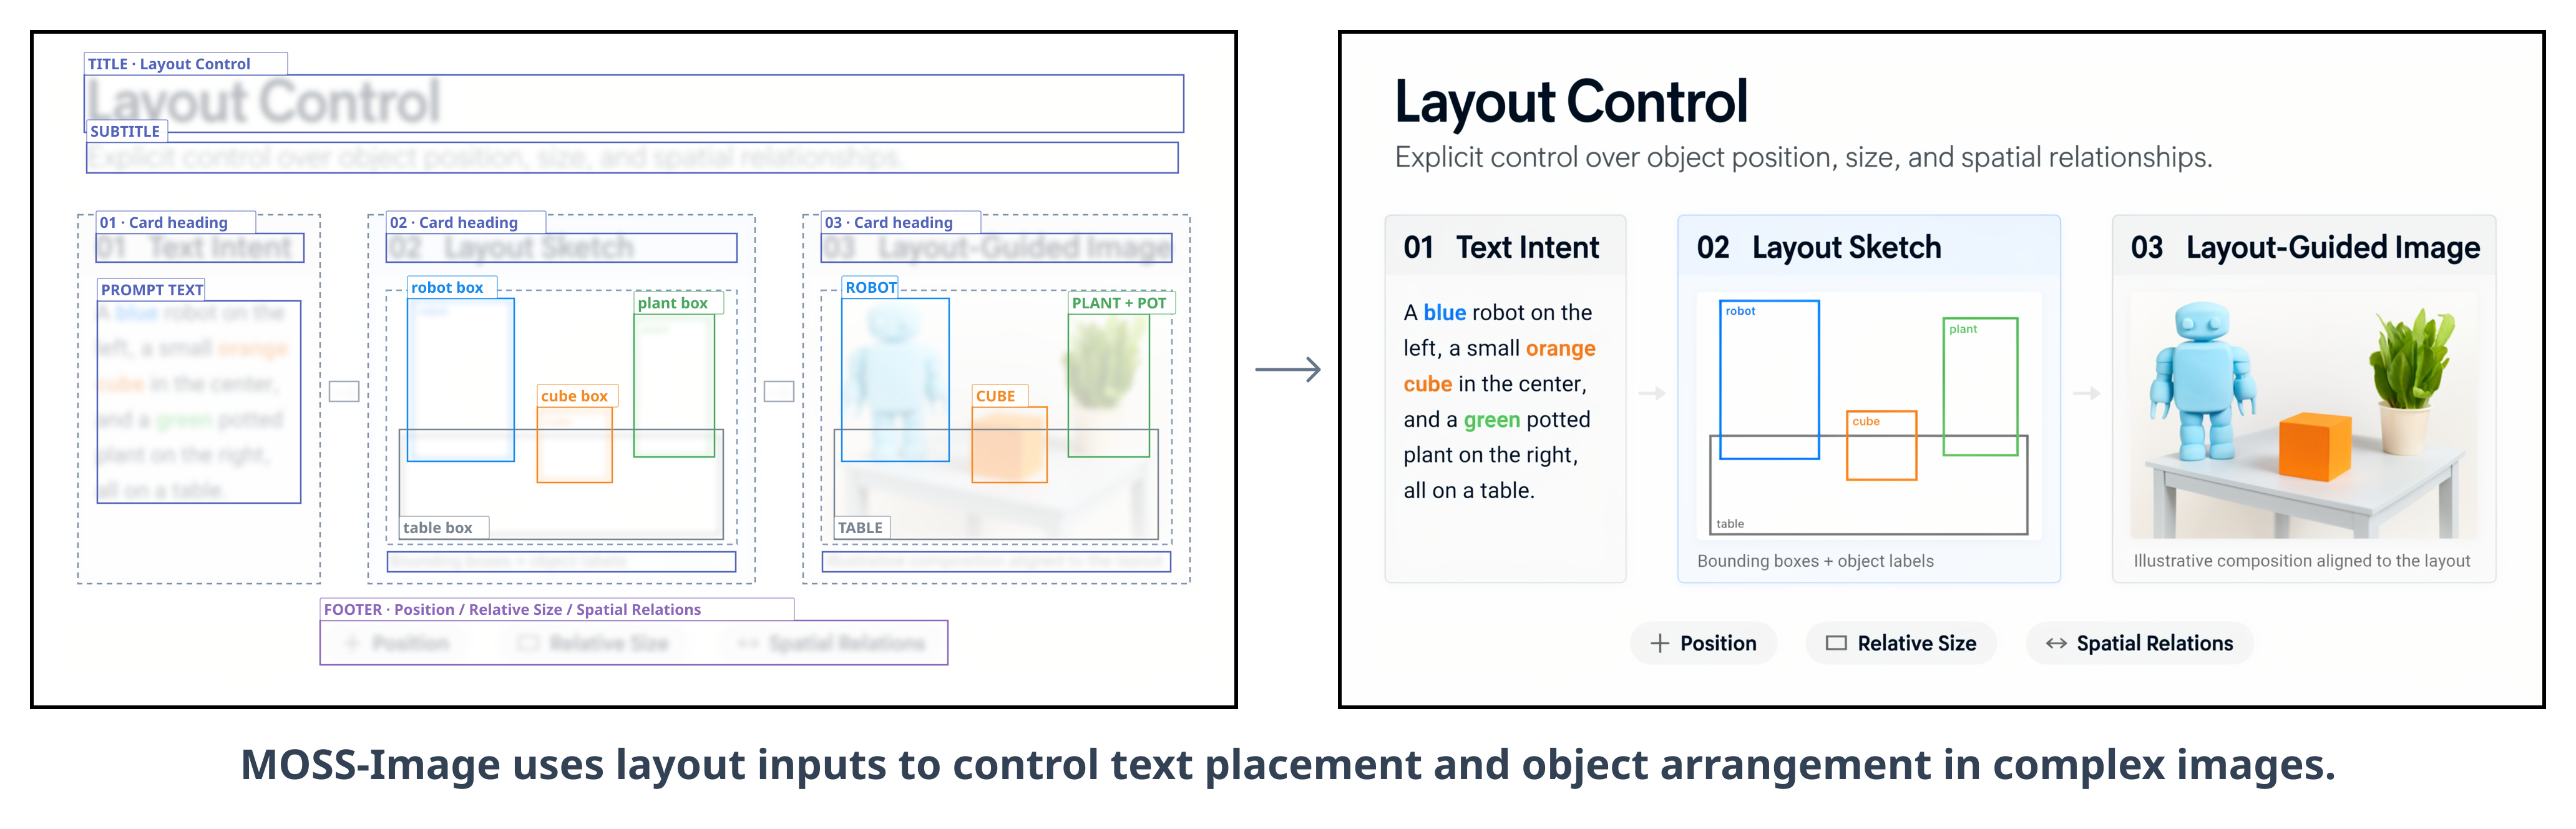
التخطيط التالي كيوصف ملصق سفر بسيط بقياس 1024 فـ 1024. حفظو باسم layout.json إلا بغيتي تحمّلو من Python، ولا لسّقو مباشرة فحقل Prompt ديال Gradio.
{
  "summary": {
    "meta": ["poster"],
    "canvas": "single",
    "caption": "ملصق سفر بسيط بخلفية كريمية، ورسم لجبل أزرق، والعنوان EXPLORE فالفوق."
  },
  "items": [
    {
      "label": "text",
      "caption": "عنوان كبير بالأحرف الكبيرة وبالأزرق الداكن، متمركز فالفوق.",
      "text": "EXPLORE",
      "bbox": [-416, -384, -288, 384]
    },
    {
      "label": "object",
      "caption": "رسم مسطّح لجبل أزرق فالجزء السفلي من الوسط.",
      "bbox": [-192, -288, 384, 288]
    }
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
كيفاش كيخدم تنسيق التخطيط
summary.captionكيوصف المشهد كامل والأسلوب البصري ديالو.itemsفيه العناصر النصية وعناصر الأشياء الموضوعة بشكل مستقل.labelكيحدّد واش العنصر نص ولا شي حاجة.captionكيوصف المظهر والدور ديال العنصر.textفيه الكلمات بالضبط اللي خاص العنصر النصي يرسم.bboxكيحدّد الموضع والحجم ديال العنصر.bbox_format: "yxyx"كيعني أن كل مربع مرتب بهاد الشكل:[y_min, x_min, y_max, x_max].bbox_coord_space: "abs_centralized"كيعني أن الإحداثيات محسوبة انطلاقاً من وسط اللوحة.
فلوحة بقياس 1024 فـ 1024، المحورين بجوج كيمتدو من -512 حتى +512. إحداثي x كيزيد فالجهة اليمنى، وإحداثي y كيزيد لتحت. باش تحوّل إحداثيات اللوحة العادية، نقص نصف عرض اللوحة من قيم x ونصف ارتفاع اللوحة من قيم y.
ديماً استعمل أبعاد التوليد اللي مطابقة للأبعاد اللي تْوجد عليها التخطيط. أي اختلاف كيبدّل نظام الإحداثيات وقد يحرّك العناصر بعيد على المواضع المقصودة ديالها.
إرسال تخطيط باستعمال Python
حمّل ملف JSON، حوّلو لسلسلة نصية، ودوز هاد السلسلة كبرومبت للـ pipeline:
import json
import torch

with open("layout.json", "r", encoding="utf-8") as file:
    layout = json.load(file)

layout_prompt = json.dumps(layout, ensure_ascii=False)

image = pipe(
    layout_prompt,
    height=1024,
    width=1024,
    num_inference_steps=50,
    guidance_scale=3.0,
    uncond_skip_layers=[22],
    generator=torch.Generator("cpu").manual_seed(42),
).images[0]

image.save("travel_poster.png")
تقدر تبدّل التكوين بلا ما تعاود تكتب البرومبت كامل. بدّل النص أو الوصف أو المربع المحدِّد ديال شي عنصر، وولّد الصورة من جديد. README كيشير حتى هو لأن هاد الطريقة المهيكلة تقدر تعاون فالتعديل المتحكَّم فيه وأدوات التخطيط السهلة للمستخدم.
تدبير ذاكرة GPU
واجهة Gradio كتوفّر ثلاثة ديال أوضاع الذاكرة فالإعدادات المتقدمة:
- GPU resident: كيخلي الموديل كامل فـ GPU باش يكون الولوج ليه مباشر.
- Component: كينقل مكوّنات الموديل بين CPU وGPU حسب الحاجة.
- Sequential fallback: كيقلّل استعمال الذاكرة مقابل استدلال أبطأ.
إلا ما تساعش الموديل فذاكرة GPU المتوفرة، اختار الوضع Sequential ولا نقص حجم الصورة الناتجة. تجميع DiT معطّل افتراضياً وما متوفرش فالوضع Sequential.
استعمال MOSS-Image مع ComfyUI
المستودع فيه إضافة أصلية ديال MOSS-Image لـ ComfyUI. قلّب على MOSS-Image فـ ComfyUI Manager باش تثبّتها. المشروع كيوفّر حتى workflow نموذجي تقدر تستورْدو كنقطة انطلاق.
المشروع خدام باش يندمج فالمستودع الرسمي ديال ComfyUI. حتى يوقع هاد الشي، تبع تعليمات تثبيت واستعمال ComfyUI ديال المستودع.
برومبتات متقدمة باستعمال Prompt Enhancer
Prompt Enhancer المرفق مع MOSS-Image كيحوّل فكرة بسيطة على صورة إلى وصف مفصّل أو برومبت ديال تخطيط مكاني. تْصمّم لوكلاء من عائلة GPT-6 اللي عندهم أدوات محلية للملفات وPython.
- ثبّت المجلد
skills/moss-image-prompt-enhancerفمجلد المهارات ديال الوكيل. - شغّل
$moss-image-prompt-enhancerمع فكرة على الصورة. - حدّد واش بغيتي وصف مفصّل ولا مخرج Layout.
- عطي أبعاد اللوحة المقصودة ملي كتوجد تخطيط.
- لسّق المخرج المجمّع فـ positive prompt ديال MOSS-Image.
- إلا اخترتي مخرج Layout، ولّد الصورة بنفس أبعاد اللوحة اللي تستعملات فالتجميع.
السكريبت المرفوق كيحوّل المسودّات اللي فيها الإحداثيات بالبكسل لـ JSON مختصر باستعمال إحداثيات صحيحة ومتمركزة. كيوجّد غير البرومبتات وما كيتاصلش بخدمة ديال توليد الصور.
نصائح عملية
- بدا بالإعدادات الافتراضية الموثّقة: استعمل 50 خطوة، وCFG بقيمة 3، وshift بقيمة 5، وتجاوز الفرع السلبي فالطبقة 22 قبل ما تبدا تجرّب.
- خلي النص المطلوب واضح ومحدّد: حطّ الصياغة بالضبط فالبرومبت ولا فالحقل
textديال العنصر. - استعمل تخطيطات منظّمة للتصاميم المعقّدة: البوسترات، والرسومات التوضيحية، والمشاهد اللي فيها بزاف ديال النصوص كيستافدو من وصف العناصر ومربعات الإحاطة ديالها بشكل منفصل.
- طابق الأبعاد بعناية: إحداثيات التخطيط مرتبطة بالعرض والارتفاع ديال اللوحة اللي اخترتي.
- ثبّت قيمة seed فاش كتعاود التجربة: الاحتفاظ بنفس seed كيساعدك تقارن التغييرات ديال البرومبت، والموديل، والتخطيط.
- نقص من حجم الصورة إلا كانت الذاكرة محدودة: هادي وحدة من الحلول اللي كيوصي بها المشروع بشكل صريح.
- قارن بين Base وSFT: يقدر checkpoint ديال SFT يكون أنسب إلا كانت الأولوية لتجميع أوضح وتخطيط نصّي أكثر تنظيماً.
الخلاصة
MOSS-Image كيجمع بين توليد الصور العام انطلاقاً من النص، ورسم النصوص بجودة مزيانة، والتحكم فالتركيب المنظّم. تقدر تبدا بالـ pipeline ديال Python ولا بواجهة Gradio، ومن بعد تنتاقل لتخطيطات JSON ملي كيولي التموضع الدقيق مهم. تكامل ComfyUI، وأوضاع الذاكرة، والمهارة ديال تحسين البرومبتات كيوفّرو طرق إضافية باش تدمج الموديل فمسارات العمل البصرية. كود الـ pipeline المستقل متاح بموجب رخصة Apache 2.0.