

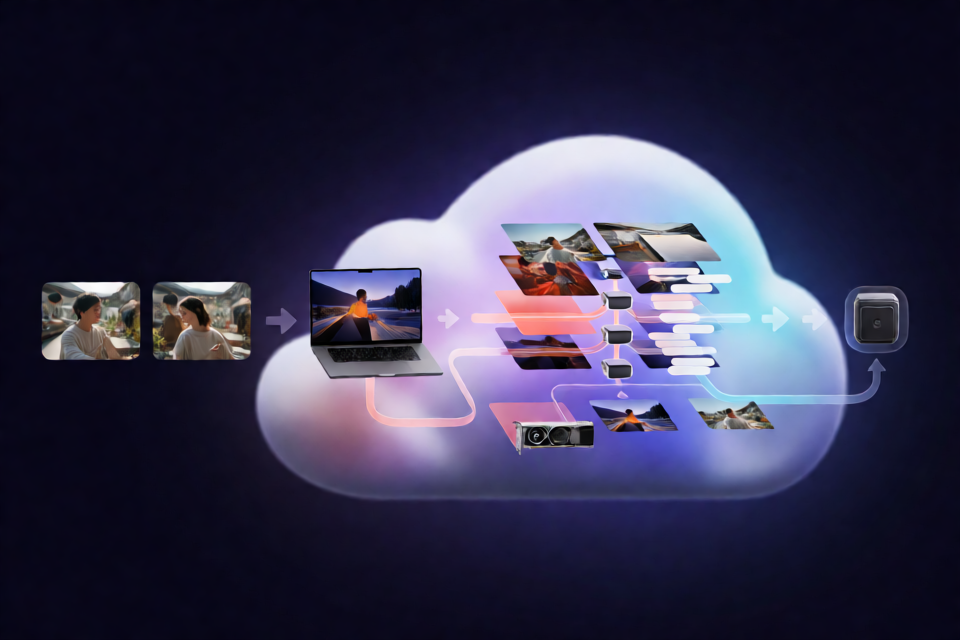
شنو كيدير هاد المشروع
MiniMax H3 Ref2VA LoRA Colab Skill هي مهارة Codex قابلة للتثبيت، كتوجد مجموعات بيانات مزدوجة ديال الصور وكتدرّب MiniMax H3 Ref2VA LoRA فـ Google Colab. الـ runner كينظّم الصور المحلية، كيجهّز مجموعة البيانات، كيشغّل دفتر Colab المرفق، كيحفظ نقاط التحقق وملفات التشغيل فـ Google Drive، وكيحمّل الـ adapter النهائي بصيغة .safetensors للحاسوب ديالك.
هاد المسار موجّه بالخصوص لمحوّل MiniMax H3. H3 كيستعمل Qwen3-VL فـ pipeline ديال فهم الصور، ولكن Qwen Image موديل مختلف. LoRA ديال Qwen Image ما متوافقاش مع adapter ديال H3.
المزايا الرئيسية
- كيصاوب مجموعات بيانات مزدوجة من صور الهدف وصور المرجع/التحكم.
- كيستعمل ملفات captions بنفس الاسم الأساسي ملي كتكون متوفرة.
- كيدعم مخطط JSON لمجموعة البيانات باش تكون الـ captions واختيارات المراجع قابلة لإعادة الإنتاج.
- كيدير تدريب MiniMax H3 Ref2VA LoRA عبر Ostris AI Toolkit فـ Google Colab.
- كيدعم إعداد عدد خطوات التدريب، وLoRA rank، وalpha، وlearning rate، ونوع GPU، وطلبات الذاكرة الكبيرة.
- كيزامن نقاط التحقق، والعينات، والإعدادات، وملخص التشغيل مع Google Drive.
- كيحمّل الـ adapter النهائي
.safetensorsلمجلد إخراج محلي. - كيوفّر أوامر لفحص رصيد Colab compute واختبار الاتصال ببيئة التشغيل البعيدة.
المتطلبات الأساسية
قبل ما تثبّت المهارة، تأكد باللي النظام المحلي ديالك فيه:
- Python 3.10 أو أحدث.
- Google Colab CLI مثبت ومصادق عليه قبل تشغيل الأوامر البعيدة.
- حساب Colab عندو إمكانية الولوج لعتاد GPU.
- الولوج لموديل H3 المطلوب وموارد adapter ديال التدريب، مع قبول أي تراخيص مطبّقة.
- رصيد Colab compute كافي للتدريب اللي باغي تدير.
دفتر Colab المرفق كيتحقق من توفر 60 GiB على الأقل من المساحة الحرة فالقرص، وكينبّه ملي كتكون VRAM ديال GPU أقل من 48 GiB. المشروع كيوصي بـ A100 بذاكرة كبيرة، ولكن ما كاين حتى ضمان رسمي للحد الأدنى ديال VRAM.
ثبّت مهارة Codex
دير clone للمستودع وشغّل المثبّت ديالو:
git clone https://github.com/killkli/minimax-h3-lora-colab-skill.git
cd minimax-h3-lora-colab-skill
./install.sh
إلى كان CODEX_HOME مضبوط، المثبّت كيحط المهارة فـ $CODEX_HOME/skills. وإلا كيستعمل ~/.codex/skills.
باش تثبّتها فـ مجلد آخر ديال المهارات، استعمل --dest:
./install.sh --dest /path/to/skillsالتثبيتات الموجودة كيبقاو محفوظين افتراضياً. إلا بغيتي تعوّض واحد منهم عن قصد، استعمل --force. المثبّت كينقل النسخة القديمة لنسخة احتياطية باسم فيه الطابع الزمني، بلا ما يحذفها فصمت.
تحقق من التثبيت
عرض مساعدة الـ runner بلا ما تشغّل مهمة Colab:
python3 ~/.codex/skills/minimax-h3-lora-colab/scripts/runner.py --helpإلى كان CODEX_HOME مضبوط، عوّض ~/.codex/skills بـ $CODEX_HOME/skills. التثبيت المحلي وفحوصات المساعدة ما كيشغلوش التدريب وما كيستهلكوش وقت GPU ديال Colab.
وجد صور التدريب ديالك
حط صور الهدف فـ مجلد واحد. خاص الصور تبيّن نفس الشخص أو الموضوع. تقدر تزيد captions اختيارية فـ ملفات نصية عندها نفس الاسم الأساسي. مثلاً، photo01.jpg تقدر تكون عندها caption فـ photo01.txt.
من المستودع اللي درتي ليه clone، وجد مجموعة بيانات بهاد الأمر:
python3 scripts/runner.py prepare \
  --input-dir /path/to/target_photos \
  --name studio_subject \
  --trigger "studio_subject person" \
  --output-dir ./prepared_dataset
المجلد الموجد كيحتوي على:
prepared_dataset/
├── targets/
├── references/
└── dataset_manifest.jsontargets/فيه صور الهدف وملفات captions بنفس الاسم الأساسي.references/فيه صور المرجع أو التحكم، بأسماء أساسية مطابقة لصور الهدف.dataset_manifest.jsonكيسجّل المصدر، والهدف، والمرجع، وcaption ديال كل عينة.
تحضير مجموعة البيانات كيدار محلياً. كينسخ الصور الأصلية للمجموعة الموجدة، ولكن ما كيرفعهاش لـ Colab.
اختار المراجع أوتوماتيكياً
إلى ما وفرتيش مجلد منفصل للمراجع، الـ runner كيحتاج على الأقل جوج صور هدف. كيدوز على هاد الصور بالتناوب باش ينشئ أزواج المراجع.
استعمل، ملي يكون ممكن، لقطات متنوعة ومفيدة لنفس الموضوع. صورة الهدف ما خاصهاش تستعمل راسها كمرجع.
استعمل مجلد منفصل للمراجع
باش تختار المراجع من مجلد آخر، زِد --reference-dir:
python3 scripts/runner.py prepare \
  --input-dir /path/to/target_photos \
  --reference-dir /path/to/reference_photos \
  --name studio_subject \
  --trigger "studio_subject person" \
  --output-dir ./prepared_dataset
كل مرجع مختار خاصو يبيّن نفس الموضوع الموجود فمجموعة الهدف. إلا كنت كتختار غير جزء من مجموعة كبيرة، حط الأهداف والمراجع المختارة فمجلدات staging وخلي مجموعة الصور الأصلية بلا تغيير.
صايب مخطط قابل لإعادة الإنتاج لمجموعة البيانات
مخطط مجموعة البيانات كيسجّل captions خاصة بكل صورة، واختيارات اختيارية للربط بين الهدف والمرجع. هاد الشي كيخلي التنسيق اليدوي أو بمساعدة agent قابل لإعادة الإنتاج.
{
  "captions": {
    "photo01.jpg": "studio_subject person, waist-up portrait in a blue jacket, outdoors in soft daylight",
    "photo02.jpg": "studio_subject person, side profile wearing a white shirt, indoors by a window"
  },
  "references": {
    "photo01.jpg": "front_reference.png",
    "photo02.jpg": "side_reference.png"
  }
}
خاص الكائن captions يضم الاسم الأساسي ديال كل صورة مستهدفة. إلا كان الكائن الاختياري references حاضر، خاصو حتى هو يربط كل اسم أساسي مستهدف باسم أساسي ديال صورة فمجلد المراجع المرشحين.
خاص التعاليق توصف غير التفاصيل اللي باينة. خَلّي الأشخاص ولا المواضيع اللي ما عندهاش علاقة فمجموعات بيانات منفصلة، وما تربطش صورة مستهدفة براسها.
وجّد مجموعة البيانات باستعمال الخطة:
python3 scripts/runner.py prepare \
  --input-dir /path/to/target_photos \
  --reference-dir /path/to/reference_photos \
  --dataset-plan /path/to/dataset-plan.json \
  --name studio_subject \
  --trigger "studio_subject person" \
  --output-dir ./prepared_dataset
إلا تحيدات --dataset-plan، كيستعمل الـ runner التعاليق الجانبية الموجودة وكيعطي قيمة افتراضية بسيطة للتعاليق الناقصة.
راجع قبل الرفع
حلّ dataset_manifest.json قبل التدريب وتحقق من كل مصدر، وهدف، ومرجع، وتعليق. هادي أحسن مرحلة باش تكتاشف الربط الغلط، والوصف الناقص، ولا الصور اللي كتخص موضوع مختلف. التدريب هو المرحلة اللي كترفع الصور الموجدة لبيئة Colab.
درّب LoRA على Google Colab
من بعد ما تراجع مجموعة البيانات الموجدة، بدا تشغيل التدريب:
python3 scripts/runner.py train \
  --dataset-dir ./prepared_dataset \
  --name studio_subject \
  --trigger "studio_subject person" \
  --steps 1000 \
  --rank 16 \
  --alpha 16 \
  --gpu A100 \
  --output-dir ./outputs
إعدادات التدريب الافتراضية هي:
- 1,000 خطوة ديال التدريب.
- رتبة LoRA هي 16.
- Alpha قيمتها 16.
- معدل التعلم
1e-4. - جلسة Colab عالية الذاكرة بمعالج A100.
الـ notebook كينزّل موديل H3 والأصول المطلوبة ديال محوّل التدريب. المحوّل النهائي كيتحط فـ ./outputs/ فملف .safetensors.
حتى ملفات التشغيل كيتزامنو مع:
MyDrive/MiniMax_H3_LoRAs/<name>/<run-id>/مجلد Drive فيه نقاط الحفظ، والعينات المولدة، ومعطيات الإعداد، وملخص التشغيل.
بدّل معطيات التدريب بحذر
تقدر تبدّل القيم المثال ديال الخطوات، والرتبة، وalpha، ووحدة GPU، ومجلد الإخراج. باش تشوف جميع اختيارات التدريب المدعومة، شغّل:
python3 scripts/runner.py train --helpالوضع عالي الذاكرة مطلوب افتراضياً. زِد --no-high-mem غير إلا كانت تخصيصة GPU المختارة فـ Colab خاصها ما تطلبش هاد الوضع.
تحقق من استعمال Colab والاتصال
باش تقرا الرصيد الحالي ديال حساب Colab فصيغة JSON، استعمل:
python3 scripts/runner.py usage --jsonباش تجهّز بيئة GPU بعيدة وتتحقق من الفحص، ونقل الملفات، ومسار Google Drive، شغّل:
python3 scripts/runner.py testالأمر
testماشي تحقق من التدريب. ما كيضمنش أن تدريب MiniMax H3 غادي يلقى الذاكرة الكافية فـ VRAM المتاحة ولا يكمل بنجاح.
نصائح متقدمة وإرشادات تشغيلية
خلي مجموعات المواضيع مركزة
استعمل صور ديال شخص واحد ولا موضوع واحد فكل مجموعة بيانات. فصل المواضيع اللي ما عندهاش علاقة كيخلي التعاليق وربط المراجع أوضح وكيوافق سير العمل اللي كيتوقعو الـ runner.
استعمل تعاليق خاصة بكل صورة
بلا ما تعتمد غير على تعليق عام، وصف الخصائص الباينة بحال الوضعية، والملابس، والتأطير، والبيئة، والإضاءة. ضمّن trigger المختار باستمرار، ولكن تجنب تزيد تفاصيل ما بايناش فالصورة.
فضّل تنوعاً مفيداً فالمراجع
اختار مراجع كتعطي زوايا متنوعة وباقية كتصور نفس الموضوع. مثلاً، جمع بين صور مواجهة للأمام وصور جانبية ملي يكون هاد الشي مناسب. ما تربطش الهدف براسو أبداً.
حافظ على سجل قابل للمراجعة
خلي خطة مجموعة البيانات والـ manifest المولد مع المشروع. بجوجهم كيوثقو التعاليق والروابط المستعملة فالتشغيل وكيخليو مراجعة ولا إعادة عملية التحضير أسهل.
راقب المخرجات المحلية والسحابية
مجلد الإخراج المحلي فيه المحوّل النهائي المنزّل، بينما Google Drive كيحتافظ بملفات تشغيل أوسع. استعمل النسخة ديال Drive باش تفحص نقاط الحفظ، والعينات، والإعدادات، وملخص التشغيل إلا توقف تشغيل التدريب بشكل غير متوقع.
اعتبر ملاءمة العتاد مرتبطة بوقت التشغيل
استعمال A100 الموصى به وعالي الذاكرة ما كيضمنش النجاح. الملاءمة الفعلية للذاكرة كتتعلق ببيئة Colab وإعدادات التدريب. الـ notebook كيعطي تحذير تحت 48 GiB ديال VRAM وكيشيك على 60 GiB ديال المساحة الحرة فالقرص، ولكن هاد الفحوصات ماشي ضمان رسمي للعتاد.
فهم حالة التحقق
إعداد المثال Ref2VA ديال AI Toolkit من المصدر الأصلي معلّم بأنه غير متحقق منه. وبالتالي، المستودع ما كيدعيش أن كل تشغيل سحابي للتدريب غادي ينجح. الـ notebook كيثبت commit المصدر اللي تفحص ديال AI Toolkit باش يعاود نفس النتائج، ولكن التثبيت الناجح ولا الفحص البعيد ما خاصوش يتفهم كدليل على إكمال التدريب من البداية للنهاية.
قراءة إضافية
الخلاصة
مهارة MiniMax H3 Ref2VA LoRA فـ Colab كتوفّر مسار قابل للتكرار من انتقاء الصور محلياً حتى الحصول على مُحوِّل H3 قابل للتنزيل. وجّهز وراجع أزواج الصور المستهدفة والمرجعية محلياً، واستعمل خطة بيانات ملي كتحتاج أوصاف وربط قابلين لإعادة الإنتاج، وتأكد من موارد Colab والتراخيص ديالك، ومن بعد طلّق التدريب. ردّ بالك بلي إعدادات المنبع مازال ما تْتحققاتش، وبلي Qwen Image LoRAs ماشي قابلة للتبادل مع مُحوِّلات MiniMax H3.