

شنو كيدير Tiny Classifiers
tiny-classifiers هو وصفة عملية لتدريب مصنّفات نصوص صغار ومخصّصين لمهام معيّنة. كيستعمل مشفّر Ettin-17M اللي فيه 17 مليون بارامتر، وكيدير ليه الضبط الدقيق لجميع الأوزان، وكيحفظ النتيجة كنموذج عادي ديال Hugging Face.
المشروع مصمّم لمهام التصنيف بحال توجيه رسائل البنك، وتصنيف الأخبار، والتعرّف على نية المستخدم، واكتشاف المشاعر، ولا إسناد الوثائق القانونية لفئات محدّدة من قبل. إلا ما كانوش عندك أمثلة معنونة كفاية، يقدر نموذج لغوي كبير يلعب دور المعلّم ويعنون مجموعة التدريب.
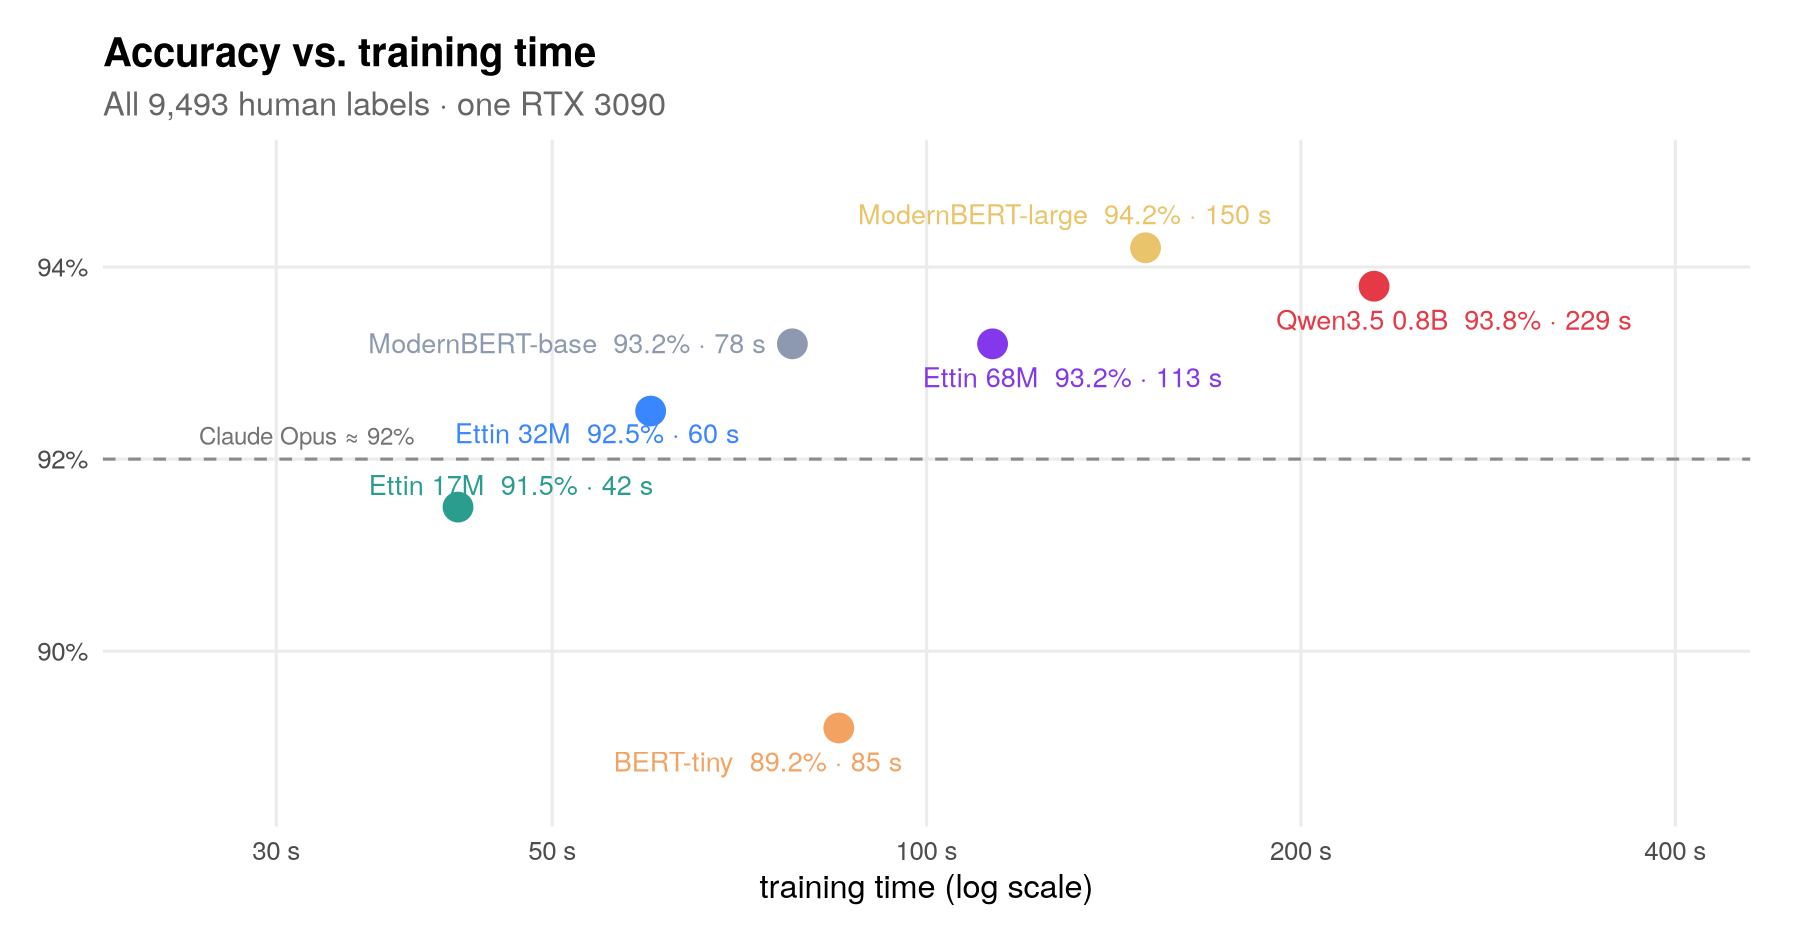
فالتجربة ديال Banking77 فالمستودع، وصل Ettin-17M لدقّة 91.5%، مقارنةً مع 92% ديال Claude Opus. التدريب خدا 42 ثانية على وحدة GPU ديال الألعاب، بينما الاستدلال خدا تقريباً 5 ميليثواني لكل رسالة. التدريب خدم حتى على معالج CPU ديال حاسوب محمول فحوالي 11 دقيقة، وعلى GPU ديال الهاتف فحوالي 21 دقيقة.
مقارنة دقّة Banking77 مع وقت التدريب.
أهم المزايا
- نموذج محلي صغير: Ettin-17M فيه 17 مليون بارامتر وكيعطي نقطة وحدة لكل فئة.
- معنويات بشرية ولا ديال المعلّم: درّب النموذج بمعنويات متحقَّق منها، ولا خلّي Kimi K3 يعنون الرسائل اللي ما عندهاش معنويات.
- التدريب بـ GPU وCPU: سكريبت التدريب كيدعم بجوج البيئات.
- إخراج نموذجي عادي: المصنّفات المدرَّبة تقدر تحمّلها عبر pipeline ديال Hugging Face
transformers. - استئناف العنونة: سكريبت العنونة كيدعم إعادة المحاولة، والتزامن التكيّفي، وتدبير الطلبات البطيئة، وميزانيات المزوّدين.
- تقييم مدمج: التدريب كيبلّغ على دقّة الاختبار، وعنونة المعلّم تقدر تقيس دقّة المعلّم على مجموعة اختبار معنونة.
- تحليل التكلفة: سكريبت نقطة التعادل كيقدّر الوقت اللي كيولي فيه العنونة والتدريب أرخص من الأداء على التصنيف عبر API.
- تحضير قابل لإعادة الاستعمال: المشروع يقدر يوجّد عشرة مجموعات بيانات عمومية للتصنيف باستعمال بنية موحّدة.
كيفاش كتخدم وصفة التدريب
Ettin-17M هو مشفّر مفتوح من Johns Hopkins ومرتبط بنماذج على طريقة BERT. بخلاف نموذج توليدي كينتج النص توكن بتوكن، هو كيقرا المدخل كامل وكيعيّن نقطة لكل فئة متاحة.
المستودع كيضيف مخرج لكل فئة وكيدير الضبط الدقيق لجميع أوزان النموذج. الوصفة الافتراضية كتستعمل حجم دفعة 32، وAdamW بمعدل تعلّم 1e-4، واضمحلال الأوزان 0.01، وتسخين بنسبة 5% متبوع بتناقص جيبي، وقصّ التدرّج عند 1.0، وخسارة الانتروبيا المتقاطعة.
بالنسبة لحوالي 9,500 رسالة، التدريب كيدوز من ست دورات. ومع غير 2,000 مثال، كيستعمل نفس العدد ديال خطوات التحسين، وهاد الشي كيعادل تقريباً 28 دورة. ملف README كيأكّد بلي هاد الإعدادات ما تظبطاتش بشكل منفصل لكل مهمة.
التثبيت والإعداد
1. ثبّت uv
السكريبتات كتستعمل uv باش تنشئ البيئة المطلوبة وتثبّت الاعتماديات أوتوماتيكياً فأول تشغيل. ثبّت uv باستعمال التعليمات الخاصة بنظام التشغيل ديالك، ومن بعد حلّ الطرفية فالمجلد الجذر ديال المستودع.
2. وجّد مجموعات البيانات العمومية
شغّل سكريبت التحضير:
uv run recipe/prepare.pyهاد السكريبت كيحمّل Banking77 وCLINC150 وMASSIVE بالإنجليزية والفرنسية وTREC وAG News وSST-5 وFinancial PhraseBank وLEDGAR ومجموعة بيانات ديال خطاب الكراهية فالتغريدات من Hugging Face Hub.
لكل مهمة، السكريبت كينشئ مجلداً تحت data/tasks/. وكيبني تعريف المهمة، و2,000 رسالة تدريب، وتقسيماً أكبر للتدريب فيه حتى لـ 150 مثال لكل فئة، ومجموعة اختبار.
3. كوّن مزوّد العنونة
إلا بغيتي نموذج معلّم يولّد المعنويات، عيّن مفتاح API ديال مزوّد واحد ولا أكثر من المزوّدين المدعومين:
export OPENROUTER_API_KEY=...الوصفة كتتعرّف حتى على مفاتيح المزوّدين المرتبطة بـ Fireworks وTogether وDeepInfra وParasail. راجع الأثمنة الحالية ديال المزوّد المعني، وسياسات الاستعمال، وشروط النماذج قبل ما تصيفط البيانات ولا تستعمل الأجوبة المولّدة فالتدريب.
درس أساسي: درّب مصنّف AG News
الخطوة 1: ولّد المعنويات بـ Kimi K3
من بعد ما توجّد مجموعات البيانات، عنون 2,000 رسالة ديال تدريب AG News:
uv run recipe/label.py data/tasks/agnewsفالتشغيل المذكور، Kimi K3 عنون 2,000 مثال فحوالي 20 ثانية وبكلفة تقريباً $1. الوقت والتكلفة الفعليين يقدرو يختلفو حسب المزوّد. السكريبت قابل للاستئناف، يعني خدمة العنونة اللي تقطعات ما خاصهاش تبدا من الأول.
الخطوة 2: دير الضبط الدقيق لـ Ettin-17M باستعمال معنويات المعلّم
مرّر ملف المعنويات المولَّدة لسكريبت التدريب واختار مجلد الإخراج:
uv run recipe/train.py data/tasks/agnews --labels labels/agnews-train.jsonl --save models/agnewsالسكريبت كيدير الضبط الدقيق للمصنّف، وكيقيّمو على مجموعة الاختبار، وكيطبع دقّة الاختبار، وكيحفظ نموذج متوافق مع Hugging Face تحت models/agnews.
الخطوة 3: درّب خط أساس بالمعنويات البشرية
شغّل نفس سكريبت التدريب بلا الوسيط ديال معنويات المعلّم باش تدرّب باستعمال المعنويات البشرية الأصلية ديال مجموعة البيانات:
uv run recipe/train.py data/tasks/agnewsهاد المقارنة كتعاون تبان شحال من أداء تضاع أثناء تقطير المعرفة. فالتشغيل التعليمي ديال المستودع، المعنويات البشرية عطاتو دقّة 89.2%، ومعنويات Kimi K3 عطاتو 85.1%، ومعنويات Qwen3.8-27B عطاتو 81.8%.
الخطوة 4: صنّف النص الجديد
حمّل الموديل المحفوظ باستعمال pipeline ديال Hugging Face:
from transformers import pipeline

classify = pipeline(
    "text-classification",
    model="models/agnews",
    device="cpu"
)

result = classify(
    "NASA's new telescope finds water vapour on a distant planet"
)
print(result)
النتيجة هي لائحة فيها التصنيف المتوقَّع والنقطة ديالو. فهاد المثال، التصنيف المنتظر هو Sci/Tech. الموديل ديال AG News المذكور عالج رسالة فحوالي 6 ميلي ثانية على CPU.
استعمل مصنّفات صغار مع الداتا ديالك
1. صايب مجلد ديال المهمة
صايب فولدر بنفس التنظيم ديال data/tasks/agnews/. كل مهمة مخصّصة كتحتاج ملفات task.json وtrain.jsonl وtest.jsonl.
2. حدّد التصنيفات
خاص ملف task.json يكون فيه الاسم، وجملة تعليمية وحدة، واللائحة الكاملة ديال التصنيفات:
{"name":"support-routing","instruction":"Assign each support message to the correct team.","labels":["billing","technical","account"]}استعمل أسامي تصنيفات مختلفة وعندها معنى. خاص التعليمات توضّح مزيان القرار ديال التصنيف اللي خاص الموديل ولا المعلّم ياخدو.
3. زِد سجلات التدريب والاختبار
خزّن object واحد بصيغة JSON فكل سطر. السجل المصنّف عندو هاد الشكل:
{"id":"msg-001","text":"I was charged twice for my subscription.","label":"billing"}إلا كان موديل معلّم غادي يصنّف داتا التدريب، سجلات train.jsonl تقدر ما يكونش فيها الحقل label:
{"id":"msg-002","text":"The application closes whenever I upload a file."}خاص سجلات الاختبار يكون فيها تصنيفات متراجَعة باش تقدر تقيس الدقة ديال المعلّم والطالب بجوج. المشروع كيوصي بمراجعة يدوية ديال بضع مئات من رسائل الاختبار قبل ما تثق فالموديل فالإنتاج.
4. صنّف، درّب، وقيّم
عوّض المسار ديالك فالأوامر المعتادة:
uv run recipe/label.py data/tasks/support-routing
uv run recipe/train.py data/tasks/support-routing \
  --labels labels/support-routing-train.jsonl \
  --save models/support-routing
تقدر حتى تدرّب مباشرة على التصنيفات البشرية بحذف --labels. باش تستعمل encoder آخر بلاصة Ettin-17M، مرّر الموديل عبر الخيار --model ديال سكريبت التدريب.
قِس إمتى كيستاهل الضبط الدقيق
شغّل تحليل نقطة التعادل من بعد ما تجهّز المهام:
uv run recipe/breakeven.pyهاد السكريبت كيقدّر شحال من رسالة خاصها تتصنّف قبل ما ترجع المصاريف الأولية ديال التصنيف والتدريب، مع احتساب الفلوس والوقت بجوج. بالمقارنة مع API ديال التصنيف zero-shot ديال Jev، لقا المستودع نقاط تعادل تقريباً بين 50,000 و500,000 رسالة، على حساب المهمة.
إلا كان الحجم ديالك صغير ولا مازال ما واضحش، API تقدر تكون هي الاختيار الأسهل. الضبط الدقيق كيولي جذّاب أكثر ملي كتكون المهمة مستقرة، وعندك داتا ديال التقييم، وحجم التصنيف كبير.
نصائح متقدمة
عطي الأولوية لجودة التصنيفات
التجارب لقات أن التصنيفات أهم من حجم الموديل. منحنيات التعلّم بقات كتحسّن ملي تزادو الأمثلة المصنّفة. الطالب المدرَّب على يد معلّم بقى عموماً ناقص ببضع نقط فالدقة على المعلّم ديالو، بينما التصنيفات البشرية قدرت تتجاوز هاد السقف.
راجع التصنيفات الغامضة، صحّح أخطاء التصنيف المنهجية، وزِد أمثلة ممثّلة قبل ما تبدّل البنية ولا تضبط بزاف ديال hyperparameters.
قيّم المعلّم بوحدو
الطالب ما يقدرش يعوّض بشكل موثوق معلّماً ضعيفاً فالمهمة. نتائج المهام العشرة بيّنت أن الموديلات المصنّفة من طرف المعلّم تراجعات فالأماكن اللي كان فيها المعلّم نفسو أضعف. خَلّي عندك مجموعة اختبار راجعها الإنسان، وقِس دقة المعلّم قبل ما تخلّص باش تصنّف مجموعة أكبر بزاف.
خد بعين الاعتبار الاختلافات التجريبية
الـ README كيذكر اختلافاً تقريبياً قدره ±0.5 نقطة مئوية بسبب random seeds، و±1.5 حتى 2 نقطة بسبب حجم مجموعة الاختبار. الجداول المنشورة كتستعمل متوسط ثلاث تجارب. استعمل تجارب مكررة ومجموعات اختبار كبيرة كفاية ملي تكون فروقات صغيرة فالدقة كتأثر على قرارات النشر.
احترم التراخيص وشروط المزوّدين
درّب غير على الأجوبة المولَّدة إلا كان ترخيص الموديل المعلّم وشروط المزوّد كيسمحو بهاد الشي. المستودع استعمل Kimi K3، ولكن بعض الموديلات وواجهات API كيمنعو استعمال المخرجات ديالهم لتدريب موديل آخر. حتى مجموعات الداتا العمومية عندها التراخيص ديالها؛ المستودع كيحمّلها وما كيعيدش توزيعها.
جرّب عتاداً بديلاً
سكريبت التدريب الرئيسي كيدعم التنفيذ على CPU وGPU. المستودع فيه حتى تطبيق مستقل للهاتف كيدرّب عبر Chrome باستعمال WebGPU وjax-js. اعتبر مسار الهاتف تطبيقاً مخصّصاً، وتبع التعليمات الموجودة فمجلد phone/ ديال المشروع.
تجاوز مشكل NixOS الموثّق
إلا فشل التدريب على NixOS حيث ما قدرش يلقى /sbin/ldconfig، عيّن مسار مكتبات CUDA قبل تشغيل التدريب:
export TRITON_LIBCUDA_PATH=/run/opengl-driver/libالخلاصة
tiny-classifiers كيوفّر مساراً صغيراً لتحويل النص المصنّف لمصنّف محلي سريع: وجّد المهمة، جيب التصنيفات البشرية ولا ديال المعلّم، دير الضبط الدقيق لـ Ettin-17M، قيّم باستعمال أمثلة متراجَعة، وقدّر واش الاستدلال المحلي أوفر اقتصادياً من API.
أهم درس هو الاستثمار فتصنيفات موثوقة وداتا ديال التقييم. منين كيتوفرو هادو، encoder فيه 17 مليون بارامتر يقدر يقدّم دقة قوية فالتصنيف، واستدلالاً فمستوى الميلي ثانية، وتكاليف تشغيل محلية متوقعة بلا ما تعيط لموديل كبير مع كل رسالة.