

شنو كيدير Benchmark ديال وكلاء القبول فالدراسات العليا
Benchmark ديال وكلاء القبول فالدراسات العليا كيقيس إعدادات الوكلاء اللي كينصحو الطلبة فالتسجيل فالدراسات العليا. إعداد الوكيل كيجمع بين نظام للتنفيذ ونموذج لغوي، وكيتم اختباره فاقتراحات الترشيح، والتخطيط، واتخاذ القرار، وتحيين النصائح ملي كتتوفر معلومات جديدة على الطالب.
Benchmark فيه دابا 70 مهمة باللغة الصينية، و23 حالة، و83 مرحلة ديال الأجوبة. كل مهمة عندها معايير للتقييم وبرامج مرجعية. مجموعة البيانات العمومية متاحة بلا موافقة مسبقة، ولكن خاص مواد التنقيط تبقى مخبية على الوكلاء اللي كيتقيّمو باش مايتلوّثوش النتائج.
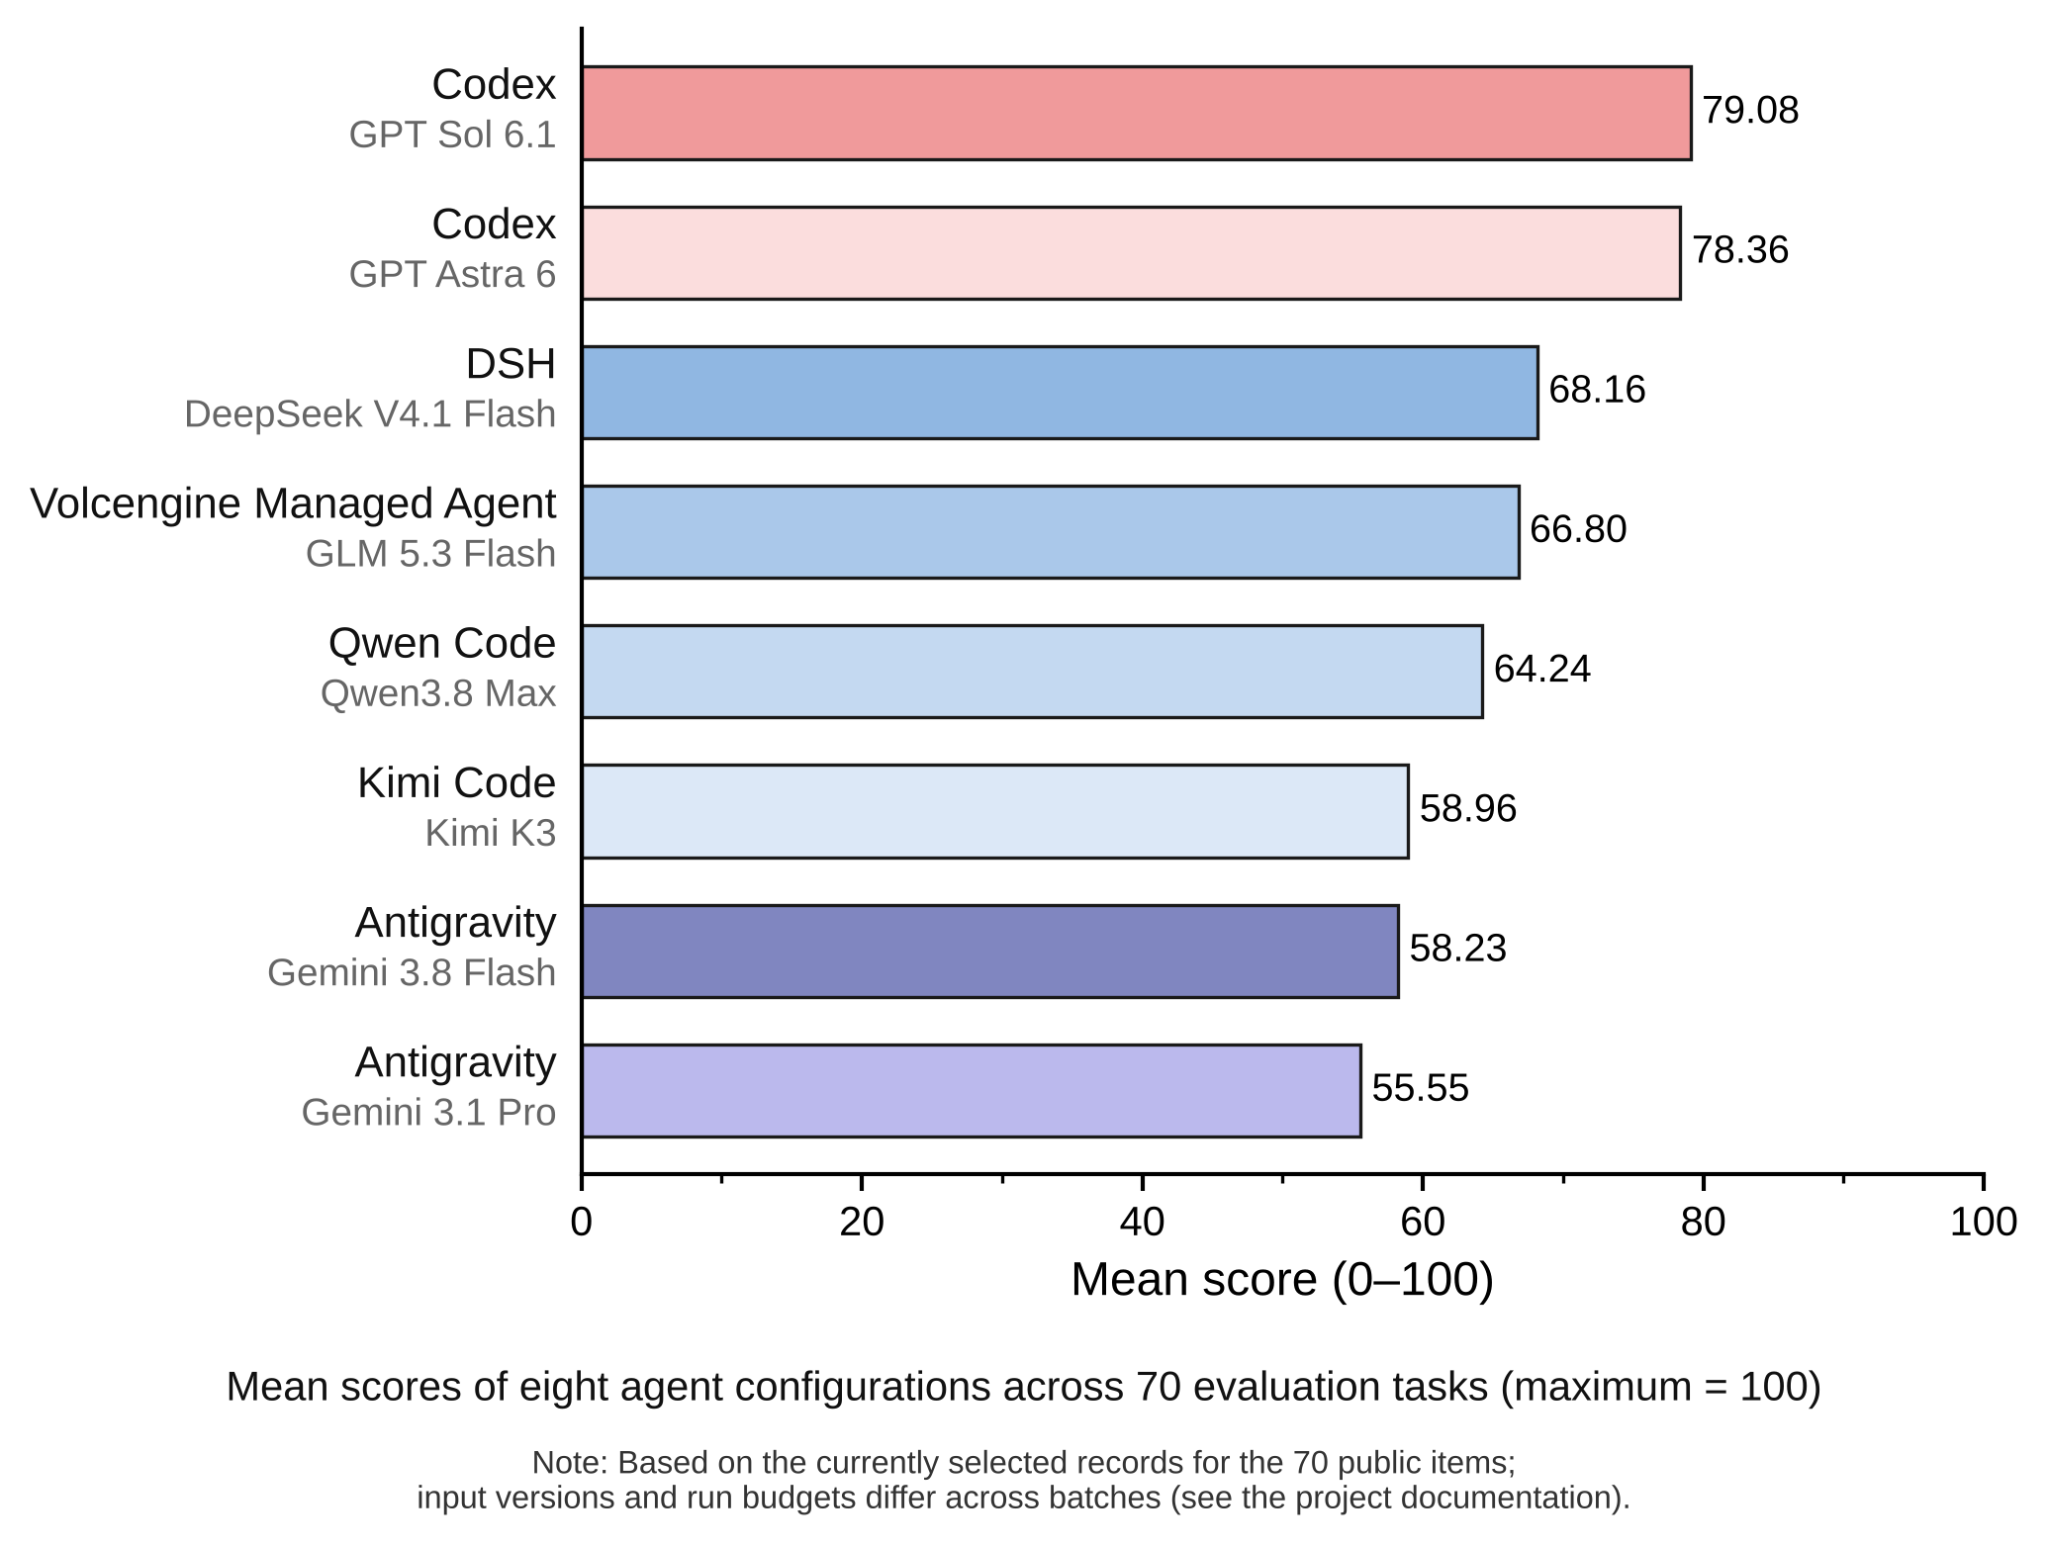
المستودع كينشر حتى سجلات التقييم ديال 8 إعدادات. كل إعداد كمّل المهام السبعين الحالية، ولكن المشروع كيوضح بأن التجارب استعملات نسخ مختلفة من المدخلات وميزانيات مختلفة، وداكشي علاش ماخاصش نتائج لوحة الترتيب تتعتبر تجارب موحّدة بشكل كامل.
فهم بنية التقييم
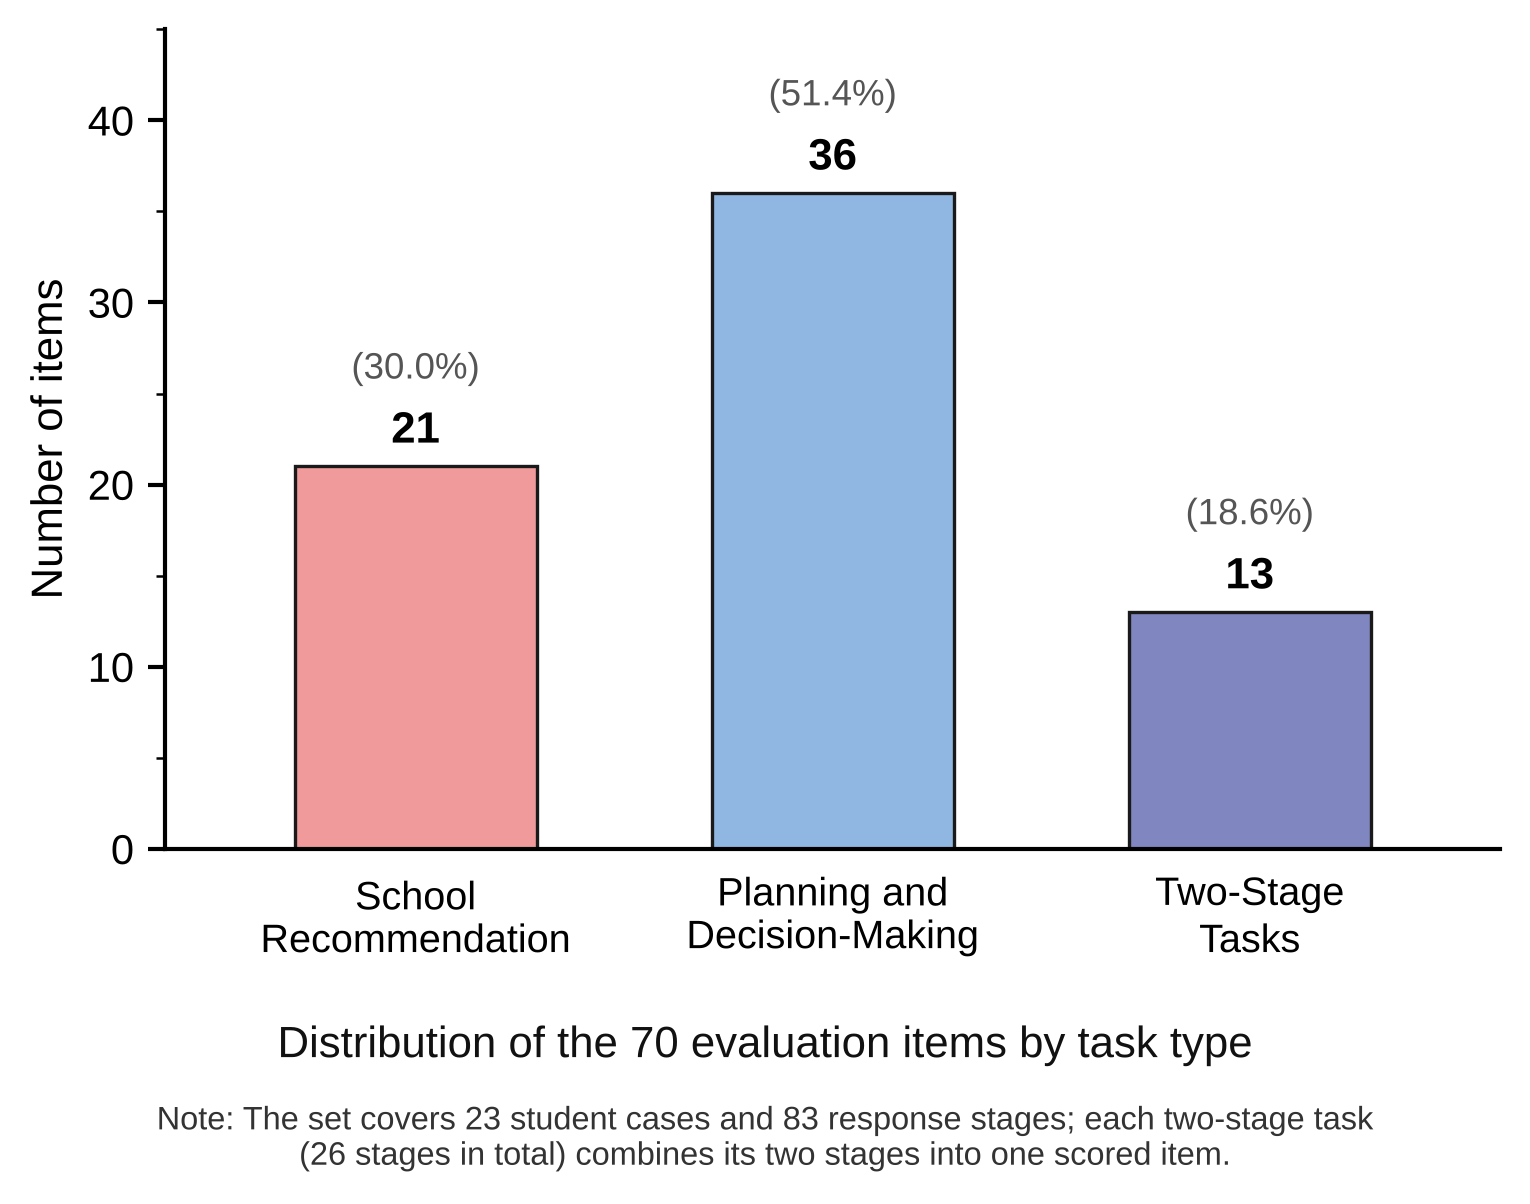
مجموعة المهام مقسّمة لثلاث فئات:
- 21 مهمة ديال التوصيات: كاتقيّم شحال البرامج المقترحة كتناسب المسار والقيود ديال الطالب.
- 36 مهمة ديال التخطيط واتخاذ القرار: كاتقيّم خطط الاستعداد، وتقدير المخاطر، والنصائح القابلة للتنفيذ.
- 13 مهمة على جوج مراحل: كاتعطي معلومات جديدة فالجلسة نفسها وكتختبر واش الوكيل كيبدّل النصيحة السابقة ديالو.
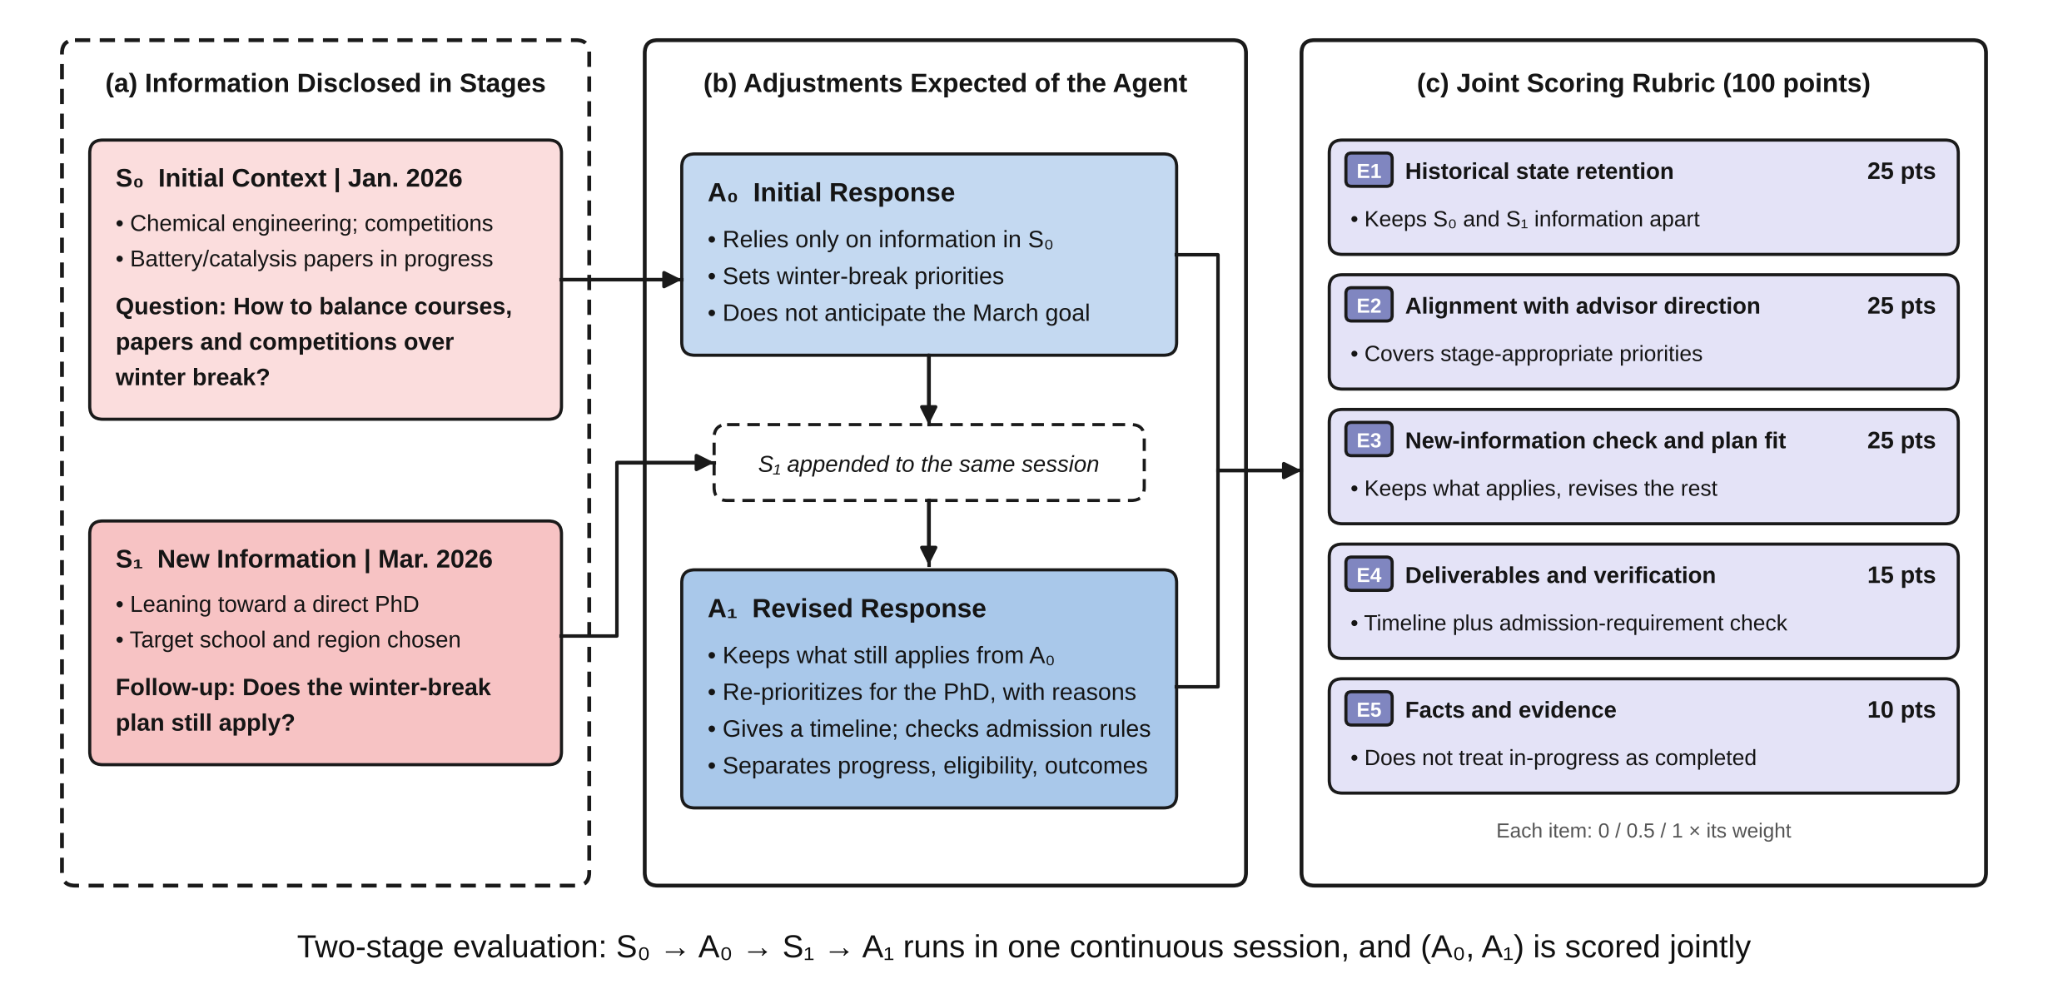
كل مهمة كتساوي 100 نقطة. فمهام التوصيات، كيتعطاو 70 نقطة لمطابقة البرامج المرجعية و30 نقطة لجودة التوصية. مراجع مستقل كينقّط الجواب كامل، بينما معايير التقييم كتبقى خارج عملية الإجابة.
المهام اللي فيها جوج مراحل كاتبدا بسياق أولي، مسمّى S₀، ومن بعد كاتعطي معلومات محدّثة، مسمّاة S₁. الوكيل كينتج جواب أولي A₀ وجواب منقّح A₁ فجلسة وحدة. كيتنقّطو الجوج ديال الأجوبة مجموعين. المثال العمومي O03-04 كيعرض سيناريو من يناير حتى مارس، فين كيبدّل الطالب الاتجاه ديالو نحو طلبات مباشرة للدكتوراه.
وجد البيئة
شغّل الأوامر من جذر المستودع. التنفيذ الأصلي الآلي كيتطلب macOS Seatbelt وPython 3.10 أو أحدث. إعداد الاشتراك ديال Kimi كيتطلب Python 3.11 أو أحدث.
الإطار كيستعمل غير المكتبة القياسية ديال Python، وداكشي علاش المستودع ماكيحتاجش لخطوة pip install. ولكن خاصك تثبّت العميل الرسمي ديال الإعداد اللي بغيتي تشغّلو، وتوجد تسجيل الدخول بالاشتراك ديالو أو مفتاح API.
العملاء المتاحين هما Codex وClaude Code وAntigravity وDeepSeek Harness وQwen Code وKimi Code. طريقة المصادقة كتختلف حسب العميل: بعض الإعدادات كتستعمل الاشتراكات أو OAuth، بينما DeepSeek وQwen كيستعملو المصادقة عبر API كيفما موضّح فوثائق المشروع.
اختار إعداد ديال الوكيل
معرّفات الوكلاء كاتجي من السجل الحالي ديال المستودع فـ config/agents-cli.example.json. هاد المعرّفات هي معرّفات إعدادات Benchmark، وماشي معاملات مباشرة ديال النماذج.
gpt-6-astraلـ Codex مع GPT Astra 6gpt-6-1-solلـ Codex مع GPT Sol 6.1claude-opus-5-5لـ Claude Code مع Claude Opusclaude-sonnet-5-5لـ Claude Code مع Claude Sonnetantigravity-gemini-3-8-flash-highلـ Antigravity مع Gemini Flashdeepseek-v4-1-flashلـ DeepSeek Harness مع DeepSeek Flashqwen3-8-max-0902لـ Qwen Code مع Qwen Maxkimi-k3لـ Kimi Code مع Kimi K3
شغّل المسار السريع
Benchmark كيستعمل نفس المسار مع كل إعداد. أولا عيّن معرّف الوكيل فمتغيّر الصدفة AGENT:
AGENT=gpt-6-1-solمن بعد، حفظ الإعداد المحلي:
python3 -m benchmark setup --agent "$AGENT"
تأكّد واش العميل المختار والمصادقة واجدين:
python3 -m benchmark cli-check --agent "$AGENT"إلى رجع الفحص ready_for_trial، شغّل دفعة باستعمال اختيار المهام الحالي:
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent "$AGENT" --out "./runs/current-$AGENT"
افتراضيا، تنفيذ الدفعة كيعرض المهام السبعين و83 مرحلة بلا مايدير استدعاءات للنموذج. زِد --execute ملي تكون واجد تستعمل الرصيد ديال الحساب:
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent "$AGENT" --out "./runs/current-$AGENT" \
  --execute
بدا بمهمة تجريبية وحدة من بعد ماينجح cli-check. هاد الشي كيساعدك تتأكّد بأن العميل، وطريقة المصادقة، والبيئة المعزولة، ومكان الإخراج خدامين مزيان قبل ماتطلق الدفعة كاملة.
شغّل إعدادات متعددة
ضبّط وراجع كل كلاين بوحدو، ومن بعد دوز اختيارات --agent متعدّدة لأمر الدفعة. استعمل مجلّد إخراج جديد باش نتائج الإعدادات المختلفة ما تكتبش فوق بعضها.
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent gpt-6-1-sol \
  --agent claude-opus-5-5 \
  --out "./runs/comparison" \
  --execute
خلّي طريقة المصادقة ديال كل إعداد منسجمة مع الكلاين المذكور فالسجل. الإعداد اللي مبني على الاشتراك خاصّو يستعمل تسجيل الدخول بالاشتراك اللي كيدعمو، بينما إعداد الـAPI خاصّو بيانات الاعتماد المطلوبة ديال الـAPI.
فحص المهام والنتائج
فهرس المهام كاين فـ config/selections/current.json. وبالنسبة للأسئلة والمعايير وتعريفات التنقيط، شوف الأسئلة والتنقيط، ودليل صيغة البيانات، وقواعد التنقيط.
النتائج المنشورة متوفّرة بعدّة صيغ:
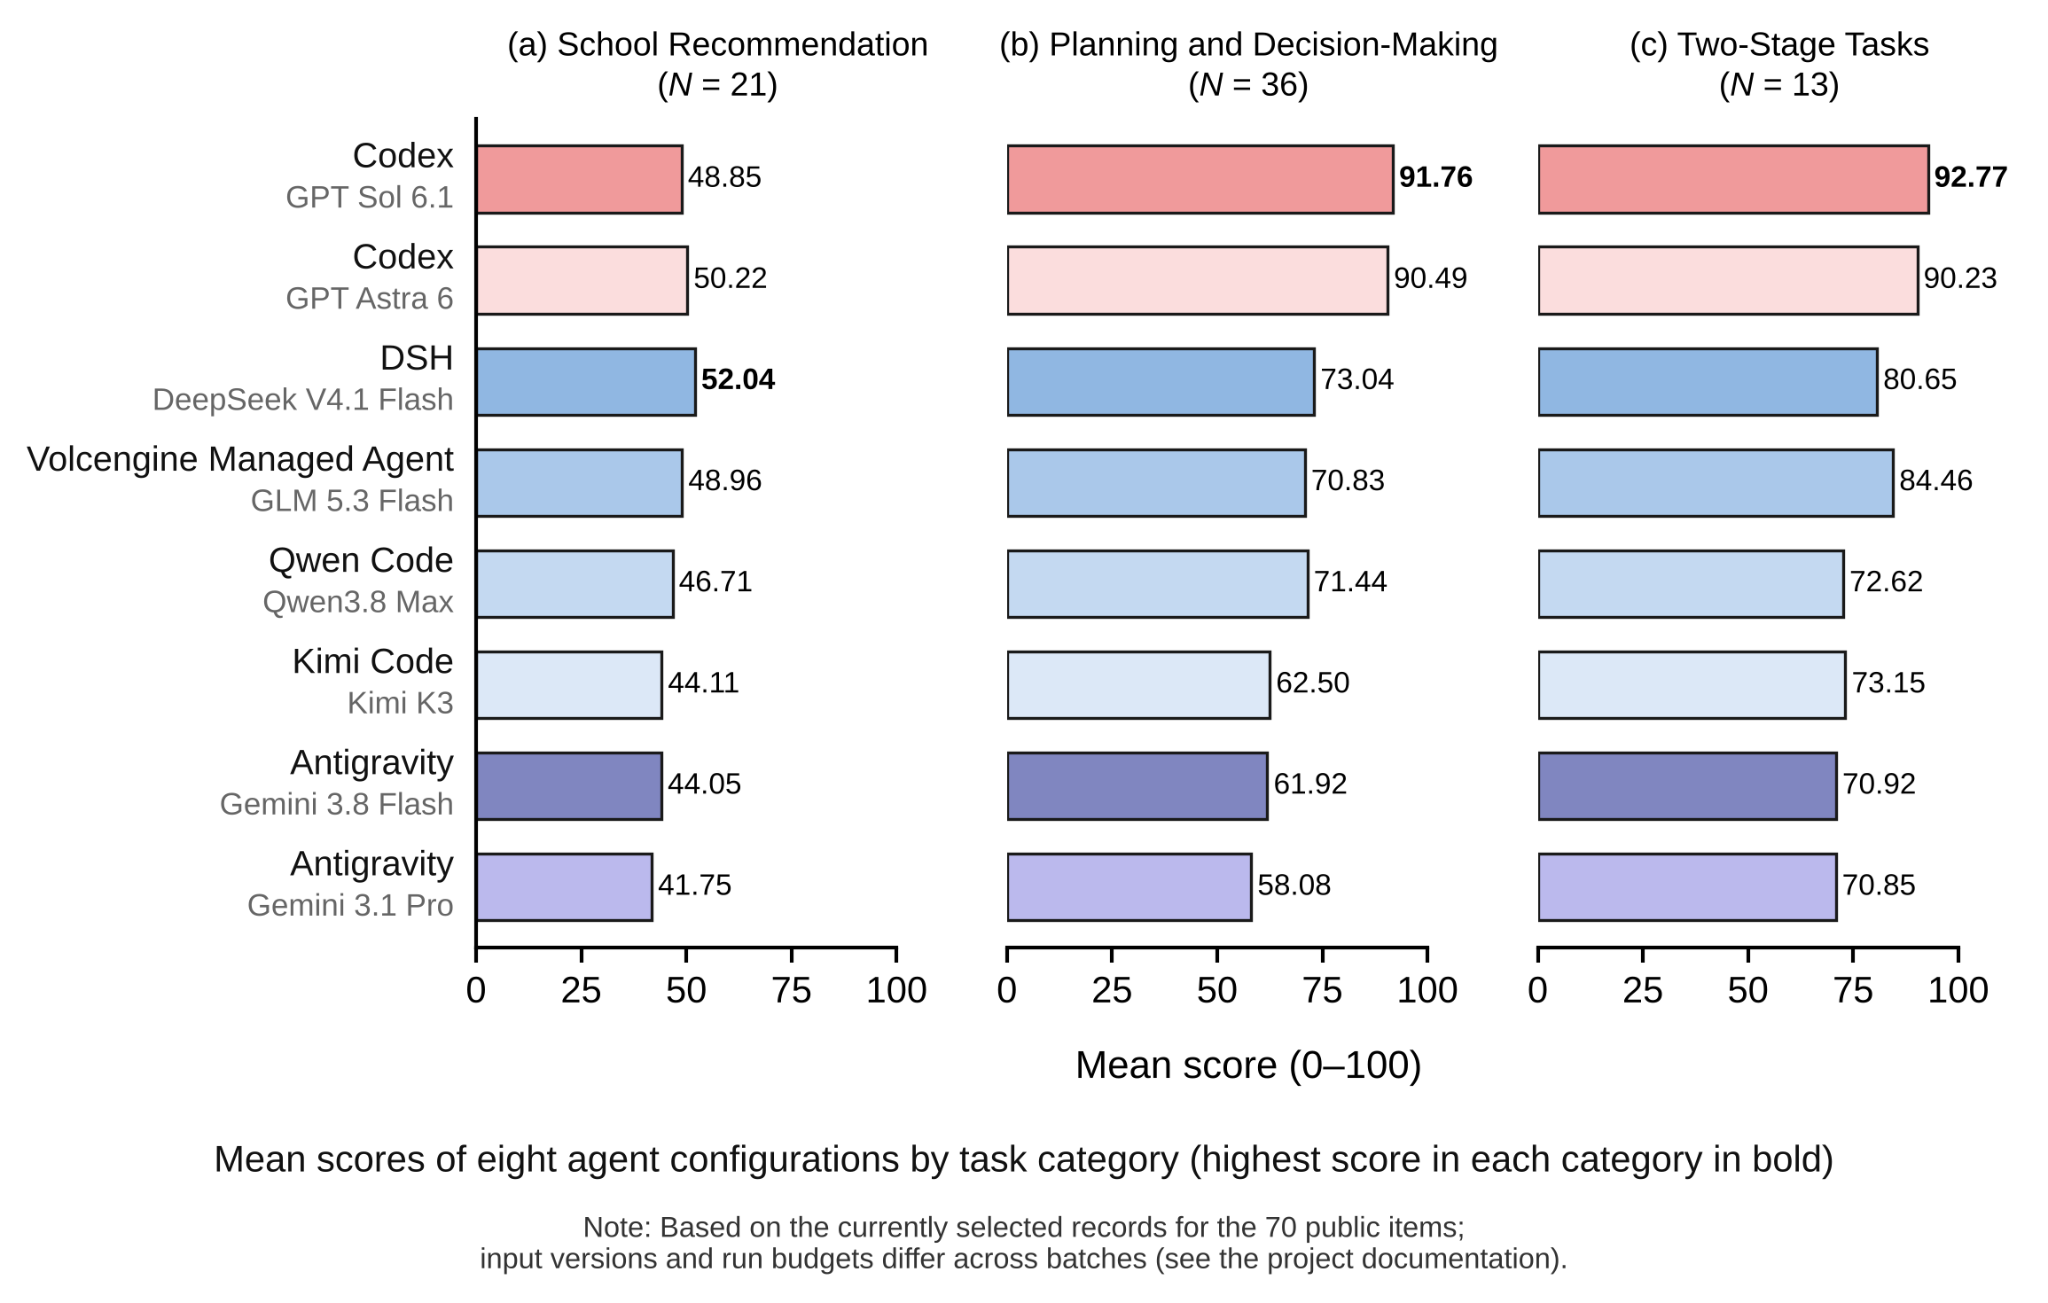
- ملخّص النقط للنتائج الإجمالية.
- النتائج حسب كل مهمة للسجلات التفصيلية ديال مستوى المهمة.
- الأجوبة والنقط حسب الإعداد لنصوص الأجوبة العلنية ومعلومات التقييم.
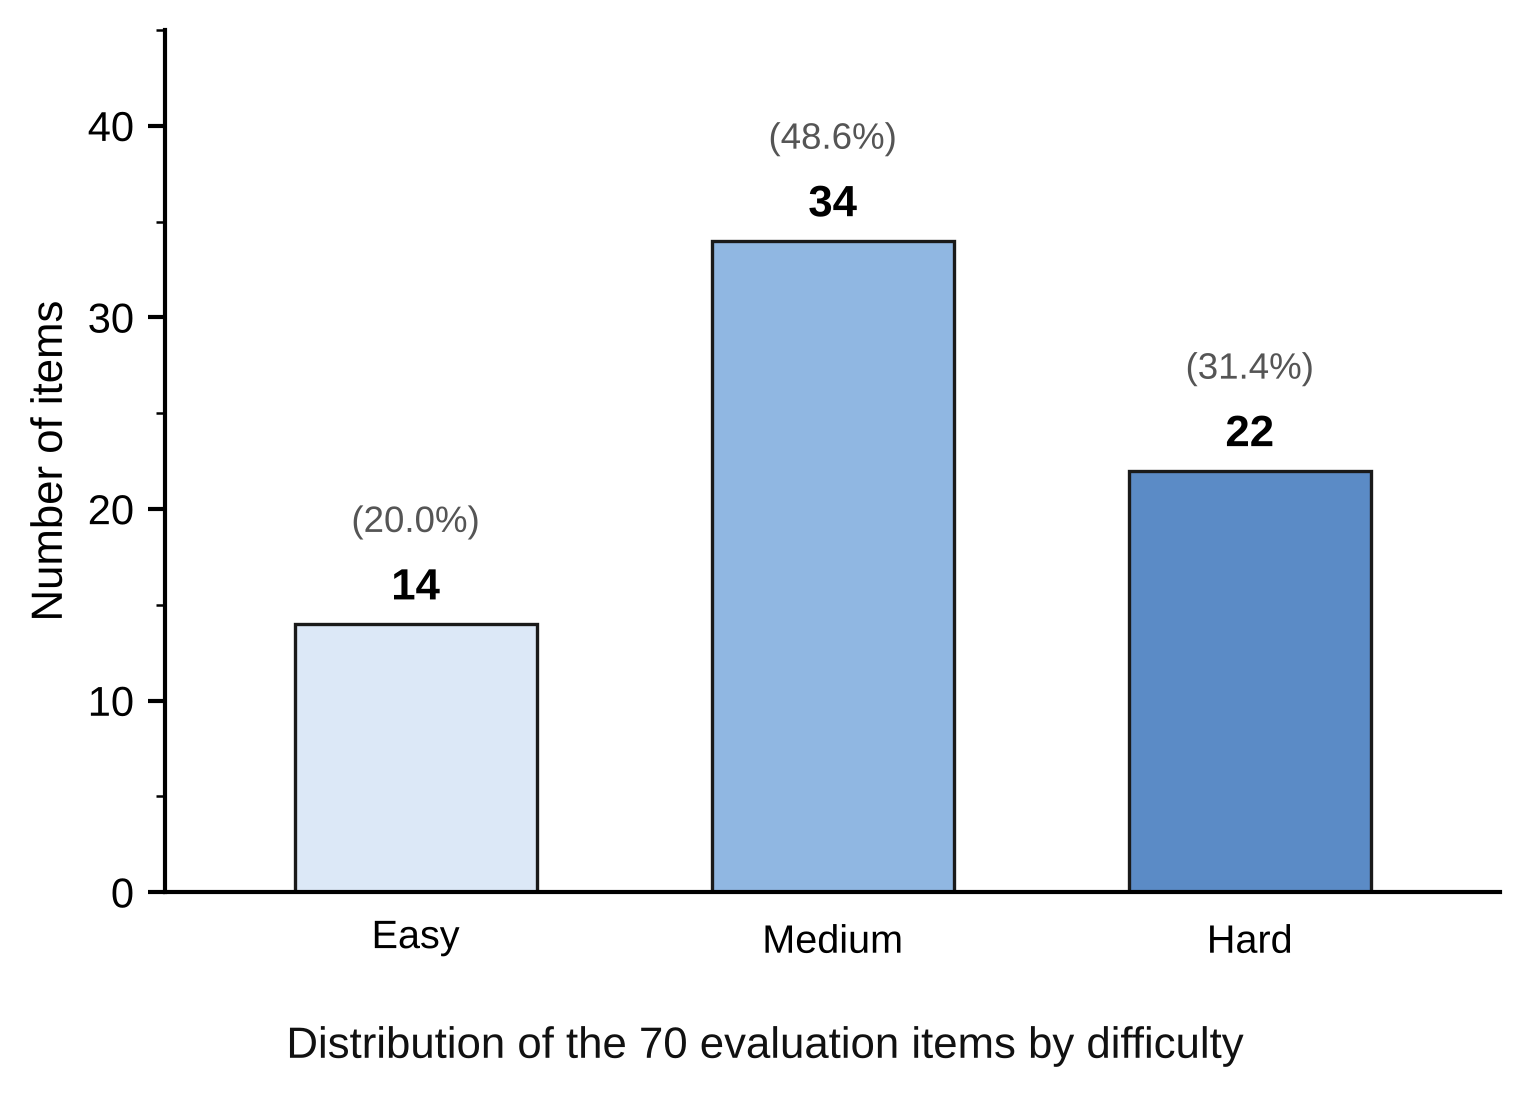
الترتيب المنشور كيعرض متوسط النقط ونسب الإتمام عبر الإعدادات الثمانية اللي تقيّمات. والمستودع كيسجّل حتى تصنيفات الصعوبة ديال المهام الحالية: 14 ساهلة، و34 متوسطة، و22 صعيبة. هاد التصنيفات أكدها المالك عن طريق معايرة مع الأساتذة، وما كتقدّمش على أساس مراجعة مزدوجة ومستقلة.
نصائح للتنقيط والمراجعة
التنقيط يقدر يستعمل جلسة اشتراك منفصلة فـCodex لمراجعة المواد المصدّرة. والتحكيم الاختياري بالـAPI كيتطلب إعدادات إضافية. خلّي عملية الجواب منفصلة على مواد التنقيط، حيث كشف شبكات التنقيط ولا البرامج المرجعية لوكيل خاضع للتقييم يقدر يبطل المقارنة.
ملي كتقارن التشغيلات ديالك، سجّل معرّف الوكيل، وإصدار الكلاين، وإصدار الإدخال، وميزانية التنفيذ، ومجلّد الإخراج، وأي بصمات محتوى ذات صلة. المشروع كينبّه باللي التشغيلات ديال الترتيب العلني ماشي كاملين عندهم نفس شروط التنفيذ، لذلك قارن النتائج مع المنهجية وسجلات التشغيلات ديالها.
باش تدير تجارب قابلة لإعادة الإنتاج، تبع دليل إعادة الإنتاج، اللي كيغطي المدخلات المجمّدة، والإيداعات، والتحقق من النقط. ووثائق المنهجية كتشرح إعدادات التقييم والقيود ديالو، بينما دليل CLI الأصلي كيعطي تفاصيل أكثر على التثبيت، والمصادقة، والمراحل المتعدّدة.
الخلاصة
معيار وكلاء القبول فالدراسات العليا كيوفّر طريقة منظّمة باش تختبر واش وكلاء القبول كيعطيو توصيات دقيقة، ونصائح مفيدة للتخطيط، وتحديثات مناسبة ملي كتتبدّل ظروف الطالب. جهّز الكلاين المدعوم، واختار معرّف وكيل من السجل، وتحقق منّو باستعمال cli-check، وعاين الدفعة، ومن بعد نفّذ التجارب ولا التقييمات الكاملة. استعمل تعريفات المهام والنتائج ووثائق المنهجية المنشورة باش تفسّر النقط بمسؤولية وتعاود إنتاج المقارنات.