

نظرة عامة
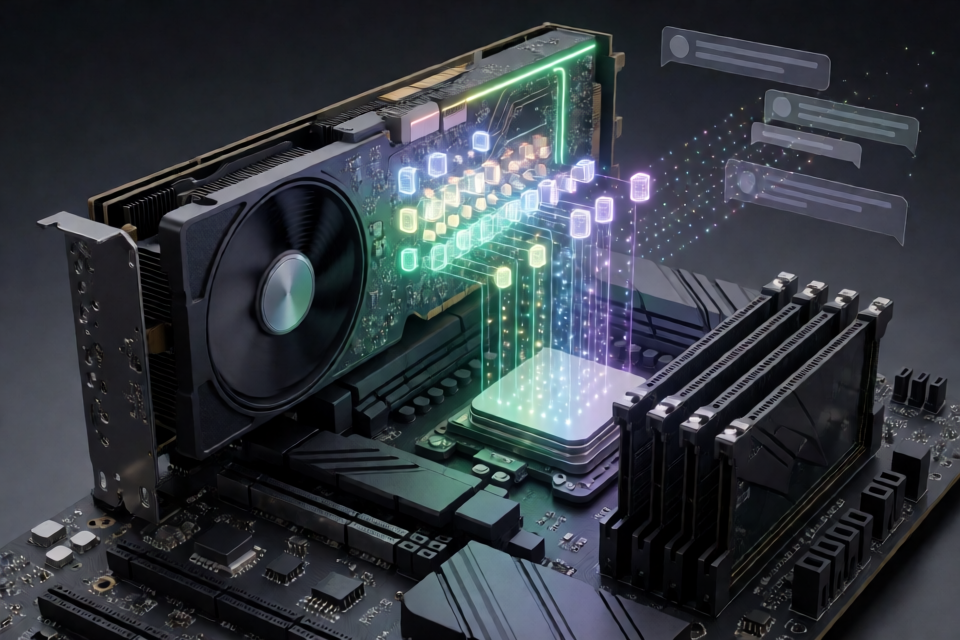
glm53-flash-offload كيخدم نسخة GLM-5.3-Flash بحجم 125.3 GB وبصيغة EXL3 3.05-bpw فوق GPU NVIDIA وحدة بذاكرة 24 GB، مع ذاكرة DDR4 ديال الجهاز. كيوفّر HTTP API متوافق مع OpenAI، وكيخلي أوزان mixture-of-experts الموجّهة ديال الموديل أساساً فـ RAM ديال السيستيم المثبّتة.
المشروع عبارة على مجموعة خفيفة ديال monkeypatches فوق exllamav3 1.5.1 الرسمي، مكمّلة بشوية ديال kernels مخصّصين صغار. ما كيحتاجش تعديل source ديال exllamav3. الإعداد الموثّق تقاس فوق RTX 3090 مربوط عبر PCIe 4.0 x16 بسيستيم AMD EPYC 7443P.
الفكرة الرئيسية هي تخلي الخبراء اللي كيتستعملو بزاف فـ cache مرنة فـ GPU. الخبراء اللي ما لقاوش بلاصتهم فـ cache يقدرو يتقراو مباشرة من الذاكرة ديال الجهاز المثبّتة عبر PCIe. فـ fast mode، الــdecode misses الباردين بزاف يقدرو يتعالجو بلاصة هاد الشي من طرف worker ديال CPU خدام بـ AVX2.
المزايا الرئيسية
- النشر فوق GPU وحدة: كيخدم GLM-5.3-Flash بـ RTX 3090 من فئة 24 GB وحدة.
- API متوافق مع OpenAI: كيدعم chat completions وtext completions واكتشاف الموديلات وstreaming ومحتوى reasoning وtool calls على طريقة OpenAI.
- تخزين pinned بلا نسخ: جميع الخبراء الموجّهين كيتحطّو فـ RAM ديال الجهاز المثبّتة، ويقدرو يوصلو ليهم عبر CUDA unified virtual addressing.
- Cache مرنة لخبراء GPU: الخبراء السخونين كيشدو VRAM المتوفرة، ومساحة cache تقدر مؤقتاً ترجع للاستعمال ديال activations ديال prefill الطويلة وstaging buffers.
- Staging ديال prefill: الخبراء اللي ماشي فـ cache كيتنسخو بطبقة وحدة لقدّام، باش نقل البيانات عبر PCIe يقدر يتزامن مع الحساب.
- طبقة CPU اختيارية: fast mode كيسند بعض decode misses الباردين لـ kernel ديال CPU خدام بـ AVX2.
- Decode على دفعات: حتى لأربع streams يقدرو يديرو decode مجموعين بالإعداد الموثّق
-ambs 4. - إعداد قابل لإعادة الإنتاج: revision ديال الموديل وcontainer digest ونسخة exllamav3 واختيارات Triton والـbenchmarks وreference quality panel كاملين مثبّتين.
اختار بين fast mode وexact mode
السيرفر كيوفّر جوج ديال modes عبر environment variable سميتها GLM53_MODE.
Fast mode
fast هو الإعداد الافتراضي. كيجمع بين cache ديال خبراء GPU، وcache misses بلا نسخ، ومعالجة AVX2 فـ CPU لبعض decode misses الباردين، وbatched decode، وkernels مدموجين ديال decode. فوق الجهاز اللي تقاس، استعمل تقريباً 218 GiB، يعني 234 GB، من RAM ديال الجهاز.
الحملة المنشورة قاست تقريباً 28.15 token فالثانية لـ decode stream واحد، و31.57 token فالثانية كمجموع جوج streams، و33.98 token فالثانية كمجموع أربعة streams. اختبار image smoke ديال digest الحالي قاس على التوالي 28.88 و31.27 و35.00 token فالثانية كمجموع.
تحذير بخصوص الجودة: prefill دقيق، ولكن decode فـ fast mode ماشي bit-exact مقارنة مع exllamav3 الرسمي. فحص مزدوج للـdecode عطى mean KL بقيمة 0.0053 واتفاق top-1 بنسبة 0.977. استعمل exact mode ملي كتكون مطابقة المخرجات ضرورية.
Exact mode
exact كيعطّل CPU tier وkernels ديال decode الخاصة بـ fast mode. وكيحتافظ بـ cache ديال خبراء GPU وبـ zero-copy ديال cache misses من ذاكرة الجهاز. الـreference panel قاس اتفاق top-1 بنسبة 1.0000 وKL بقيمة 0، واستعمال ذاكرة الجهاز كان تقريباً 111 GiB، يعني 119 GB.
Exact mode أبطأ ولكن كيستعمل RAM أقل بزاف. معدل decode المقاس فـ stream واحد كان 12.57 token فالثانية فـ context أقصر من اللي تختبر، مقارنة مع تقريباً 7.5 حتى 8.4 token فالثانية ملي exllamav3 الرسمي كان كيحط الخبراء اللي ما كيدخلوش فـ CPU worker ديالو.
متطلبات العتاد والبرمجيات
GPU والـdriver
- GPU NVIDIA وحدة بذاكرة VRAM قدرها 24 GB.
- GPU من نوع
sm_86بحال RTX 3090 ولا A5000 هو الهدف اللي تقاس؛ - الـbinaries المرفقة ديال
sm_86خدامة حتى فوقsm_89، بما فيه RTX 4090، ولكن هاد الإعداد ما تقاسش. - خاص driver ديال NVIDIA قادر على CUDA 13.0، حيث image كتستعمل CUDA 13.0.3.
- مستحسن PCIe 4.0 x16. cache misses كيستهلكو تقريباً 25 GB/s فوق الرابط اللي تقاس.
ذاكرة الجهاز
- Fast mode: 256 GiB ديال الذاكرة الإجمالية هو الحد الأدنى ملي ما كايناش خدمة أخرى كثيرة؛ وكيستحسن 320 GB ولا أكثر. إلا تستعملات Docker memory limits، خلّي على الأقل
230g. - Exact mode: 128 GiB هو الحد الأدنى، وكيستحسن 160 GB ولا أكثر.
CPU والتخزين
- Fast mode كيحتاج CPU x86-64 فيه AVX2 وFMA وF16C.
- كيستحسن تقريباً 24 core فعلي وDDR4 بثمانية قنوات ولا أحسن باش توصل للسلوك المقاس ديال fast mode.
- الـcheckpoint كياخذ تقريباً 117 GiB، يعني 125.3 GB، فالديسك.
- كيستحسن تخزين NVMe باش ينقص وقت تحميل الموديل.
- خاص Docker وNVIDIA Container Toolkit وHugging Face CLI للإعداد الموثّق.
ثبّت وبدا السيرفر باستعمال Docker
الخطوة 1: حمّل الـcheckpoint
حمّل الـcheckpoint المثبّت 3.05-bpw فـ directory محلية:
hf download turboderp/GLM-5.3-Flash-exl3 \
  --revision 3.05bpw \
  --local-dir /data/GLM-5.3-Flash-exl3-3.05bpw
تقدر حتى تركّب directory خاوية فـ /models. إلا كان config.json ناقص، الـcontainer كيحمّل الـcheckpoint المهيّأ لذاك directory.
الخطوة 2: شغّل fast mode
الأمر التالي كيبدا السيرفر فوق GPU 0 وكيخرجو فـ port 30000. كيستعمل image digest اللي فيها الإصلاح ديال streaming delivery.
docker run -d \
  --name glm53 \
  --gpus '"device=0"' \
  --ulimit memlock=-1 \
  --shm-size 16g \
  -p 30000:30000 \
  -v /data/GLM-5.3-Flash-exl3-3.05bpw:/models \
  ghcr.io/0xsero/glm53-flash-offload@sha256:bb633b0bcb85573ad40b6c408af5e1036ae062c593e42479f4e4d2ab521e551d
الإعداد --ulimit memlock=-1 موصى به حيت السيرفر كيحجز كميات كبيرة من الذاكرة ديال الجهاز المضيف. الصورة المنشورة خدامة حتى بلا هاد الإعداد فالدرايفر اللي تقاس، ولكن ما خاصش نفترضو نفس السلوك فكل جهاز مضيف.
الخطوة 3: راقب الإقلاع
docker logs -f glm53تسنى حتى تبان رسالة فيها loaded in ... s. الإقلاع كياخد تقريباً بين جوج وثلاث دقايق فالنظام الموثق، على حساب الكاش وظروف الجهاز المضيف.
الخطوة 4: تأكد من الحالة
curl -s http://localhost:30000/healthتشغيل الوضع الدقيق
باش تعطي الأولوية لتطابق المخرجات وتنقص استهلاك ذاكرة الجهاز المضيف، زيد -e GLM53_MODE=exact:
docker run -d \
  --name glm53-exact \
  --gpus '"device=0"' \
  --ulimit memlock=-1 \
  --shm-size 16g \
  -p 30000:30000 \
  -e GLM53_MODE=exact \
  -v /data/GLM-5.3-Flash-exl3-3.05bpw:/models \
  ghcr.io/0xsero/glm53-flash-offload@sha256:bb633b0bcb85573ad40b6c408af5e1036ae062c593e42479f4e4d2ab521e551d
ما تشغلش أمثلة السرعة والدقة فنفس البورت فنفس الوقت. وقف وحيد الكونتينر الأول قبل ما تبدل الوضع:
docker rm -f glm53الاستعمال الأساسي ديال API
صيفط إكمال محادثة
curl -s http://localhost:30000/v1/chat/completions \
  -H 'content-type: application/json' \
  -d '{"model":"glm-5.3-flash","messages":[{"role":"user","content":"Explain zero-copy model offloading."}],"max_tokens":512}'
الاسم الافتراضي ديال الموديل اللي كيتقدّم هو glm-5.3-flash. إلا ما تدارش ليه إعدادات بشكل صريح، فـ max_tokens كيتحدد افتراضياً حسب السياق المتبقي، وما كيتحصرش فقيمة صغيرة ثابتة.
عطّل التفكير
استدلال GLM كيرجع فـ reasoning_content. باش تعطل التفكير فطلب معيّن، مرّر خيار ديال قالب المحادثة:
curl -s http://localhost:30000/v1/chat/completions \
  -H 'content-type: application/json' \
  -d '{"model":"glm-5.3-flash","messages":[{"role":"user","content":"Reply with one sentence."}],"chat_template_kwargs":{"enable_thinking":false},"max_tokens":128}'
بثّ الرد
curl -N http://localhost:30000/v1/chat/completions \
  -H 'content-type: application/json' \
  -d '{"model":"glm-5.3-flash","messages":[{"role":"user","content":"Write a short explanation of mixture-of-experts models."}],"stream":true,"max_tokens":512}'
استعمل الـ digest المثبت bb633b0b... اللي باين لفوق. الصورة الأقدم 1159044a... كانت كتولّد بالسرعة الكاملة، ولكن كانت كتوصّل أحداث البث تقريباً بنص السرعة قبل ما تفرّغ التراكم فالآخر.
عرض الموديلات المتاحة
curl -s http://localhost:30000/v1/modelsفحص إحصائيات التشغيل
curl -s http://localhost:30000/statsنقطة الإحصائيات كتضم معلومات على إصابات كاش الخبراء وعدادات طبقة CPU. كاينين حتى نقاط نهاية إضافية بحال /v1/completions و/server_info والمسارات اللي على شكل SGLang: /generate و/tokenize.
النشر نصّي فقط. برج الرؤية ديال نقطة التحقق ما كيتحمّلش.
استعمال الأدوات على طريقة OpenAI
نقطة المحادثة كتقبل حقل tools. تعبيرات الأدوات اللي كينتجها GLM بصيغة <tool_call> الداخلية كيتحوّلو فالإجابة لصيغة tool_calls المتوافقة مع OpenAI. بالتالي تطبيقات العميل تقدر تستعمل الحلقة العادية ديال استدعاء الأدوات: صيفط تعريفات الأدوات، فحص استدعاء الأداة ديال المساعد، نفّذ الدالة، ورجّع نتيجة الأداة فـ رسالة أخرى.
ضبط السياق ومعاملات السيرفر
المعاملات اللي كتتحط من بعد اسم الصورة كتزاد لأمر السيرفر، وآخر قيمة هي اللي كتغلب. مثلاً، استعمل كاش KV فيه 65,536 توكن بهاد الشكل:
docker run -d \
  --name glm53-64k \
  --gpus '"device=0"' \
  --ulimit memlock=-1 \
  --shm-size 16g \
  -p 30000:30000 \
  -v /data/GLM-5.3-Flash-exl3-3.05bpw:/models \
  ghcr.io/0xsero/glm53-flash-offload@sha256:bb633b0bcb85573ad40b6c408af5e1036ae062c593e42479f4e4d2ab521e551d \
  -cs 65536
كاش KV أصغر يقدر يخلي بلاصة لمزيد من خانات كاش الخبراء. إعدادات الاختبار المنشورة استعملات كاش KV فيه 131,072 توكن، والحد الأقصى لحجم الدفعة هو ثمانية، وحجم القطعة هو 8,192 توكن.
التثبيت بلا Docker
التثبيت الأصلي كيحتاج exllamav3 1.5.1 مبني للـ GPU المستهدف. من نسخة مستنسخة من المشروع، شغّل مثبّت الإضافة ومن بعد شغّل نقطة الدخول المتوفرة مع تحديد مسارات المستودع والموديل:
scripts/install.sh
GLM53_ROOT=$PWD \
GLM53_MODEL_DIR=/path/to/model \
docker/entrypoint.sh
المثبّت كيبني الإضافات المخصصة ديال المشروع. Docker كيبقى المسار الأكثر قابلية لإعادة الإنتاج حيت كيثبّت CUDA وPyTorch وTriton وSGLang وexllamav3 ونسخة المشروع وإعدادات السيرفر المختبرة.
التحقق من الجودة والأداء
قيّم اللوحة المرجعية
من نسخة مستنسخة من المستودع، استعمل عميل الاختبار المرفق اللي كيحتاج غير المكتبة القياسية:
python3 bench/score_ref_panel.py \
  --url http://127.0.0.1:30000 \
  --panel reference/glm-5.3-flash-exl3-ref-panel.json \
  --out score.json
خاص اللوحة الموجّهة من طرف المدرّس تعطي توافق top-1 بقيمة 1.0000 وKL بقيمة 0 فالوضعين السريع والدقيق. هاد اللوحة كتقيّم مسار الملء المسبق أو المسار الموجّه من طرف المدرّس، وما كتثبتش أن فكّ الترميز التلقائي فالوضع السريع دقيق.
شغّل اختبار السرعة
python3 bench/sweep.py \
  --url http://127.0.0.1:30000 \
  --card rtx-3090-24gb/glm-5.3-flash-offload \
  --template glm \
  --config "bb633b0b fast" \
  --prefill 8192 32768 \
  --conc 1 2 4 \
  --reps 3 \
  --dec-reps 2 \
  --no-early-exit \
  --out sweep.json
تأكّد من التوصيل بالتدفق
python3 bench/stream_rate.py --url http://127.0.0.1:30000النتيجة الناجحة خاصها تبيّن باللي النص كيوصل بشكل منتظم، وماشي تقريباً نصّ الاستجابة كيبان دفعة وحدة فالأخير.
الضبط المتقدّم
حدّد حجم طبقة CPU
افتراضياً، GLM53_CT_CPUS=auto كيختار CPU منطقي واحد لكل نواة فعلية، وكيخلّي أول جوج ديال النوى الفعلية متاحين للنظام ولخيط Python اللي كيسوق الـGPU. فالآلة المضبوطة اللي فيها 24 نواة، هاد الشي عطى CPUs من 2 حتى 23 و22 خيط خدمة.
إلى بغيتي تعيين صريح، استعمل قيم بحال:
-e GLM53_CT_CPUS=2-23 \
-e GLM53_CT_THREADS=22
نموذج كلفة CPU كيستعمل GLM53_CT_B، اللي تقاس بـ0.104 ميلي ثانية لكل expert مع 22 خيط. بالنسبة لـN خيوط خدمة، الـREADME كينصح تقدّرو بهاد الشكل: 0.104 x 22 / N. مثلاً، آلة فيها 16 نواة وكتخلّي جوج نوى فارغين تستعمل 14 خيط خدمة وقيمة قريبة لـ0.16.
إلى كان عندك أقل تقريباً من 12 نواة فعلية، فالمتوقّع أن أغلب الـmisses يرجعو لمسار PCIe، وبهذا الأداء يقرب من وضع exact. فهاد الحالة، وضع exact يقدر يكون هو الاختيار الأحسن.
تحكّم فتنظيم ذاكرة طبقة CPU
GLM53_CT_SWZ=1 كيخلّي طبقة CPU تستعمل نسخة منفصلة ومتجاورة على شكل كتل من الـexperts. هادي هي الضبطية السريعة اللي تقاست، وكتزيد تقريباً 114.2 GB من استعمال RAM. إلى ضبطتيها على 0، طبقة CPU كتقرا مباشرة النسخة الأصلية المثبّتة، وهاد الشي كينقص استعمال الذاكرة بشكل كبير، ولكن المشروع ككيقول إن benchmark ديال CPU expert kernel أبطأ تقريباً بـ40%. الأداء من البداية للنهاية بهاد الضبطية ما تقاسش.
ضبط احتياطات الكاش
GLM53_EC_RESERVE_GB كيخلّي VRAM فارغة من بعد تخصيص expert cache. القيم الافتراضية هي 1.5 GB فالوضع السريع و1.0 GB فالوضع الدقيق. خلّي الاحتياط ديال الوضع السريع فـ1.5 GB إلا إلا كانت عمليات prefill الطويلة كتسالي بذاكرة ناقصة.
GLM53_EC_ELASTIC_GB القيمة الافتراضية ديالها هي 10 GB. هاد المقدار من ذاكرة الكاش يقدر يتحرّر باش يستعملوه prefill activations وstaging، ومن بعد يرجع يتستعمل فـdecode. GLM53_EC_STAGE_GB القيمة الافتراضية ديالها هي 2.6 GB لكل staging buffer، وكيتستعملو جوج buffers للتداخل.
استعمل GPU أكبر
حجم expert cache كيتحدّد حسب VRAM المتاحة من بعد تحميل الموديل والاحتياط المضبوط. بالتالي، كارت 32 GB ولا 48 GB كتاخذ expert slots أكثر، وهاد الشي خاصو يرفع hit rate ويحسّن أداء decode. نتائج الكروت الكبيرة ما مذكوراش فالـREADME.
RTX 4090 يقدر يشغّل build ديال sm_86 المرفق، مع أنه ما تقاسش. Blackwell كيحتاج rebuild بهاد الإعداد:
TORCH_CUDA_ARCH_LIST="8.6;12.0"يقدر حتى يكون ضروري pin جديد ديال Triton فمعمارية أخرى. إلا درتي واحد، تأكّد باللي reference panel باقي فـtop-1 1.0000 وKL 0.
حافظ على اختيارات Triton الدقيقة
الـimage كيثبّت اختيارات KDA linear-attention prefill kernel عبر data/triton_pin_exact.json. إلى خليتي Triton يختار إعدادات مختلفة، يقدر يتبدّل التقريب بالفاصلة العائمة. خلّي GLM53_TRITON_PIN بالقيمة الافتراضية ملي كتكون مطابقة سلوك prefill المرجعي مهمّة.
كيفاش كيخدم مسار offloading
- حمّل الـexperts الموجّهين فذاكرة المضيف المثبّتة. كل layer كيتعطى ليه pinned arena بالحجم الدقيق، ومؤشرات experts ديال exllamav3 كتشير لـCUDA UVA aliases.
- عمّر CLOCK cache مرن فـVRAM. اختيارات router كتتحيّد منها التكرارات، cache hits كيتعلّمو، وvictims كيتختارو للـmisses المقبولة.
- قرا الـexperts اللي ما كايناش فالكاش عبر PCIe. kernels ديال exllamav3 يقدرو يوصلو للتمثيل المثبّت فالمضيف بلا copy متزامن من جهة المضيف.
- دير staging للـprefills الطويلة. ملي كيكون عدد الاختيارات لكل layer كبير بما يكفي، الـexperts الناقصين كيتنسخو لـstaging buffer قبل بطبقة وحدة، فحين كتتحسب الطبقة اللي قبل منها.
- قسّم decode misses المختارة فالوضع السريع. نموذج الكلفة كيدوز الـmisses اللي سخونين عبر تنفيذ GPU بلا نسخ، والـmisses الباردين المختارين لطبقة CPU.
- جمع نتائج CPU وGPU. CPU كينشر الخدمة ديالو عبر pinned mapped memory، وGPU كيزيد partial الناتج بصيغة FP32 من بعد ما كيتسنى flag من جهة الجهاز، بلا synchronization مع المضيف.
تنبيهات تشغيلية
- استعمل
GLM53_MODE=exactملي خاص مخرجات decode تطابق exllamav3 الأصلي. - تجنّب الـimage القديم
sha256:1159044a...إلا كانت latency ديال streaming مهمّة. استعمل digest الموثّقsha256:bb633b0b.... - الوضع السريع كيبقي حالياً جوج نسخ من experts فـhost RAM. تأكّد من توفر الذاكرة الكافية قبل ما تبدا الـcontainer.
- ما تفترضش أن throughput المقاس على RTX 3090 غيبقى هو نفسه فـPCIe أبطأ. سرعة decode حساسة لحركة cache-miss.
- راقب
/stats، وذاكرة النظام، وذاكرة GPU ملي كتبدّل حجم السياق، وcache reserve، والتوازي، ولا إعدادات staging. - السيرفر كيتعامل غير مع النص؛ إدخال الصور ما مدعومش فهاد النشر.
الخلاصة
glm53-flash-offload كيخلّي checkpoint كبير بشكل غير معتاد من نوع mixture-of-experts عملي على GPU واحد بسعة 24 GB، باستعمال تخزين المضيف المثبّت، وقراءة PCIe بلا نسخ، وVRAM cache مرن، ونقلات prefill على مراحل، وطبقة CPU اختيارية مبنية على AVX2. بدا بالـDocker image المثبّت، واختار exact للحفاظ على مطابقة المخرجات ولا fast باش تحصل على throughput أعلى، ومن بعد تحقّق من التثبيت باختبارات الجودة والسرعة وstreaming المرفقة قبل ما تضبط إعدادات الكاش ولا CPU.