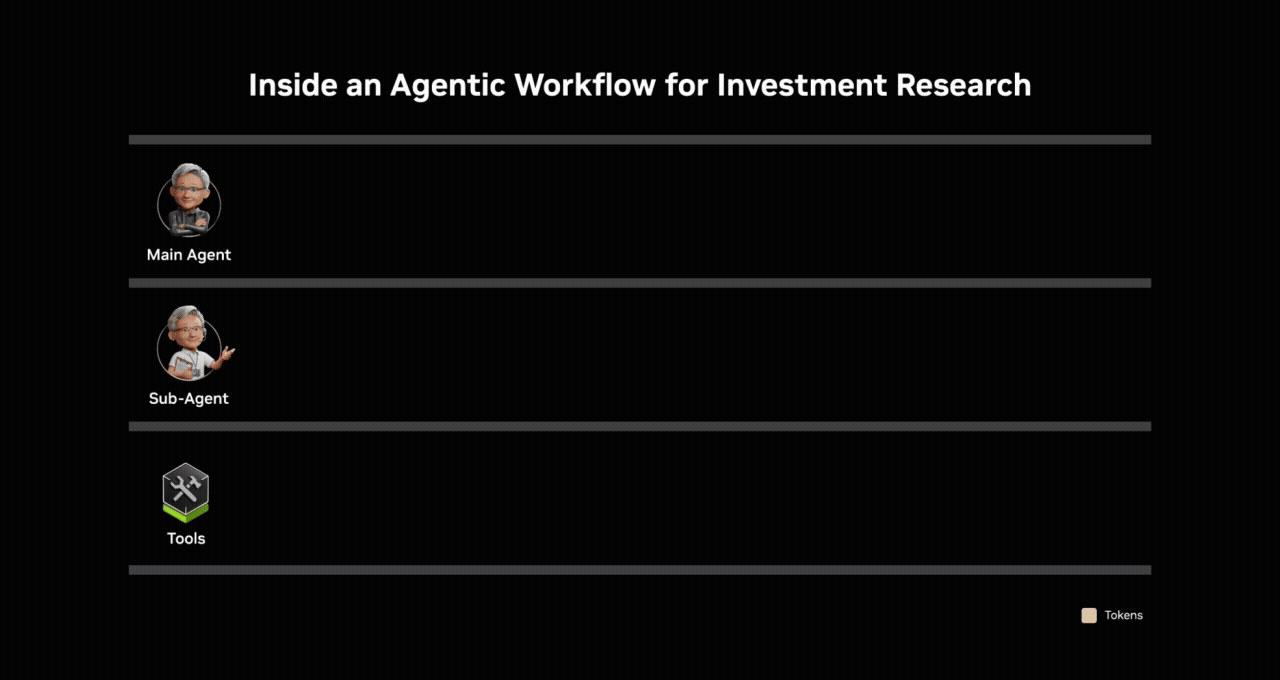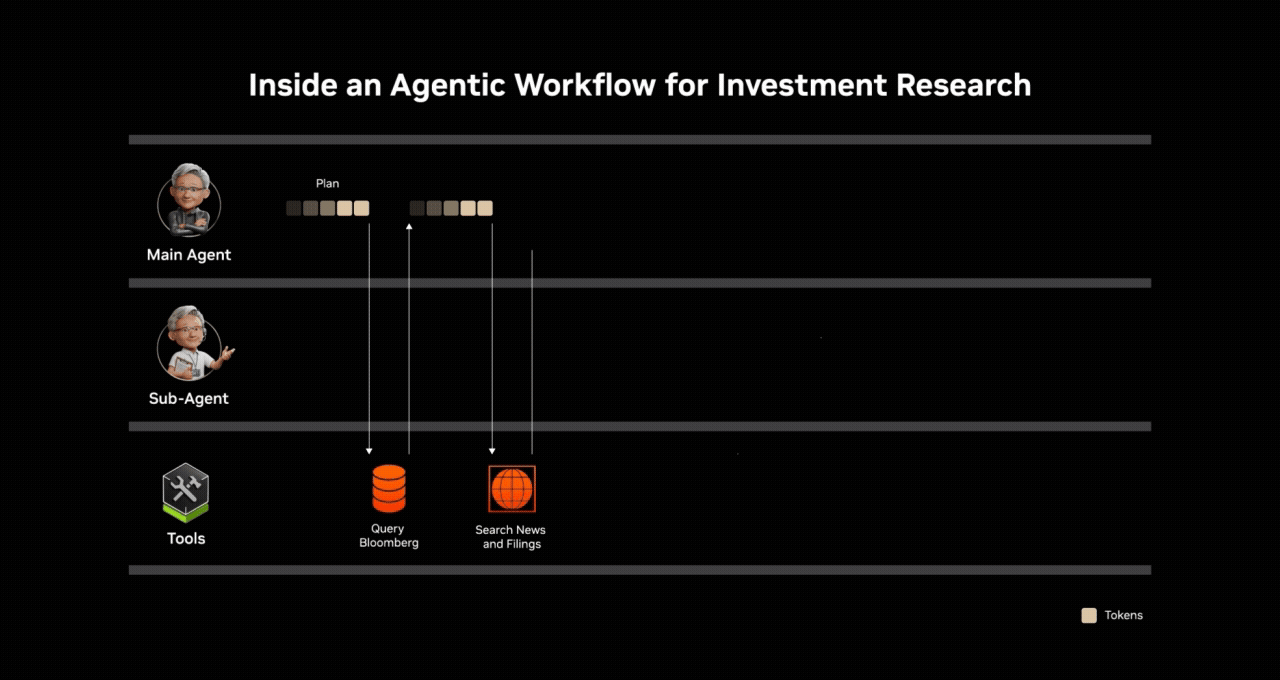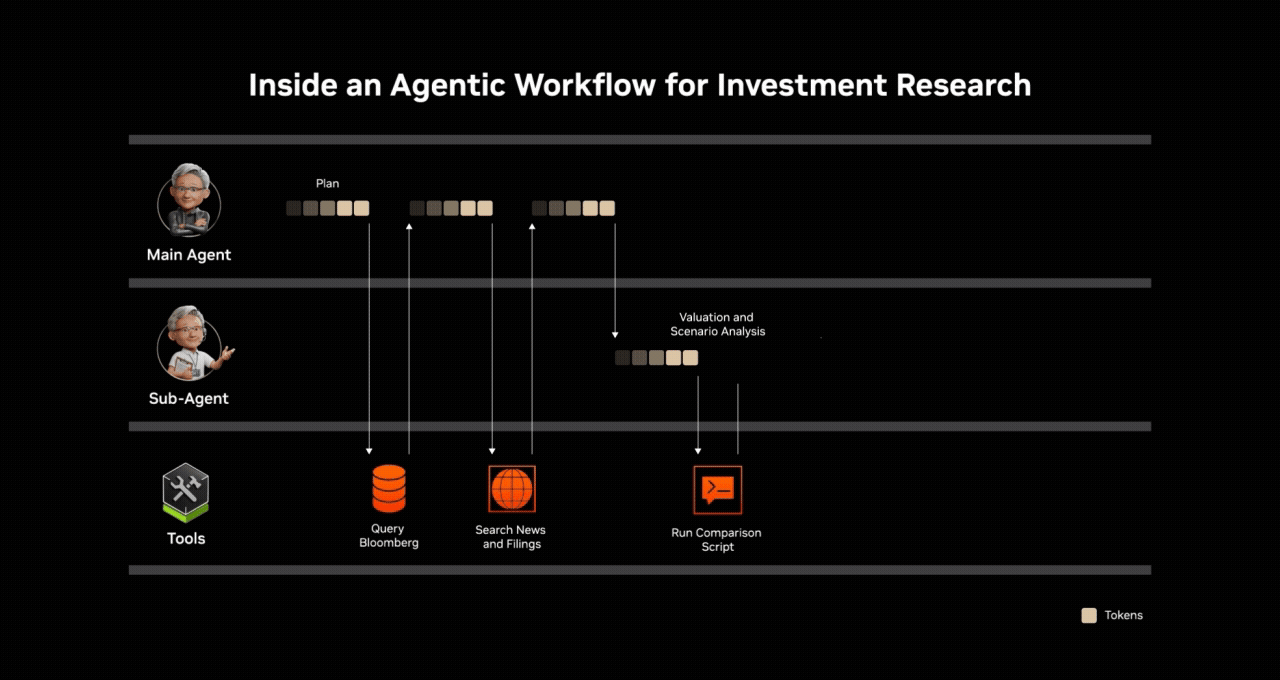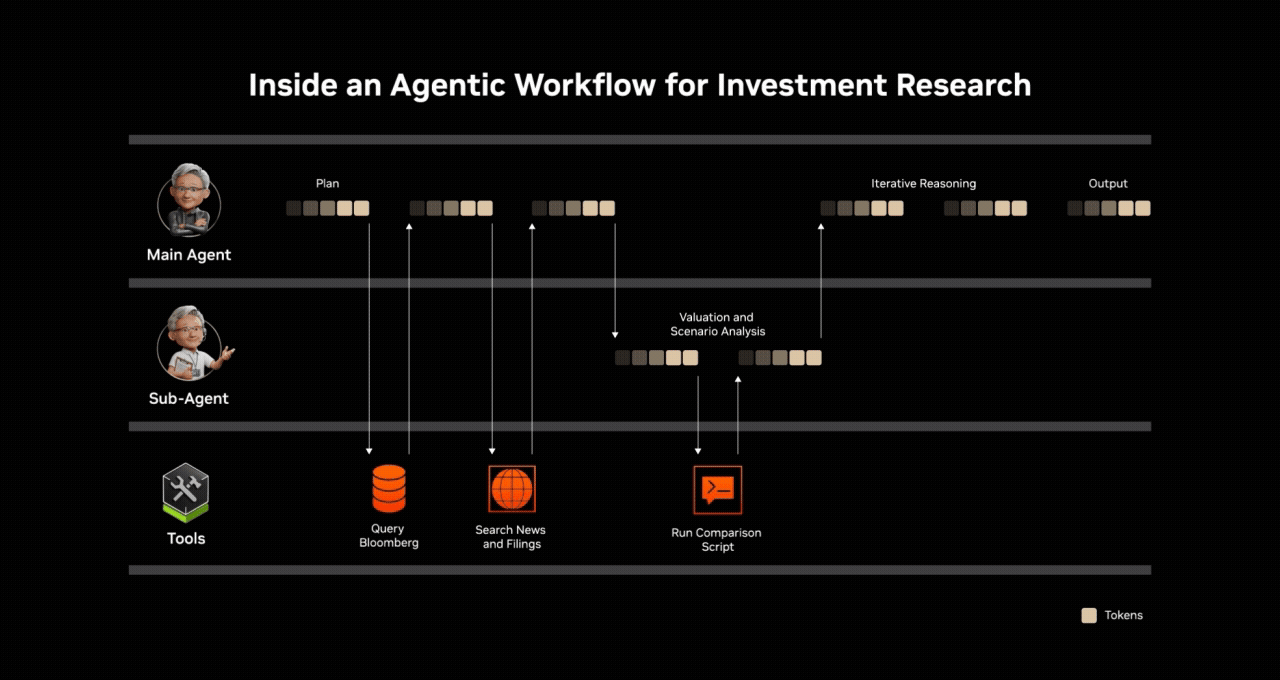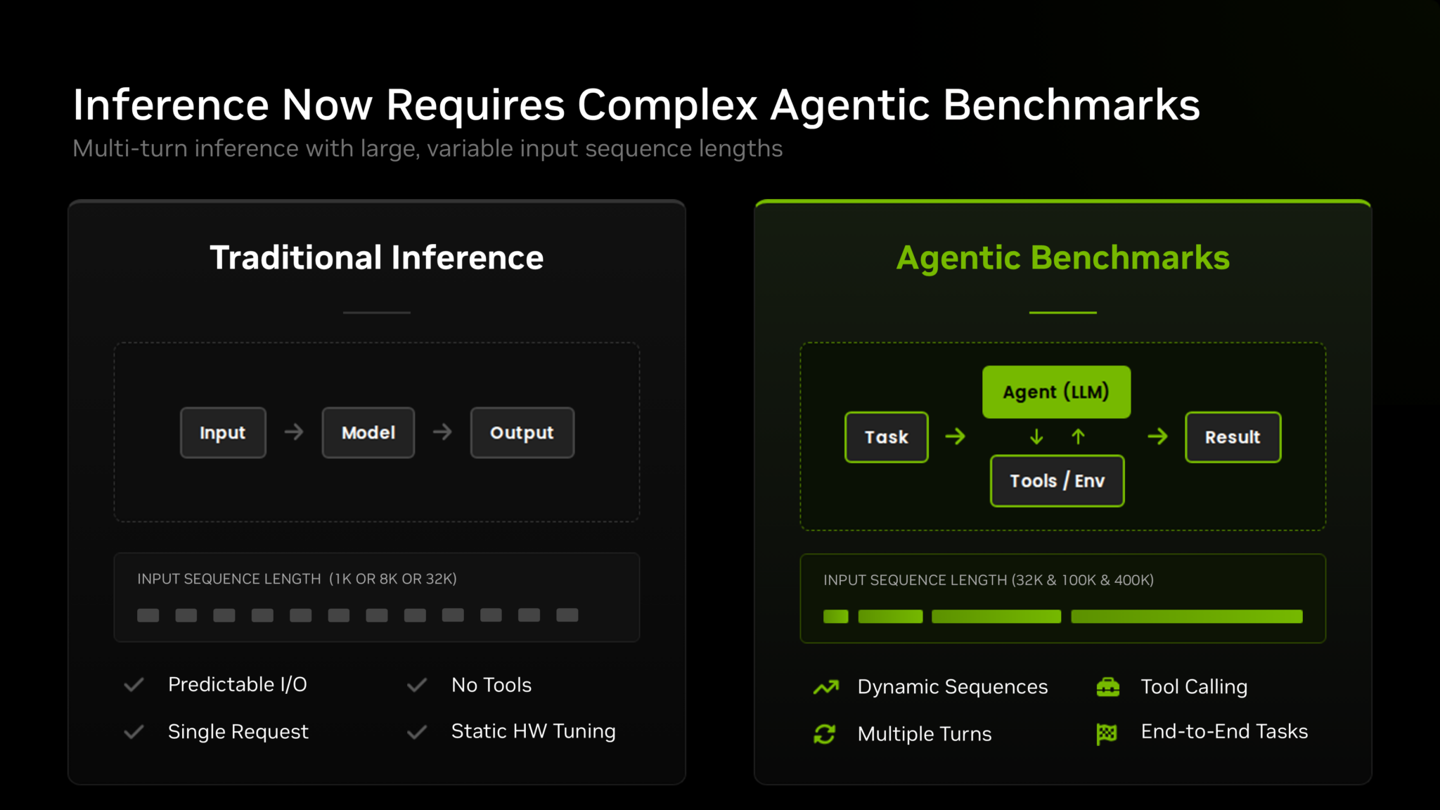
NVIDIA গতকাল SemiAnalysis AgentX ওয়ার্কলোড ব্যবহার করে DeepSeek-v4-PRO 1.6T মডেলের মূল্যায়ন পরীক্ষা চালায়। এতে দেখা যায়, Vera Rubin-এর প্রতি মেগাওয়াট থ্রুপুট Blackwell-এর ৩০ গুণ।
প্রতি মেগাওয়াট থ্রুপুট (Tokens per Megawatt, সংক্ষেপে tokens / MW) হলো নির্দিষ্ট বিদ্যুৎ বরাদ্দে একটি AI ডেটা সেন্টার কত AI টোকেন উৎপাদন করতে পারে, তা পরিমাপের গুরুত্বপূর্ণ শক্তি-দক্ষতা সূচক।
IT之家 একটি ব্লগ পোস্টের বরাত দিয়ে জানায়, SemiAnalysis AgentX চারটি সূচকের মাধ্যমে এজেন্টিক প্রোগ্রামিং ও রিজনিং ওয়ার্কলোড মূল্যায়নে重点 দেয়:
এন্ড-টু-এন্ড স্বাভাবিকীকৃত ইন্টারঅ্যাক্টিভিটি অনুরোধ জমা দেওয়া থেকে চূড়ান্ত টোকেন পৌঁছানো পর্যন্ত সম্পূর্ণ সময়ের ভিত্তিতে গণনা করা হয়। এতে প্রথম টোকেনের অপেক্ষার সময়সহ ব্যবহারকারীর দৃশ্যমান আউটপুট দক্ষতা প্রতিফলিত হয়;
স্ট্যান্ডার্ড ইন্টারঅ্যাক্টিভিটি শুধু প্রথম টোকেন থেকে শেষ টোকেনের মধ্যবর্তী উৎপাদন পর্যায় গণনা করে।
এন্ড-টু-এন্ড লেটেন্সি একটি অনুরোধ জমা দেওয়া থেকে চূড়ান্ত আউটপুট টোকেন পৌঁছানো পর্যন্ত মোট সময় পরিমাপ করে।
প্রথম টোকেন লেটেন্সি (TTFT) অনুরোধ জমা দেওয়া থেকে প্রথম আউটপুট টোকেন পৌঁছানো পর্যন্ত সময় পরিমাপ করে।
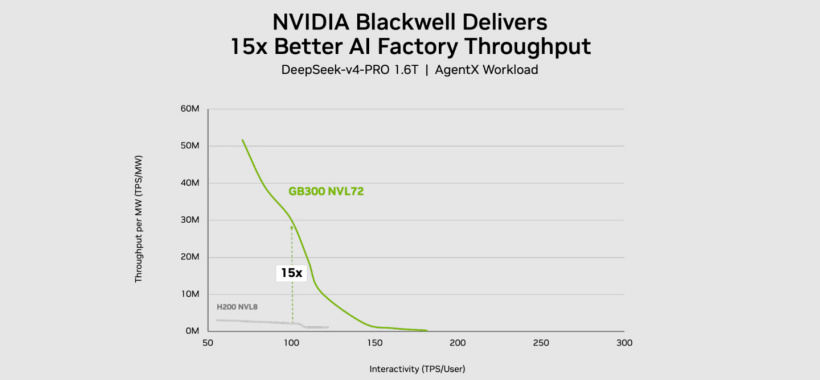
DeepSeek-v4-PRO 1.6T ওয়ার্কলোডে GB300 NVL72-ভিত্তিক Grace Blackwell সার্ভারের প্রতি মেগাওয়াট থ্রুপুট H200 NVL8 Hopper সমাধানের ১৫ গুণ।
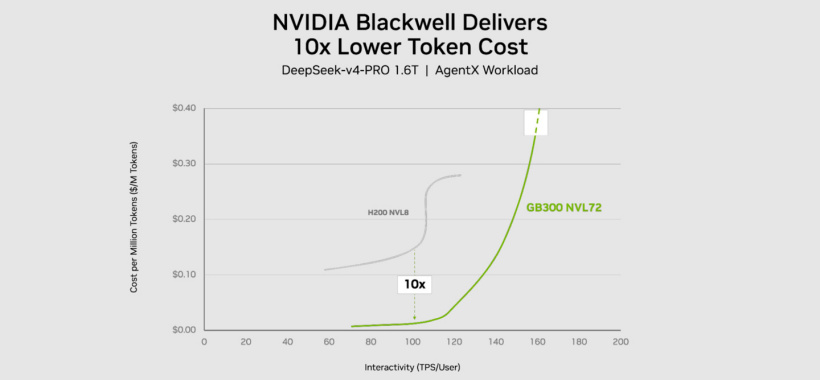
Blackwell-এ প্রতি ১০ লাখ টোকেনের খরচ আগের প্রজন্মের প্রায় ১/১০। ফলে একই বিদ্যুৎ ও অবকাঠামো বাজেটে অপারেটররা আরও বেশি এজেন্ট সমর্থন করতে পারেন, অথবা কম পরিচালন ব্যয়ে একই সংখ্যক এজেন্টের সক্ষমতা বজায় রাখতে পারেন।
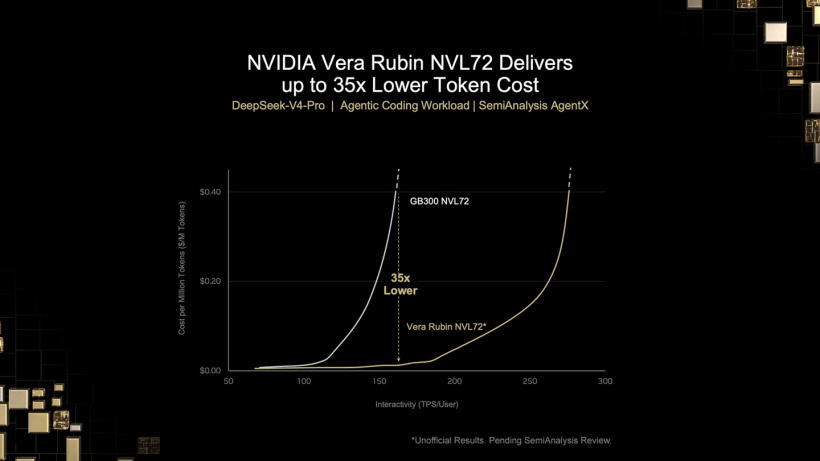
Vera Rubin এই সুবিধা আরও বাড়িয়েছে। DeepSeek V4 Pro মডেলে Vera Rubin NVL72-এর প্রতি মেগাওয়াট থ্রুপুট GB300 NVL72-এর প্রায় ৩০ গুণ।
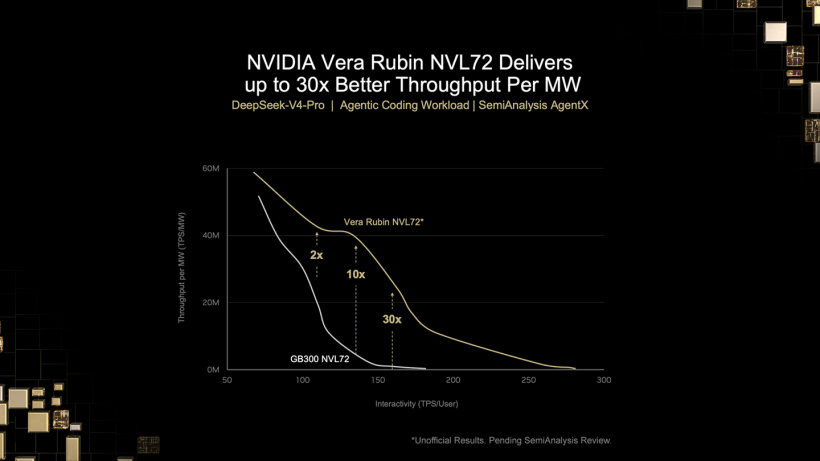
Vera Rubin NVL72-এ প্রতি ১০ লাখ টোকেনের খরচ GB300 NVL72-এর ১/৩৫। এর মাধ্যমে গ্রাহকদের বিভিন্ন ওয়ার্কলোডের চাহিদা পূরণে ধারাবাহিকভাবে বৃহৎ পরিসরে এজেন্ট চালানো সম্ভব।