

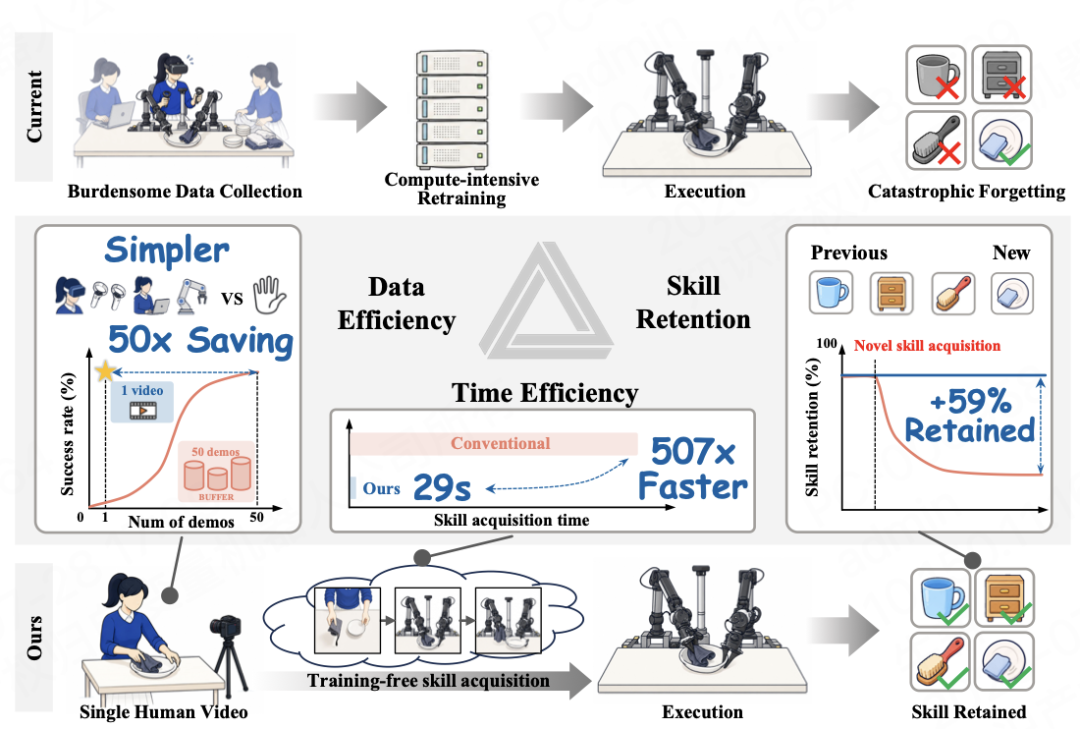
自变量 রোবট আজ HOST ফ্রেমওয়ার্ক (Human-to-robot One-Shot Skill AcquisiTion, মানুষ থেকে রোবটে এক-নমুনা দক্ষতা অর্জন) প্রকাশ ও ওপেন সোর্স করেছে। প্রতিষ্ঠানটির দাবি, এটি রোবটকে কয়েক দশ সেকেন্ডের একটি মানব ভিডিও পর্যবেক্ষণ করেই নতুন দক্ষতা শিখতে এবং ইতিমধ্যে আয়ত্ত করা দক্ষতা ধরে রাখতে সক্ষম করে।
HOST একটি উদ্ভাবনী পদ্ধতি ব্যবহার করে: মানুষের কর্মকাণ্ডকে রোবটের কর্মকাণ্ডে অনুবাদ করে অনুকরণ করানোর পরিবর্তে, রোবট প্রথমে কর্মকাণ্ড সম্পন্ন করার পরের ফলাফল কল্পনা করে, তারপর সেই ফলাফল থেকে সম্পাদনীয় কর্মকাণ্ড নির্ধারণ করে। এই নতুন পদ্ধতির ফল আশাব্যঞ্জক: 29 সেকেন্ডের একটি মানব ভিডিও থেকে দক্ষতা শেখার ক্ষেত্রে রোবটের সাফল্যের হার 62% পর্যন্ত, যা শূন্য-নমুনা বেসলাইনের 45% সাফল্যকে ছাড়িয়ে যায়। Pi-0.5 + ফাইন-টিউনিং পদ্ধতির তুলনায় HOST-এর প্রয়োজনীয় ডেটা 50 গুণ কম এবং দক্ষতা শেখার গতি 500 গুণ বেশি।
HOST-এর ধারণা জ্ঞানবিজ্ঞানের “পর্যবেক্ষণমূলক শিক্ষা” তত্ত্ব থেকে এসেছে: মানুষ অপরিচিত কোনো কাজের মুখোমুখি হলে দীর্ঘ সময় অনুশীলন বা সম্ভাব্য সব পরিস্থিতি পরীক্ষা করে শেখার প্রয়োজন হয় না। বরং পূর্বজ্ঞান ও সক্ষমতার ভিত্তিতে মস্তিষ্কে কাজটির প্রত্যাশিত ফলাফল অনুকরণ করে, তারপর সংশ্লিষ্ট কর্মকাণ্ড সম্পাদন করে। এ থেকেই অনুপ্রাণিত হয়ে 自变量-এর গবেষকেরা HOST-এর শেখার পদ্ধতিকে “প্রশিক্ষণের সময় ফাইন-টিউনিং চক্র” থেকে “অনুমানের সময় দক্ষতা অর্জন”-এ রূপান্তর করেছেন, যাতে রোবট মানুষকে কাজ সম্পাদন করতে দেখে নতুন দক্ষতা শিখতে পারে।
রোবটকে প্রথমে যে সমস্যাটি সমাধান করতে হয় তা হলো: নিজের কাজের অগ্রগতি এবং ভিডিওতে দেখানো কাজের অগ্রগতির মধ্যে কীভাবে সমন্বয় করা যায়?
উদাহরণস্বরূপ, একই 10 সেকেন্ড কাজ করার পর ভিডিওর মানুষটি হয়তো সবজি কেটে ভাজা শুরু করেছে, কিন্তু রোবট তখনও সবজি কাটছে। শুধু সময়ের ভিত্তিতে সমন্বয় করা হলে রোবট কাজের অগ্রগতি হারিয়ে ফেলবে।
এ সমস্যায় HOST “কাজের অগ্রগতি অনুযায়ী সমন্বয়” পদ্ধতি ব্যবহার করে। HOST ভিডিওর প্রতিটি ফ্রেম এবং রোবটের প্রতিটি অপারেশনকে একই ভেক্টর স্পেসের ভেক্টরে রূপান্তর করে। এরপর “ডায়নামিক টাইম ওয়ারপিং” অ্যালগরিদম ব্যবহার করে স্বয়ংক্রিয়ভাবে “মানব ভিডিওর X নম্বর ফ্রেম” এবং “রোবটের Y নম্বর অপারেশন”-এর মধ্যে সমন্বয় করে। ফলে রোবট প্রতিটি ধাপ সম্পাদনের সময় কাজের অগ্রগতির সঙ্গে সামঞ্জস্যপূর্ণ ফ্রেমই দেখতে পায়।
এই পদ্ধতির সাহায্যে HOST কাজের অগ্রগতি সমন্বয়ের সময়গত ত্রুটি এক মাত্রা কমিয়েছে এবং রোবটের সম্পাদনাকে ভিডিও প্রদর্শনের সঙ্গে নির্ভুলভাবে সমন্বয় করতে সক্ষম হয়েছে।
HOST-এর মূল অংশ হলো একটি ভিজ্যুয়াল পূর্বাভাস সুবিধাসম্পন্ন ক্যাসকেড নীতি মডেল। এতে দ্বৈত- বিশেষজ্ঞ MoT আর্কিটেকচার ব্যবহার করা হয়েছে, যা স্পষ্টভাবে বিভক্ত দায়িত্বসম্পন্ন দুটি মস্তিষ্কের মতো: “ভিজ্যুয়াল মস্তিষ্ক” (ভিডিও বিশেষজ্ঞ) ভিডিও দৃশ্য প্রক্রিয়াকরণ, কাজের অগ্রগতি শনাক্তকরণ এবং ভবিষ্যৎ দৃশ্যের পূর্বাভাসে বিশেষায়িত; “অ্যাকশন মস্তিষ্ক” (অ্যাকশন বিশেষজ্ঞ) পূর্বাভাসিত দৃশ্যকে সম্পাদনীয় কর্মকাণ্ডে রূপান্তর করে এবং সেগুলোর বাস্তবায়ন নিয়ন্ত্রণ করে।
মডেল প্রশিক্ষণের সময় 自变量 দলটি প্রশিক্ষণ প্রক্রিয়াকে “একই সত্তার প্রি-ট্রেনিং” এবং “মানব-রোবট ভিডিও প্রশিক্ষণ” নামে দুটি ধাপে ভাগ করেছে। একই সত্তার প্রি-ট্রেনিং ধাপে রোবট নিজের কাজ সম্পাদনের ভিডিও দেখে কাজ সম্পন্ন হওয়ার পরের অবস্থা পূর্বাভাস দিতে এবং সংশ্লিষ্ট কর্মকাণ্ড তৈরি করতে শেখে। মানব-রোবট ভিডিও প্রশিক্ষণ ধাপে রোবট মানবের প্রদর্শনমূলক ভিডিও থেকে আরও শেখে। মানুষের কাজ সম্পাদনের প্রক্রিয়াকে রোবটের দৃষ্টিকোণ থেকে কাজের ফলাফলে রূপান্তর করে, তারপর লক্ষ্য ফলাফলের ভিত্তিতে কাজটি সম্পন্ন করতে প্রয়োজনীয় কর্মকাণ্ড অনুমান করে। এভাবেই মানব প্রদর্শন থেকে রোবট দক্ষতায় স্থানান্তর সম্ভব হয়।
বর্তমানে HOST-এর গবেষণাপত্র ও কোড সম্পূর্ণভাবে ওপেন সোর্স করা হয়েছে। ভবিষ্যতে গৃহস্থালির কাজ করার সময় রোবট পেশাদার ডেটা সংগ্রহ ও প্রশিক্ষণ প্রক্রিয়া থেকে মুক্ত হয়ে মানুষের সরাসরি প্রদর্শন দেখে নতুন দক্ষতা শিখতে পারবে বলে আশা করা হচ্ছে।
তথ্যসূত্র
প্রকল্পের হোমপেজ
গবেষণাপত্রের লিংক
Github লিংক
Huggingface লিংক