

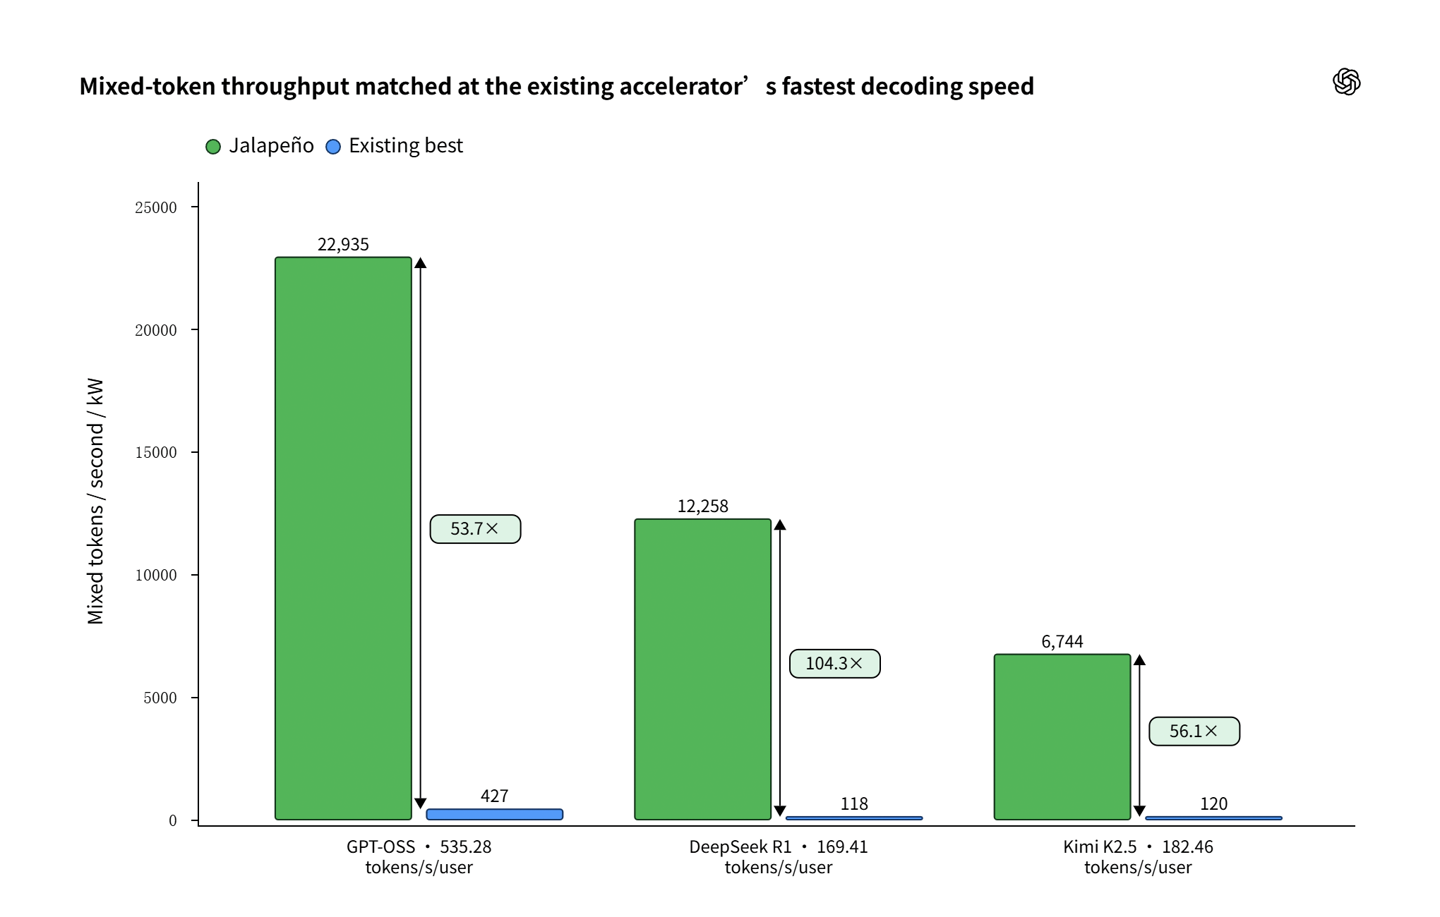
OpenAI গতকাল (২৫ আগস্ট) একটি ব্লগ পোস্ট প্রকাশ করে তাদের প্রথম নিজস্বভাবে তৈরি Jalapeño চিপ প্রদর্শন করেছে এবং জানিয়েছে, একক ব্যবহারকারীর টোকেন প্রক্রিয়াকরণ ক্ষমতা হোক বা প্রতি কিলোওয়াটে থ্রুপুট, উভয় ক্ষেত্রেই এটি বর্তমানে বাজারের শীর্ষস্থানীয় ইনফারেন্স প্রসেসরের চেয়ে এগিয়ে।
অফিশিয়াল ব্লগ পোস্টে OpenAI সেমিকন্ডাক্টর গবেষণা প্রতিষ্ঠান SemiAnalysis-এর তৈরি পাবলিক বেঞ্চমার্ক টুল InferenceX ব্যবহার করে GPT-OSS 120B, DeepSeek R1 670B এবং Kimi K2.5 1T—এই তিনটি মডেল পরীক্ষা করেছে।
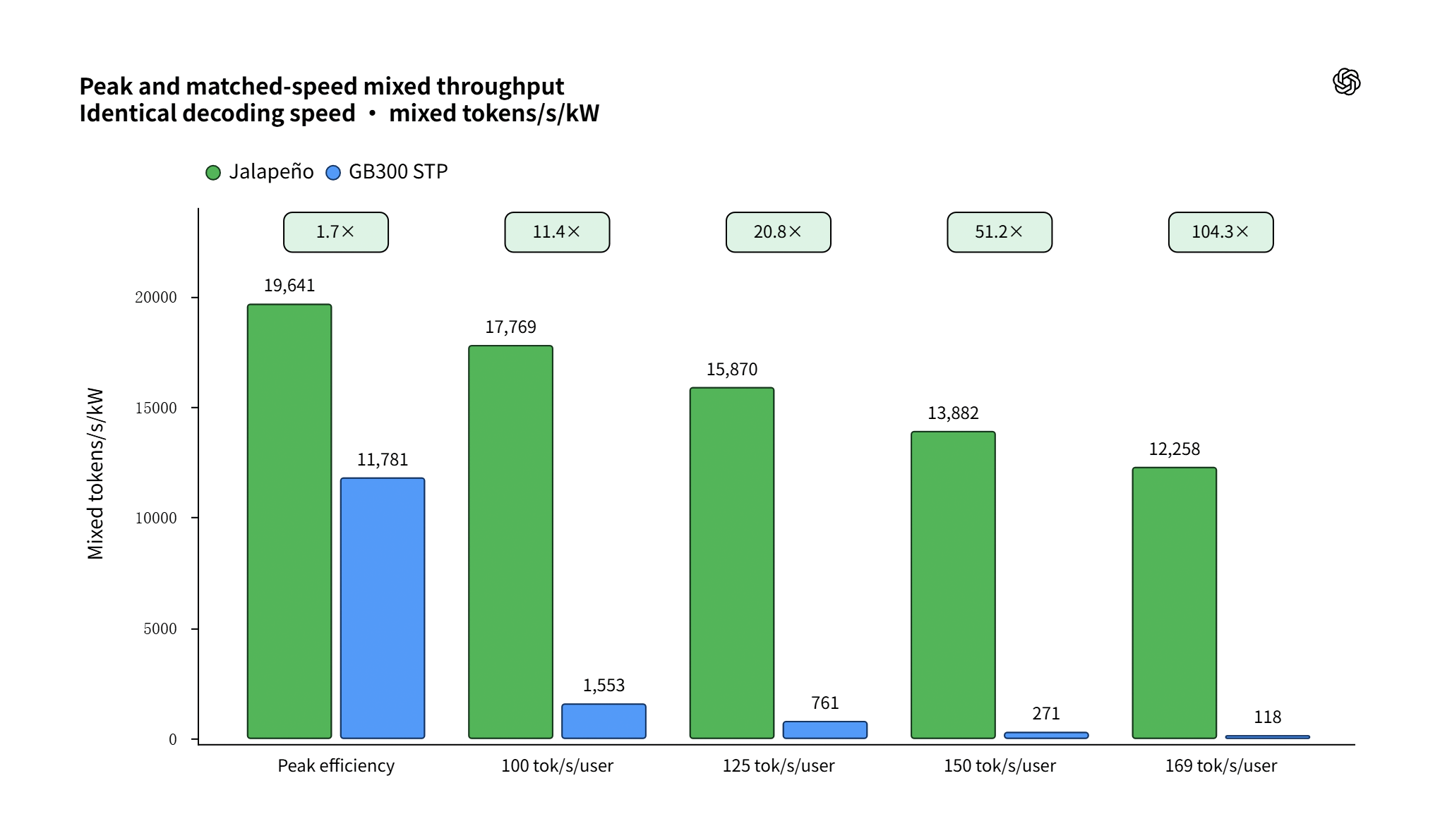
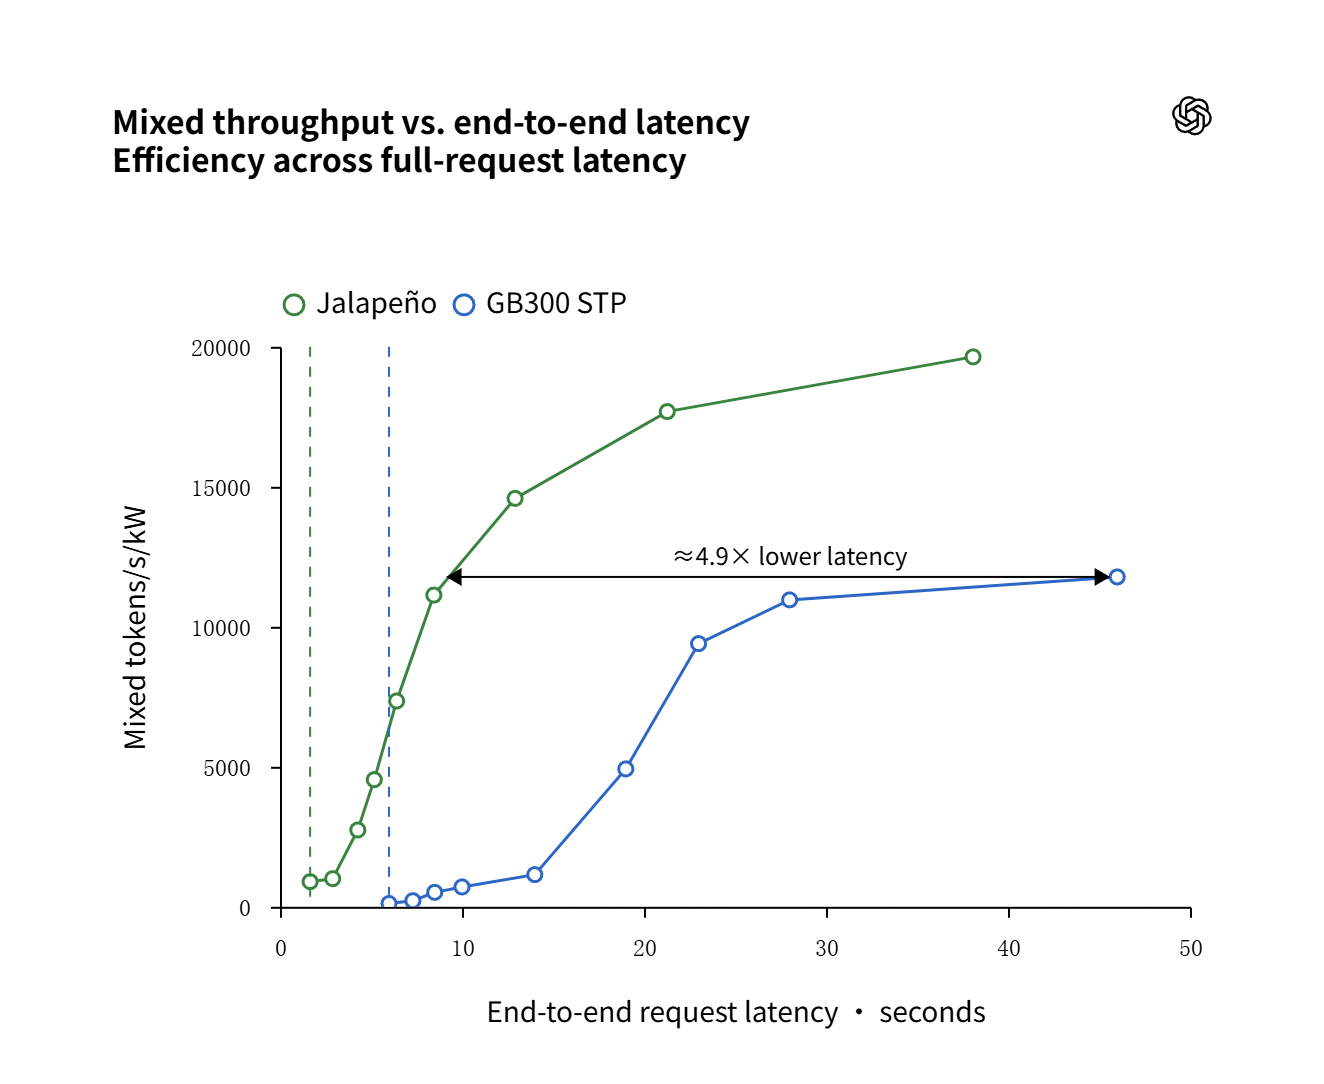
পরীক্ষায় বাজারের শীর্ষস্থানীয় AI সিস্টেম (GB200 এবং GB300)-এর সঙ্গে তুলনা করে দেখা গেছে, প্রতি ওয়াটে সম্পন্ন করা AI থ্রুপুট তুলনামূলক সিস্টেমগুলোর ১.৫ থেকে ১.৯ গুণ, আর এন্ড-টু-এন্ড লেটেন্সি তুলনামূলক সিস্টেমগুলোর প্রায় ২৮% থেকে ৫৯%।
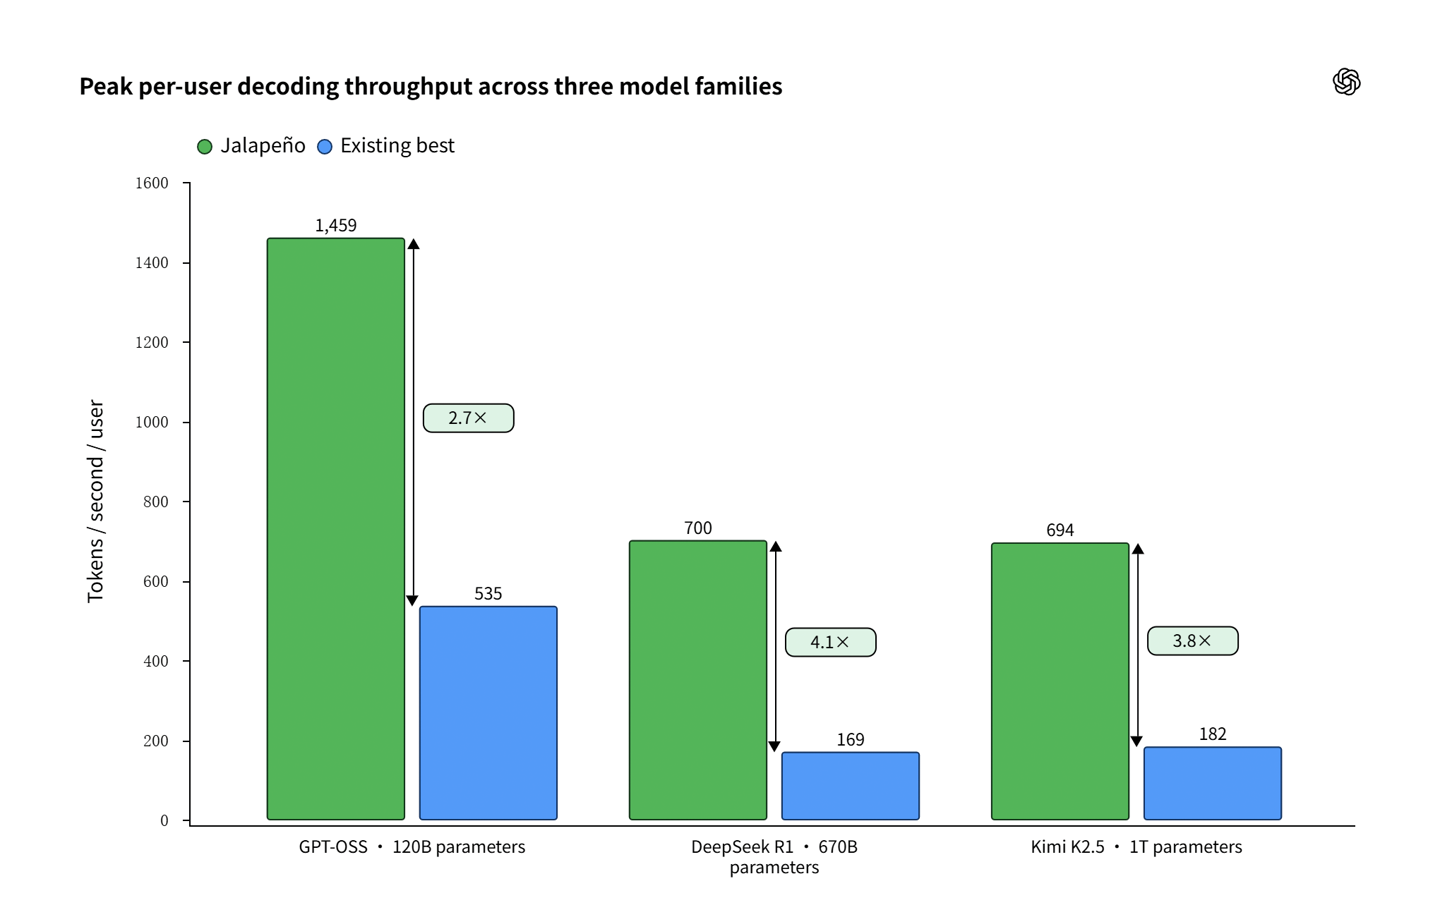
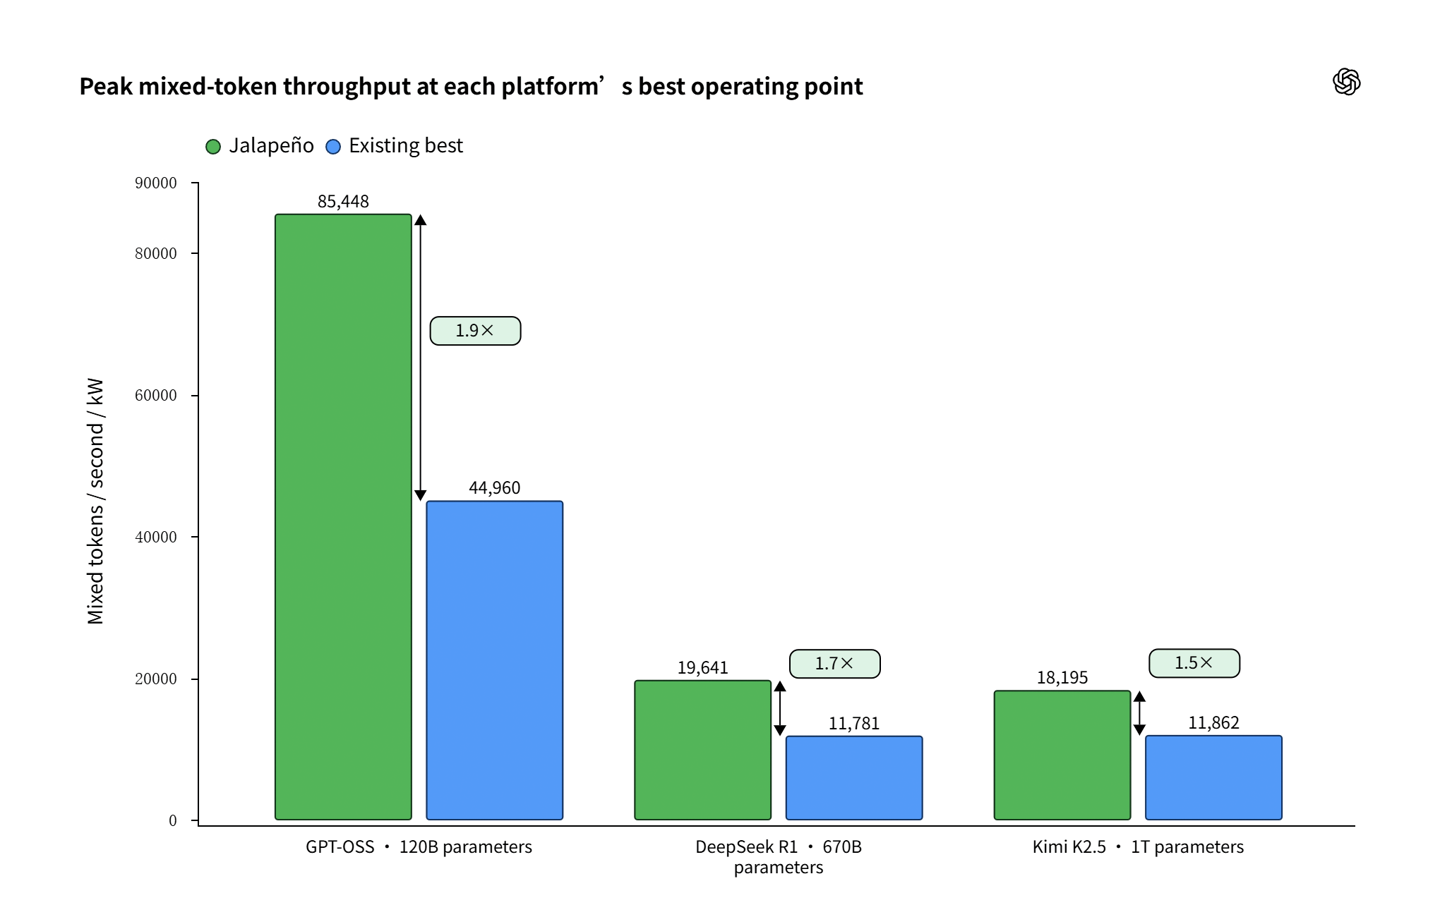
OpenAI জানিয়েছে, GPT-OSS 120B চালানোর সময় Jalapeño-এর প্রতি কিলোওয়াটে সর্বোচ্চ থ্রুপুট GB200 সিস্টেমের চেয়ে প্রায় ১.৯ গুণ বেশি।
DeepSeek R1-এর ক্ষেত্রে এর প্রতি ওয়াট পারফরম্যান্স GB300-এর চেয়ে প্রায় ১.৭ গুণ বেশি; Kimi K2.5-এর ক্ষেত্রে প্রতি ওয়াট পারফরম্যান্স GB300-এর চেয়ে প্রায় ১.৫ গুণ বেশি। Jalapeño-এর নির্ধারিত বিদ্যুৎ ক্ষমতা ৭০০ ওয়াট, তবে পরীক্ষার কাজের চাপ চলাকালে এর ধারাবাহিক বিদ্যুৎ খরচ ৫৫০ ওয়াট বা তার কম ছিল। ওপরের সংশ্লিষ্ট ছবিগুলো নিচে দেওয়া হলো:
Jalapeño হলো OpenAI-এর প্রথম নিজস্বভাবে তৈরি AI ইনফারেন্স চিপ। এটি OpenAI ও Broadcom-এর যৌথভাবে তৈরি, TSMC-এর 3nm প্রক্রিয়ায় চুক্তিভিত্তিক উৎপাদন করা হয়েছে এবং ২০২৬ সালের ২৪ জুন প্রথমবার জনসমক্ষে প্রদর্শিত হয়। চিপটি একটি ASIC (অ্যাপ্লিকেশন-নির্দিষ্ট ইন্টিগ্রেটেড সার্কিট), যাতে systolic array (সিস্টোলিক অ্যারে) আর্কিটেকচার এবং HBM উচ্চ-ব্যান্ডউইথ মেমরি রয়েছে। এটি বড় ভাষা মডেলের ইনফারেন্স ব্যবহারের জন্য বিশেষভাবে তৈরি, মডেল প্রশিক্ষণের জন্য নয়। চিপ ও এর সহায়ক সার্ভার সিস্টেম কোনোটিই বাইরে বিক্রি করা হবে না; এগুলো কেবল OpenAI-এর অভ্যন্তরীণ ব্যবহারের জন্য, যার লক্ষ্য নিজেদের GPU ক্রয় ও কম্পিউটিং পরিচালনা ব্যয় কমানো। OpenAI-এর হার্ডওয়্যার বিভাগের প্রধান Richard Ho এই চিপের গবেষণা ও উন্নয়ন পরিচালনা করেছেন। তিনি এর আগে Google-এ প্রায় নয় বছর কাজ করেছেন এবং Cloud TPU প্রকল্পের মূল প্রকৌশলীদের একজন ছিলেন। Jalapeño-এর আর্কিটেকচার নকশা থেকে ওয়েফার-উৎপাদন সম্পন্ন হওয়া পর্যন্ত সময় লেগেছে মাত্র প্রায় ৯ মাস। OpenAI-এর দাবি, উচ্চক্ষমতাসম্পন্ন উন্নত সেমিকন্ডাক্টর ক্ষেত্রে এটি ইতিহাসের অন্যতম দ্রুত ASIC উন্নয়ন চক্র। OpenAI-এর নিজস্ব AI মডেলও চিপ নকশা প্রক্রিয়ায় গভীরভাবে অংশ নিয়েছে এবং নকশা অপ্টিমাইজেশন ত্বরান্বিত করতে সহায়তা করেছে। বর্তমানে দ্বিতীয় প্রজন্মের Jalapeño চিপ উন্নয়নের শেষ পর্যায়ে রয়েছে এবং আগামী কয়েক মাসের মধ্যে ওয়েফার-উৎপাদন সম্পন্ন হবে বলে আশা করা হচ্ছে; তৃতীয় প্রজন্মের চিপের ধারণাগত নকশাও শুরু হয়েছে। OpenAI ২০২৬ সালের শেষ নাগাদ সীমিত পরিসরে Jalapeño স্থাপন এবং ২০২৭ সালে ধীরে ধীরে স্থাপনার পরিসর বাড়ানোর পরিকল্পনা করছে। মনে রাখা দরকার, Jalapeño-এর এই পরীক্ষায় তুলনা করা হয়েছে NVIDIA-এর GB200 ও GB300 সিস্টেমের সঙ্গে; NVIDIA-এর সর্বশেষ প্রজন্মের Vera Rubin চিপের সঙ্গে এখনও তুলনামূলক পরীক্ষা করা হয়নি। OpenAI জানিয়েছে, NVIDIA এখনও তাদের গুরুত্বপূর্ণ অংশীদার এবং বিপুল কম্পিউটিং চাহিদা পূরণে ভবিষ্যতেও একাধিক সরবরাহকারীর কৌশল অব্যাহত রাখবে।