

আলি টংই Qwen দলের পক্ষ থেকে আজ রাতে আনুষ্ঠানিকভাবে Qwen3.8-Flash প্রকাশ করা হয়েছে। টংই দল একই সঙ্গে Qwen3.8-Flash-Next-এর ওপেন সোর্স ওজনও প্রকাশ করেছে। Next-এর নতুন আর্কিটেকচারটি সম্পূর্ণ নতুন প্রজন্মের Qwen4 সিরিজের মডেলের ভিত্তি হবে।
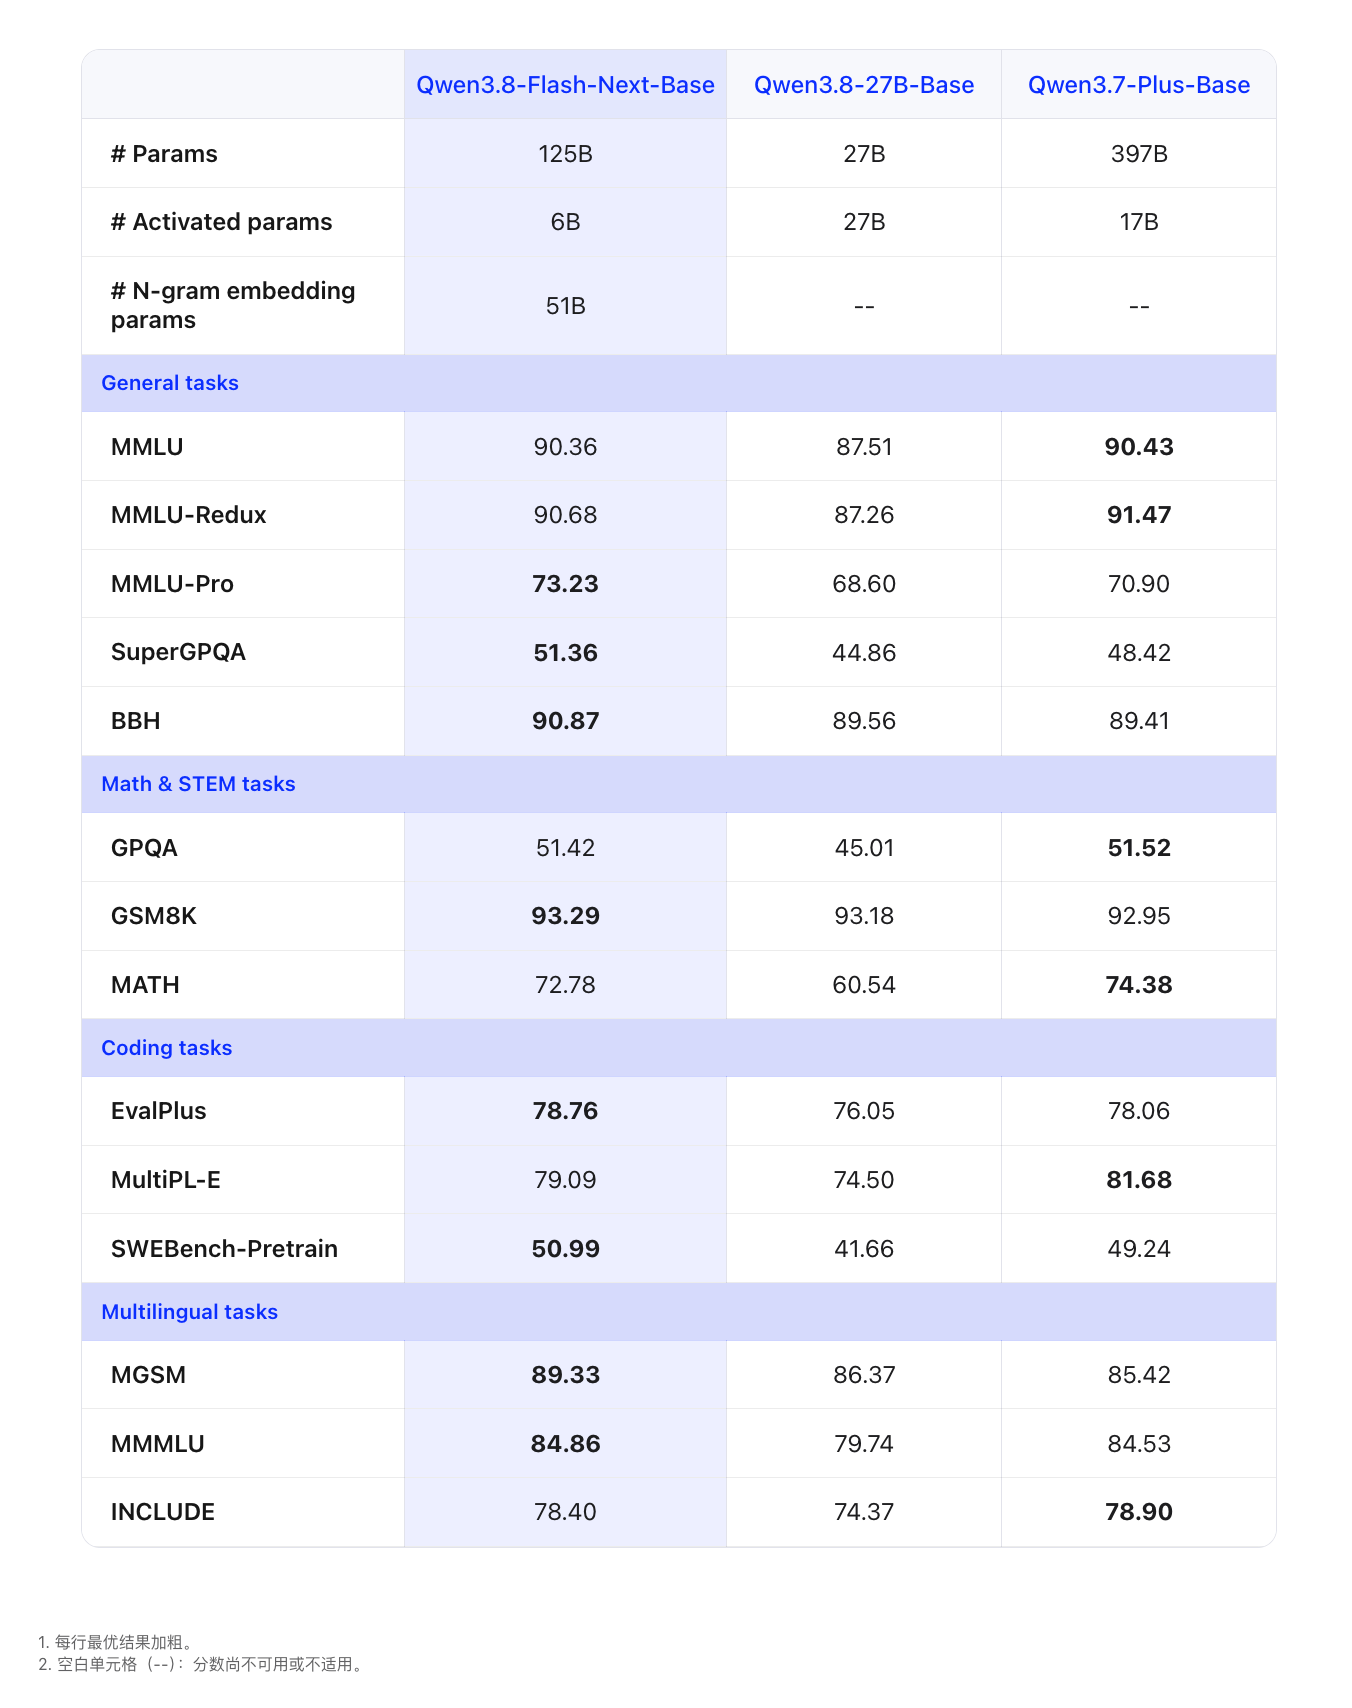
এটি একটি মাল্টিমোডাল MoE মডেল। মূল মডেলে 125B প্যারামিটার রয়েছে এবং অতিরিক্তভাবে 51B-এর N-gram Embedding যুক্ত করা হয়েছে; প্রতি token-এ 6B প্যারামিটার সক্রিয় হয়। এটি নেটিভভাবে 262,144 tokens কনটেক্সট সমর্থন করে এবং YaRN-এর মাধ্যমে 1M tokens পর্যন্ত সম্প্রসারণ করা যায়।
পরিচিতি অনুযায়ী, Qwen3.8-Flash চারটি দিক ঘিরে পদ্ধতিগতভাবে আপগ্রেড করা হয়েছে:
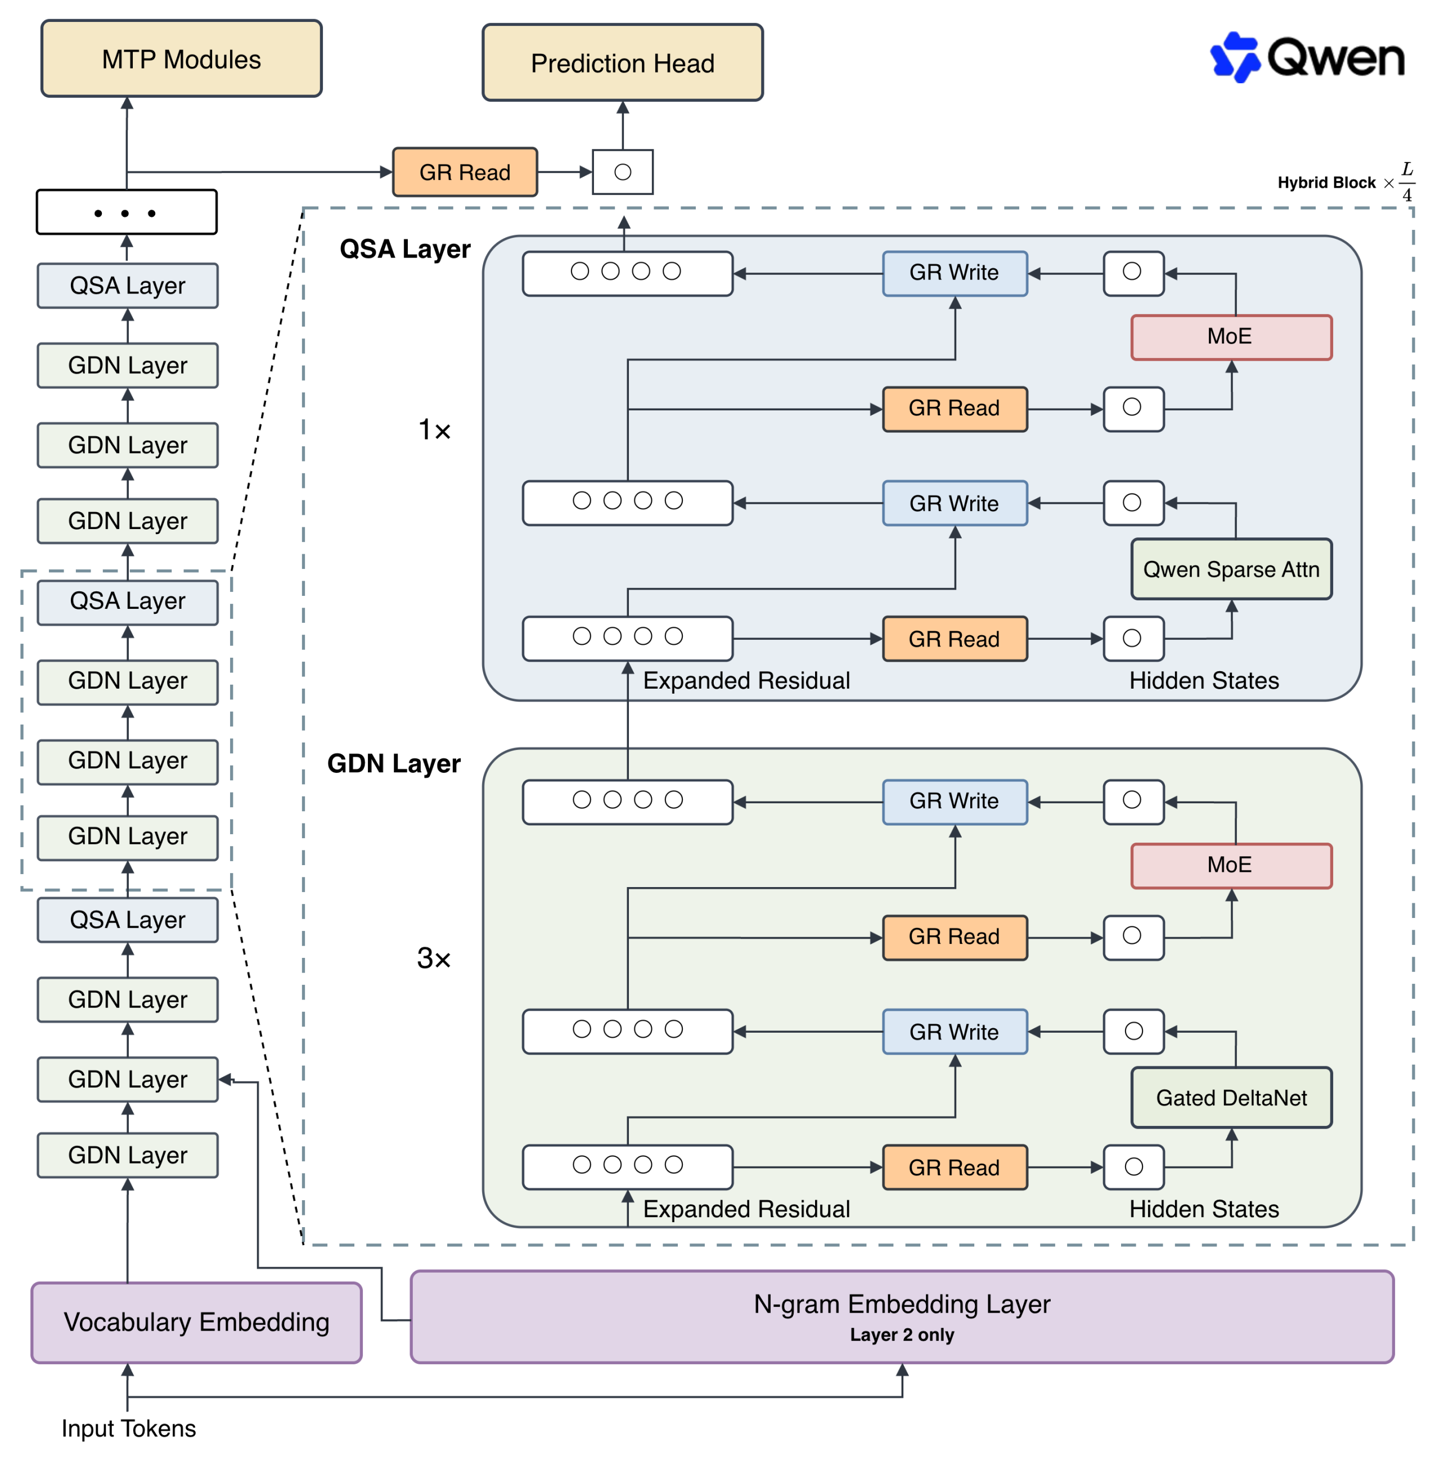
Attention-এর ক্ষেত্রে GDN(Gated DeltaNet)+ QSA(Qwen Sparse Attention)হাইব্রিড আর্কিটেকচার ব্যবহার করা হয়েছে। GDN দক্ষতার সঙ্গে ঐতিহাসিক তথ্য সংকুচিত করে, আর QSA হালকা Indexer-এর মাধ্যমে micro-block স্তরে গুরুত্বপূর্ণ কনটেক্সট বাছাই করে, ফলে দীর্ঘ সিকোয়েন্সের Attention ব্যয় উল্লেখযোগ্যভাবে কমে। 1M token-এর অতি দীর্ঘ কনটেক্সটের ক্ষেত্রে, QSA-এর Attention Kernel Prefill ও Decode পর্যায়ে যথাক্রমে সর্বোচ্চ 7.6 গুণ ও 4.9 গুণ গতি বৃদ্ধি করেছে।
Residual-এর ক্ষেত্রে Gated Residual(GR)মেকানিজম চালু করা হয়েছে। এতে residual flow-কে 4টি সমান্তরাল শাখায় সম্প্রসারণ করে dynamic Gate-এর মাধ্যমে তথ্য পড়া ও লেখা নিয়ন্ত্রণ করা হয়। Residual state FP8 স্টোরেজ সমর্থন করে, ফলে মেমরি অ্যাক্সেসের ব্যয় ব্যাপকভাবে কমে।
Embedding-এর ক্ষেত্রে 51B প্যারামিটারের N-gram Embedding চালু করা হয়েছে, যা স্থানীয় কনটেক্সটের মাধ্যমে টেবিল অনুসন্ধান করে মডেলের সক্ষমতা বাড়ায়। এই প্যারামিটারগুলো Host Memory-তে সরিয়ে রাখা যায় এবং asynchronous Prefetch-এর মাধ্যমে মডেলের গণনার সঙ্গে ওভারল্যাপ করা যায়, ফলে দীর্ঘ সময় GPU মেমরি দখল করে না।
Optimization-এর ক্ষেত্রে Muon Optimizer ব্যবহার করা হয়েছে এবং orthogonalization-এর নির্ভুলতা, প্যারামিটারের বিভাজন ও fused matrix splitting-সহ বিভিন্ন কৌশল অপ্টিমাইজ করা হয়েছে। নতুন আর্কিটেকচারের জন্য Scaling Law পুনরায় ফিট করা হয়েছে।
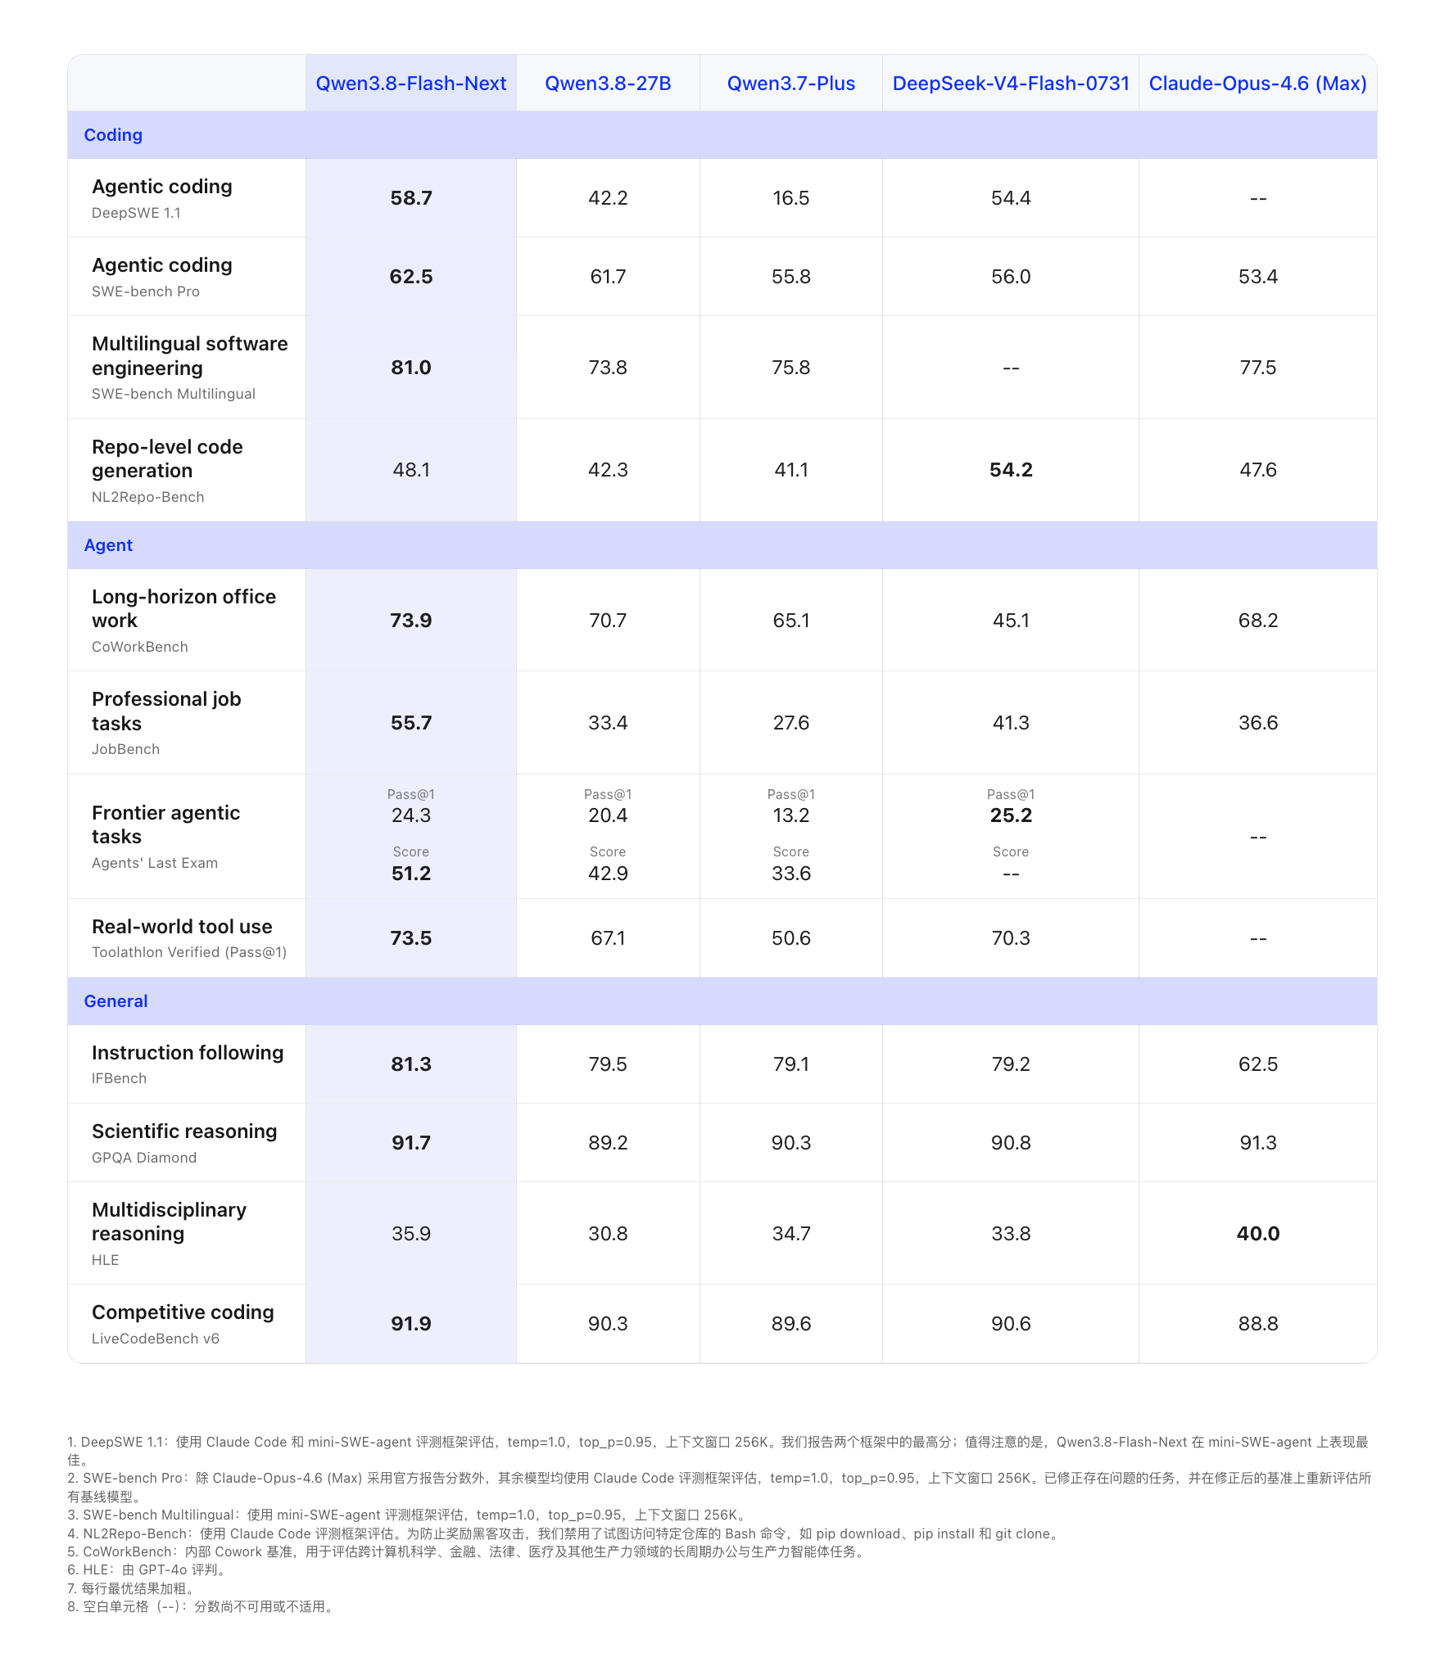
Qwen3.7-Plus-এর তুলনায় Qwen3.8-Flash-এর প্রশিক্ষণ খরচ আগেরটির মাত্র প্রায় এক-নবমাংশ, তবে কোডিং ও অফিসের কাজে এটি আরও শক্তিশালী সক্ষমতা প্রদর্শন করে।
6B সক্রিয় প্যারামিটারের অধীনে, Qwen3.8-Flash-Next-Base 14টি benchmark-এর মধ্যে 8টিতে সেরা ফল অর্জন করেছে। এর মধ্যে রয়েছে MMLU-Pro、SuperGPQA、BBH、SWEBench-Pretrain、MGSM ও MMMU।
শুধু টেক্সট:
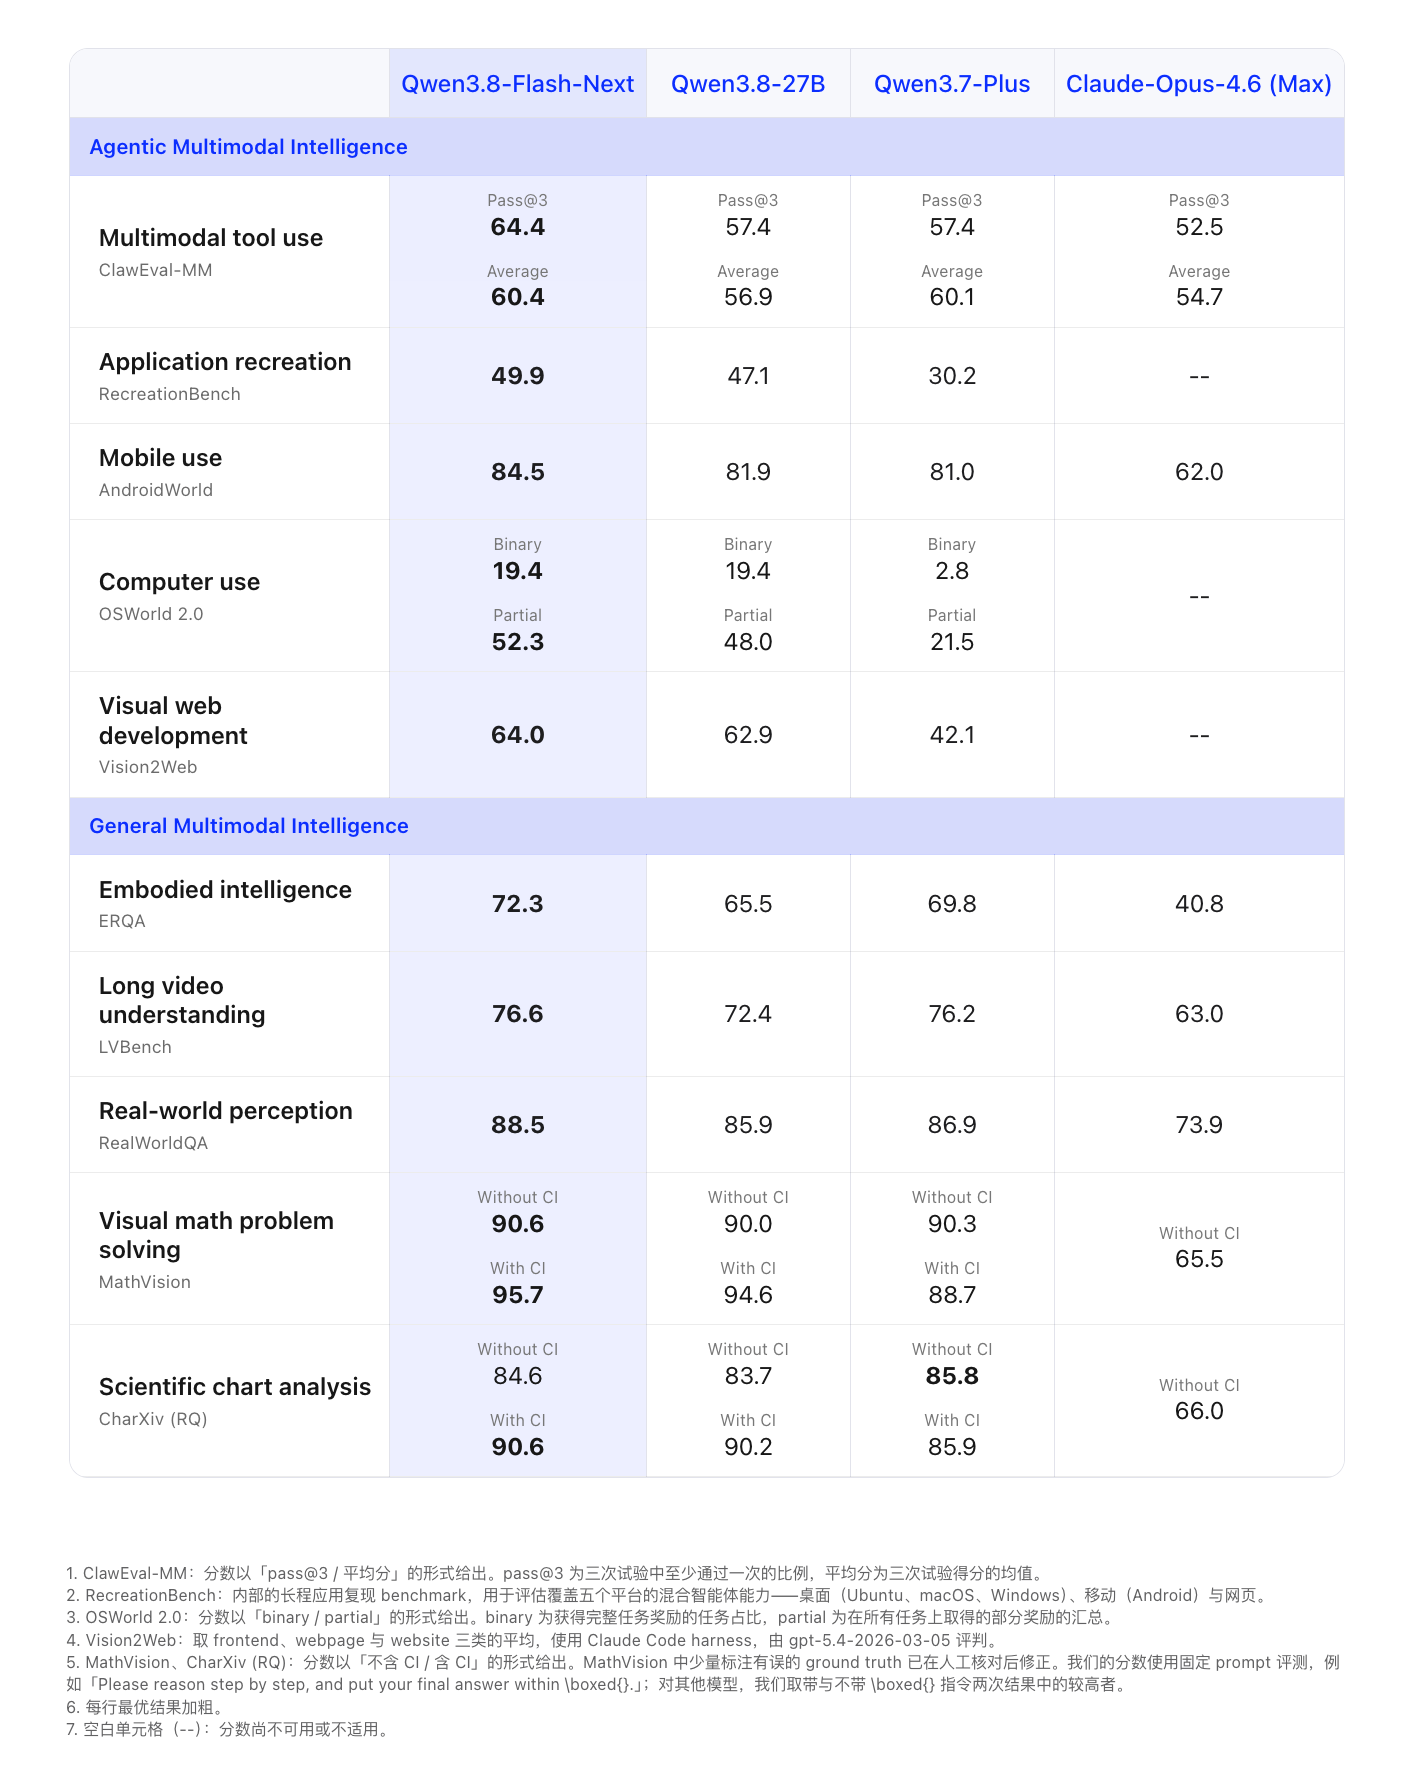
মাল্টিমোডাল:
মডেল কাঠামো:
Base মডেলের কর্মদক্ষতা:
Qwen3.8-Flash শিগগিরই Qwen AI প্ল্যাটফর্মে চালু হবে এবং বাহ্যিকভাবে API সেবা দেবে। মূল্য নির্ধারণ করা হয়েছে প্রতি মিলিয়ন Tokens ইনপুটে 1 ইউয়ান এবং আউটপুটে 3 ইউয়ান।
মডেলের ওজন বেইজিং সময় 8 আগস্ট 26 তারিখ 23:00-এ Hugging Face ও ModelScope প্ল্যাটফর্মে ওপেন সোর্স করা হয়েছে। একই সঙ্গে FP8 quantized সংস্করণও প্রকাশ করা হয়েছে। Qwen3.8-Flash-Next ডিফল্টভাবে 1M কনটেক্সট সমর্থন করে এবং এতে অফিসিয়াল টুল অন্তর্ভুক্ত রয়েছে।
তথ্যসূত্র:
প্রযুক্তিগত প্রতিবেদন: https://github.com/ QwenLM / Qwen3.8-Flash-Next / blob / main / tech_report.pdf
প্রযুক্তি ব্লগ: https://qwen.ai/ blog?id=qwen3.8-flash-next
Hugging Face: https://huggingface.co/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921FsyOPe& ;amp;amp;file=Qwen3.8-Flash-Next
ModelScope: https://modelscope.cn/models/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921XAP2dV& ;amp;amp;file=Qwen3.8-Flash-Next