

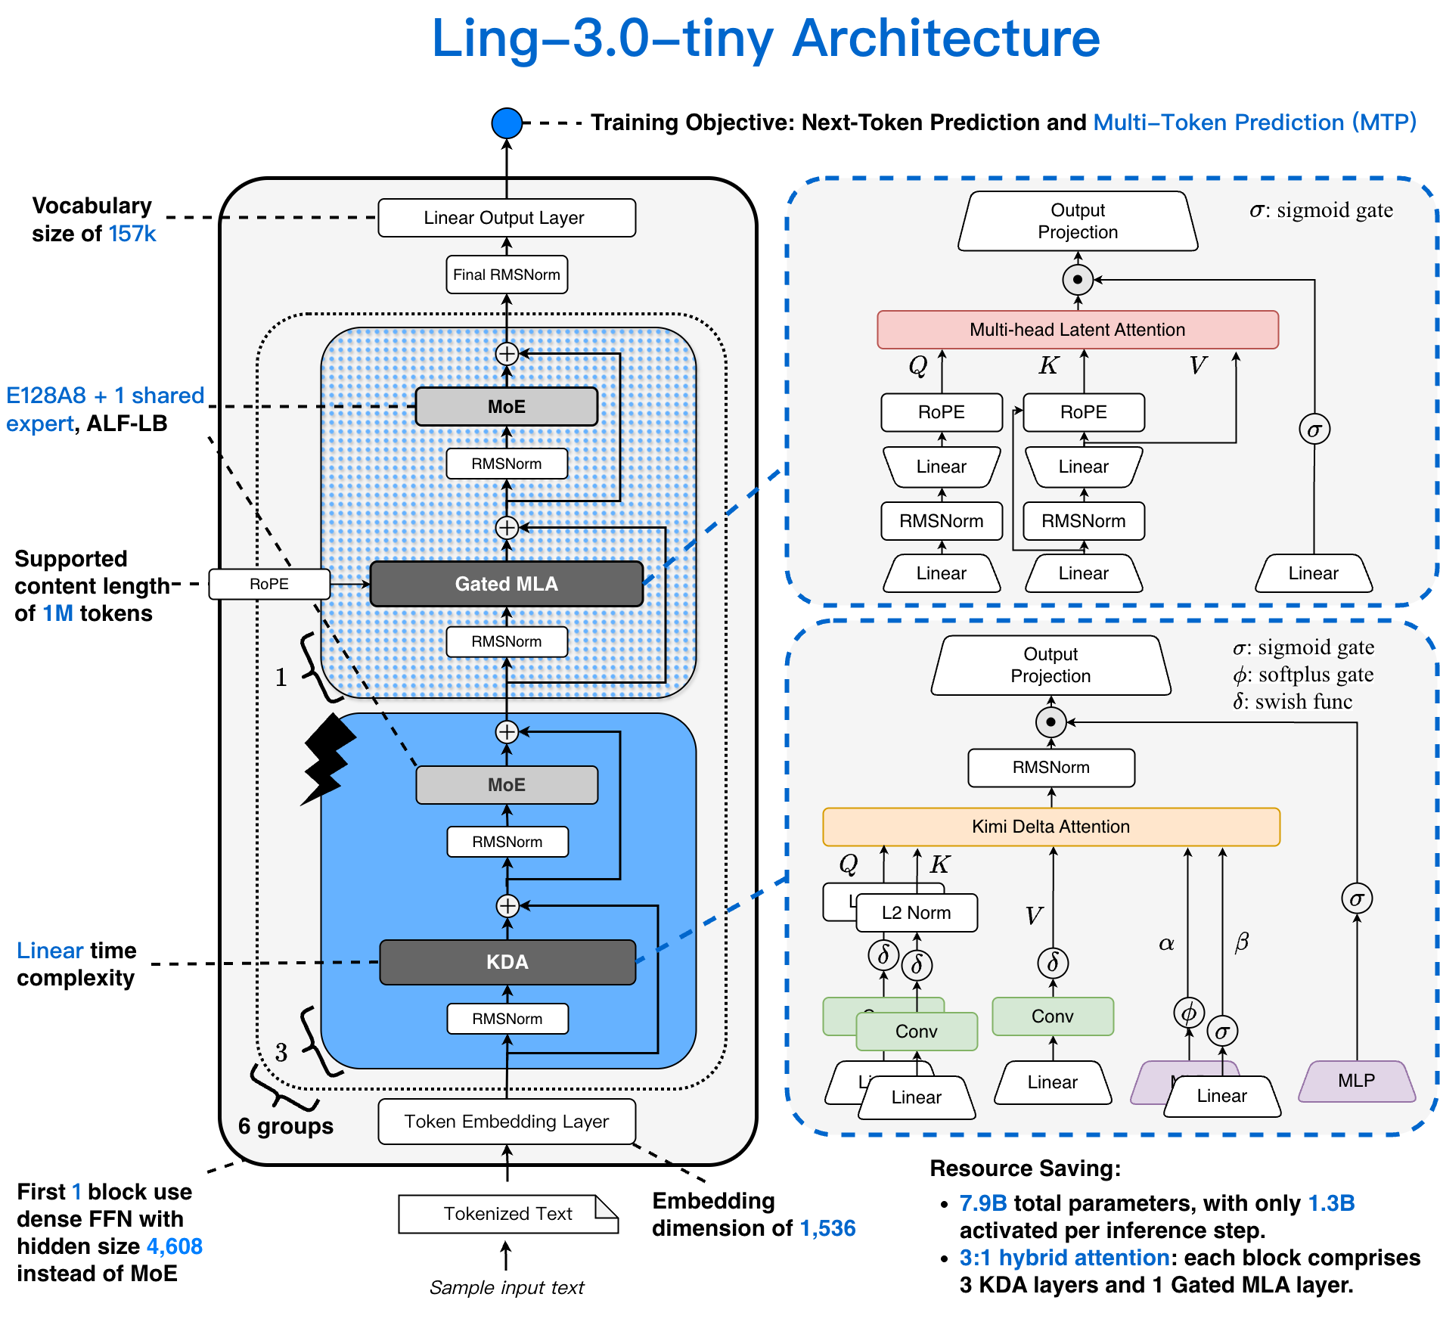
অ্যান্ট গ্রুপের Bailian আজ Hugging Face প্ল্যাটফর্মে Ling-3.0-tiny মডেলটি ওপেন-সোর্স করেছে। মডেলটি একটি হালকা হাইব্রিড রিজনিং MoE আর্কিটেকচার, যার মোট প্যারামিটার 7.9B এবং প্রতি Token-এ সক্রিয় প্যারামিটার 1.3B। অফিসিয়ালি BF16, FP8 এবং INT4 ওজনের সংস্করণ সরবরাহ করা হয়েছে, যা বিভিন্ন প্ল্যাটফর্মের ডিপ্লয়মেন্টের চাহিদা পূরণ করে।
জানা গেছে, Ling-3.0-tiny কম খরচে ইনফারেন্সের ওপর গুরুত্ব দেয়। এতে একটি দক্ষ হাইব্রিড লিনিয়ার আর্কিটেকচার ব্যবহৃত হয়েছে, যেখানে KDA (Kimi Delta Attention) এবং MLA (Multi-Head Latent Attention, মাল্টি-হেড ল্যাটেন্ট অ্যাটেনশন) 3:1 অনুপাতে পর্যায়ক্রমে সাজানো হয়েছে। এতে 128টি রাউটেড এক্সপার্টসহ একটি স্পার্স MoE ফিডফরোয়ার্ড নেটওয়ার্ক (FFN) রয়েছে, যা কনটেক্সট প্রক্রিয়াকরণের ক্ষমতা ও কম্পিউটিং খরচের মধ্যে ভারসাম্য বজায় রাখে।
মডেলটি দ্রুত প্রতিক্রিয়া মোড এবং বহু-ধাপের রিজনিং মোড সমর্থন করে। এটি স্থানীয় ডিপ্লয়মেন্টের জন্য বিশেষভাবে তৈরি। অফিসিয়ালি NVIDIA DGX Spark, Apple Silicon MacBook এবং Mac mini-সহ বিভিন্ন কম্পিউটারে এর কার্যকারিতা যাচাই করা হয়েছে। M4 Pro-এর MacBook-এ ইনফারেন্সের গতি প্রায় 86-90 Token/s-এ পৌঁছাতে পারে। 8K কনটেক্সট দৈর্ঘ্যে সর্বোচ্চ মেমরি ব্যবহার প্রায় 8.34 GiB।
তথ্যসূত্র:
inclusionAI/Ling-3.0-tiny · Hugging Face