

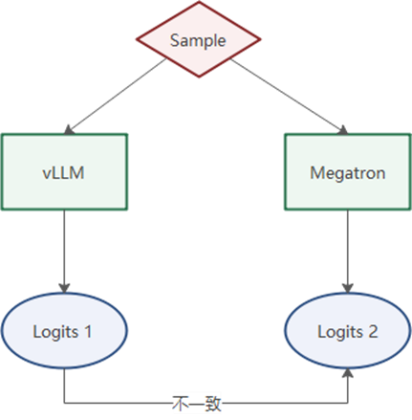
রিইনফোর্সমেন্ট লার্নিং বড় মডেল প্রশিক্ষণের প্রধান পদ্ধতিতে পরিণত হয়েছে এবং মডেল প্রযুক্তিকে শিল্পের গুরুত্বপূর্ণ ক্ষেত্রে প্রকৌশলগতভাবে প্রয়োগে এগিয়ে নিচ্ছে। এর মধ্যে প্রশিক্ষণ ও অনুমানের সামঞ্জস্য অত্যন্ত গুরুত্বপূর্ণ, কারণ অনুমান ও প্রশিক্ষণ প্রক্রিয়া পরস্পর সংযুক্ত এবং অবকাঠামোগত পার্থক্য অনিশ্চয়তাকে আরও বাড়িয়ে তুলতে পারে।
হুয়াওয়ে কম্পিউটিং কর্তৃপক্ষ ৫ আগস্ট ঘোষণা করেছে যে, শেংথেং Ascend C প্রোগ্রামিং ভাষার মাধ্যমে প্রশিক্ষণ-অনুমানের সামঞ্জস্যের জন্য সম্পূর্ণ অপারেটর সেট দিচ্ছে। Qwen3-30B MoE মডেলে পরীক্ষায় Logdiff 0 পাওয়া গেছে। পাশাপাশি শেংথেং-উপযোগী FA অপারেটর অপ্টিমাইজেশনের মাধ্যমে Eager মোডে ২০%-৬০% পারফরম্যান্স লাভ হয়েছে, যা ডেভেলপারদের জন্য দক্ষ ও নির্ভরযোগ্য রিইনফোর্সমেন্ট লার্নিং প্রশিক্ষণ সমাধান দিচ্ছে।
RL পোস্ট-ট্রেনিংয়ে প্রশিক্ষণ ও অনুমানের অসামঞ্জস্যের সবচেয়ে মৌলিক কারণ হলো নিম্নস্তরের গণনায় সঞ্চয়ের ক্রম সংরক্ষিত না থাকা। প্রশিক্ষণ ইঞ্জিন ও অনুমান ইঞ্জিনের প্রতিটি সঞ্চয়ের ক্রম ওপর থেকে নিচ পর্যন্ত এক রাখতে হলে ফ্রেমওয়ার্ক ও অপারেটর উভয় স্তরেই সমন্বিতভাবে কাজ করতে হবে। মডেলের প্যারামিটার যত বড় হয়, সমস্যা তত বাড়ে: টেনসর প্যারালালিজম, এক্সপার্ট প্যারালালিজমের মতো বিভাজন কৌশল এবং সমষ্টিগত যোগাযোগের পথের যেকোনো একটি ধাপ সঠিকভাবে সামঞ্জস্যপূর্ণ না হলে চূড়ান্ত true-on-policy অর্জন করা যায় না। অপারেটরকে বিভিন্ন কলের পরিস্থিতিও সমর্থন করতে হবে, গুরুত্বপূর্ণ গণনা ধাপে সীমাবদ্ধতা আরোপ করতে হবে এবং একই সঙ্গে পারফরম্যান্সের ক্ষতি ব্যবহারযোগ্য সীমায় রাখতে হবে। এটি একটি পদ্ধতিগত প্রকৌশলগত চ্যালেঞ্জ।
প্রশিক্ষণ ও অনুমানের অসামঞ্জস্য বলতে Rollout (অনুমান) ইঞ্জিন এবং প্রশিক্ষণ ইঞ্জিনের মধ্যে সংখ্যাগত অসামঞ্জস্য বোঝায়। উভয়টি সম্পূর্ণ একই মডেল ওজন ব্যবহার করলেও একই Token ক্রমের জন্য গণনা করা লগ-সম্ভাবনা (logprob)-তে সূক্ষ্ম পার্থক্য থাকতে পারে; এই পার্থক্য সাধারণত logdiff দিয়ে পরিমাপ করা হয়।
শেংথেং Ascend C প্রোগ্রামিং ভাষার মাধ্যমে প্রশিক্ষণ-অনুমান ব্যবস্থার গুরুত্বপূর্ণ অপারেটরগুলোতে পদ্ধতিগত সীমাবদ্ধতা ও সামঞ্জস্য প্রয়োগ করেছে। মূল ধারণাটি হলো: প্রশিক্ষণ ও অনুমান যেখানে সঞ্চয় করা প্রয়োজন, সেখানে একই সংখ্যাগত পথ ব্যবহার করবে। এতে প্রধানত নিম্নলিখিত ৪টি পরিবর্তন রয়েছে:
অ্যাটেনশনের সেমান্টিক্স একীভূতকরণ: প্রশিক্ষণ মাস্ক Softmax এবং অনুমানের ধাপে ধাপে অ্যাটেনশনের কার্যকর অবস্থানগুলোর গণনাক্ষেত্র সামঞ্জস্য করা হয়েছে, যাতে দৃশ্যমান Token সমষ্টির পার্থক্য থেকে তৈরি সংখ্যাগত ফারাক দূর হয়।
reduce সঞ্চয়ের ক্রম নির্ধারণ: প্রশিক্ষণের FA এবং অনুমানের PFA / PagedAttention-এর রিডাকশন মাত্রায় বিভাজন ও রিডাকশনের ক্রম নির্ধারণ করা হয়েছে, যাতে “একই টেমপ্লেট, ভিন্ন বিভাজন” থেকে সঞ্চয়ের ক্রম সংরক্ষিত না থাকার সমস্যা এড়ানো যায়।
অনলাইন Softmax ব্লক বিভাজন কৌশলের সামঞ্জস্য: ব্লকের আকার ও রিডাকশনের ছন্দ একীভূত করা হয়েছে, যাতে decoder পাশে একাধিক ব্লক একত্র করার Softmax এবং প্রশিক্ষণ পাশের ব্লকভিত্তিক Softmax-এর মধ্যে অসামঞ্জস্য না থাকে।
গুরুত্বপূর্ণ পথের নির্ভুলতার সামঞ্জস্য: Softmax সঞ্চয়ের মতো সংবেদনশীল ধাপে নির্ভুলতা রূপান্তরের কৌশল একীভূত করা হয়েছে, যাতে মিশ্র-নির্ভুলতা বাস্তবায়নের পার্থক্য থেকে সৃষ্ট নিম্ন-বিটের ত্রুটি কমে।
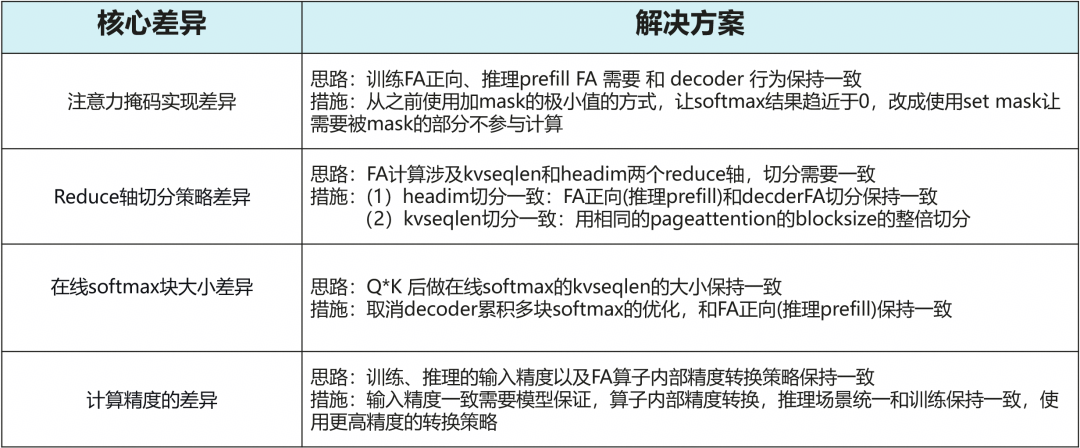
এর ভিত্তিতে FA বিতরণ ও শিডিউলিং অপ্টিমাইজেশনের সঙ্গে সমন্বয় করে প্রশিক্ষণ ও অনুমানের সামঞ্জস্য আর উল্লেখযোগ্য পারফরম্যান্স পতনের বিনিময়ে অর্জন করতে হবে না। ফলে বাস্তব পরীক্ষায় একই সঙ্গে logdiff=0 এবং এন্ড-টু-এন্ড ত্বরান্বিতকরণ পাওয়া গেছে।
হুয়াওয়ে ঘোষণা করেছে যে সংশ্লিষ্ট অবকাঠামো ইতিমধ্যে ওপেন সোর্স করা হয়েছে। পাশাপাশি “প্রশিক্ষণ-অনুমান সামঞ্জস্য সমস্যা শনাক্তকরণ Skill” চালু করা হবে, যা অবশিষ্ট logdiff শনাক্ত করতে এবং সমস্যাটি অপারেটর পথের নাকি ফ্রেমওয়ার্ক বাস্তবায়নের পার্থক্যের কারণে হয়েছে তা নির্ণয় করতে সহায়তা করবে।
ওপেন সোর্স ঠিকানা:
https://github.com/verl-project/verl-ascend-recipe/tree/main/true_on_policy