

জিপু আজ আনুষ্ঠানিকভাবে GLM-5.3 প্রকাশ করেছে। GLM-5.2-এর তুলনায় এর বেস মডেল অপরিবর্তিত থাকলেও, পোস্ট-ট্রেনিং Scaling-এর মাধ্যমে মডেলটির বুদ্ধিমত্তার সর্বোচ্চ সীমা ব্যাপকভাবে বাড়ানো হয়েছে: কয়েক ডজন গুণ বেশি দীর্ঘমেয়াদি টাস্ক পরিবেশ, আরও সমৃদ্ধ ও বৈচিত্র্যময় পরিবেশের ধরন এবং অত্যন্ত দীর্ঘ পোস্ট-ট্রেনিং সময়।
আগের প্রজন্মের তুলনায় GLM-5.3-এর নতুন সক্ষমতাগুলোর মধ্যে রয়েছে:
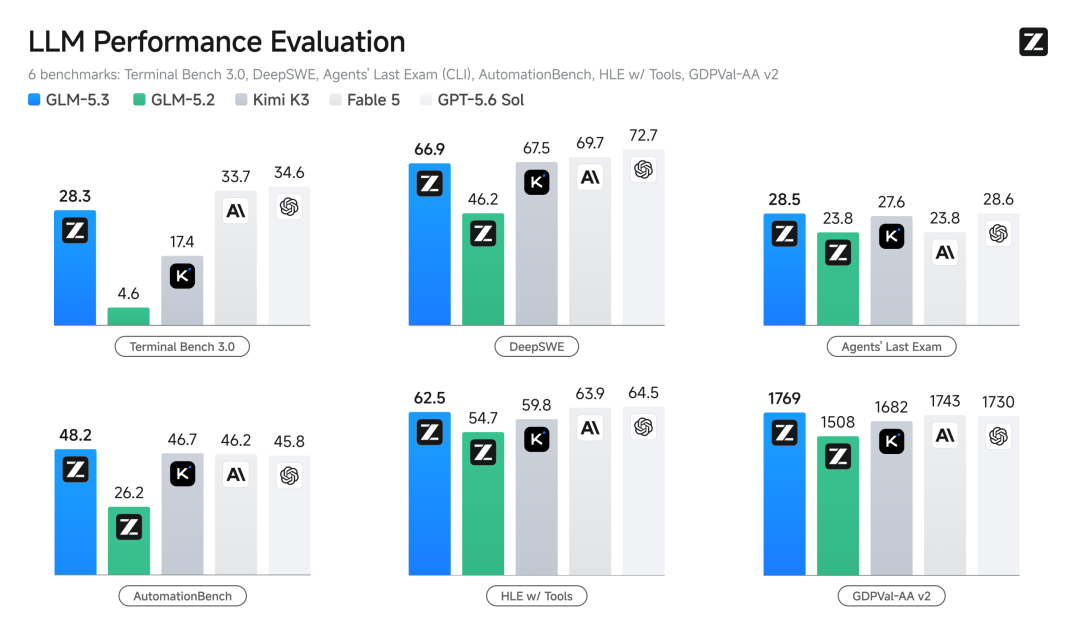
আরও শক্তিশালী প্রোগ্রামিং সক্ষমতা। GLM-5.3 হলো প্রোগ্রামিং সক্ষমতার দিক থেকে সবচেয়ে শক্তিশালী ওপেন সোর্স মডেল। জিপুর অভ্যন্তরীণ বাস্তব-অভিজ্ঞতা মূল্যায়নে এটি GLM-5.2-এর তুলনায় ৫০% উন্নতি করেছে এবং Terminal Bench 3.0, Agents' Last Exam (CLI)-সহ বিভিন্ন পাবলিক বেঞ্চমার্কে ওপেন সোর্স মডেলগুলোর মধ্যে প্রথম স্থান অর্জন করেছে।
সাইবার নিরাপত্তা সক্ষমতা। হোয়াইট-বক্স কোড পর্যালোচনা ও দুর্বলতা শনাক্তকরণের মতো নিরাপত্তা-সংক্রান্ত কাজে GLM-5.3-এর পারফরম্যান্স Mythos 5-এর সমতুল্য, যা সাইবার নিরাপত্তা প্রতিরক্ষা প্রেক্ষাপটে এর শক্তিশালী সম্ভাবনা দেখায়।
পোস্ট-ট্রেনিং Scaling। উপরের সব উন্নতিই পোস্ট-ট্রেনিং থেকে এসেছে। IndexShare, SAO এবং ক্রমাগত বিকশিত নতুন প্রজন্মের Slime ফ্রেমওয়ার্কের ওপর ভিত্তি করে, জিপু GLM-5.2-এর সম্পূর্ণ অপরিবর্তিত বেসের ওপর দক্ষতার সঙ্গে রিইনফোর্সমেন্ট লার্নিং এগিয়ে নিয়েছে। সম্ভবত জিপু এখনও এই বেস মডেলের বুদ্ধিমত্তার সর্বোচ্চ সীমা পুরোপুরি উন্মোচন করতে পারেনি।
ওপেন সোর্স। প্রকাশের দুই সপ্তাহ পর জিপু মডেলের ওজন উন্মুক্ত করবে। এর আগে নিরাপত্তা মূল্যায়ন ও মডেল শক্তিশালীকরণ সম্পন্ন করা হবে।
জিপুর দাবি, একাধিক প্রধান বেঞ্চমার্কে GLM-5.3 বর্তমানে সর্বোচ্চ স্থানধারী ওপেন সোর্স মডেল। প্রোগ্রামিং ও এজেন্ট সক্ষমতায় এটি Claude Fable 5-এর কাছাকাছি এবং প্রোগ্রামিংয়ের বাস্তব-অভিজ্ঞতায় অন্যান্য দেশীয় মডেলকে ছাড়িয়ে গেছে।
বাস্তব টার্মিনাল পরিবেশে জটিল কাজ সম্পন্ন করার মডেলের সক্ষমতা পরিমাপকারী Terminal-Bench 3.0-এ GLM-5.3-এর স্কোর ৪.৬ থেকে বেড়ে ২৮.৩ হয়েছে;
দীর্ঘমেয়াদি সফটওয়্যার ইঞ্জিনিয়ারিং ও ধারাবাহিক কোড পরিবর্তন সক্ষমতায় গুরুত্ব দেওয়া DeepSWE v1.1-এ স্কোর ৪৬.২ থেকে বেড়ে ৬৬.৯ হয়েছে;
বিভিন্ন বাস্তব পেশাগত ক্ষেত্র কভার করা এবং টুলগুলোর মধ্যে সহযোগিতা ও দীর্ঘমেয়াদি কাজে গুরুত্ব দেওয়া Agents' Last Exam-এ স্কোর ২৩.৮ থেকে বেড়ে ২৮.৫ হয়েছে;
৪৪টি পেশা কভার করা এবং বাস্তব উচ্চ-মূল্যের জ্ঞানভিত্তিক কাজ মূল্যায়নকারী GDPval-AA v2-এ স্কোর ১,৭৬৯, যা প্রোগ্রামিং সক্ষমতা থেকে উদ্ভূত পেশাগত কাজ সম্পাদনের ক্ষমতা প্রদর্শন করে।
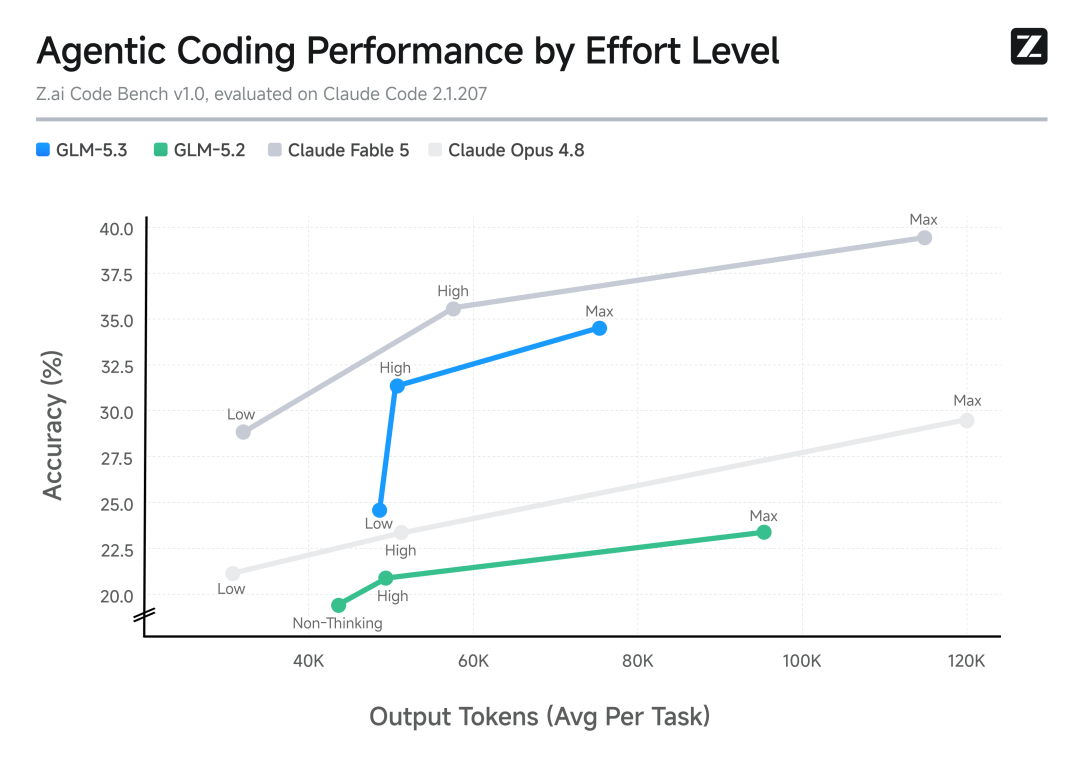
জিপুর নিজস্ব Z.ai Code Bench মূল্যায়ন মডেলের বাস্তব প্রোগ্রামিং পরিস্থিতিতে সামগ্রিক ব্যবহারিক অভিজ্ঞতা পরিমাপ করে। মডেলটিকে একটি জটিল স্থানীয় ডেভেলপমেন্ট পরিবেশে স্থাপন করা হয় এবং বিভিন্ন চিন্তন স্তরে এন্ড-টু-এন্ড কাজ সম্পন্ন করতে দেওয়া হয়, যা ডেভেলপাররা Coding Agent ব্যবহার করার বাস্তব অভিজ্ঞতার আরও কাছাকাছি।
পরীক্ষার ফলাফল দেখায়, GLM-5.3 কার্যকারিতা ও Token ব্যবহারের দক্ষতার মধ্যে আরও ভালো ভারসাম্য অর্জন করেছে। High স্তরে GLM-5.3 ৩১.৪% নির্ভুলতা অর্জন করেছে, যা Claude Opus 4.8-এর সর্বোচ্চ স্তরের ২৯.৫%-কে ছাড়িয়ে গেছে। প্রতিটি কাজে এটি গড়ে প্রায় ৫০ হাজার tokens আউটপুট দেয়, যেখানে Opus 4.8-এর প্রয়োজন প্রায় ১২০ হাজার tokens। এর অর্থ, GLM-5.3 আরও সংক্ষিপ্ত কার্যপথে কাজ সম্পন্ন করতে পারে।
আজ থেকেই জিপুর অফিসিয়াল প্রোগ্রামিং টুল ZCode এবং উৎপাদনশীলতা টুল AutoClaw চালু হয়েছে। GLM Coding Plan-এর সব ব্যবহারকারীর জন্য সম্পূর্ণ কোটা এবং সাবস্ক্রিপশনও উন্মুক্ত করা হয়েছে।
TraeWork / TraeCode / 扣子, WorkBuddy / CodeBuddy, Qoder / QwenWork, CatPaw, JoyCode, OpenCode-সহ বিভিন্ন কোডিং প্ল্যাটফর্মে আগাম ব্যবহারের সুযোগ উন্মুক্ত করা হয়েছে।
API শিগগিরই চালু হবে। সম্পূর্ণ মডেল ওজন দুই সপ্তাহের মধ্যে ওপেন সোর্স করা হবে। এর আগে প্রয়োজনীয় নিরাপত্তা শক্তিশালীকরণ সম্পন্ন করতে হবে, যাতে সম্ভাব্য আক্রমণক্ষমতা যতটা সম্ভব সীমিত রেখে প্রতিরক্ষামূলক মূল্য বজায় রাখা যায়।
আজ ১৩:০০টায় GLM Coding Plan-এর সব ব্যবহারকারীর কোটা রিসেট হবে। সব ব্যবহারকারী后台-এর「ব্যবহারের পরিসংখ্যান」এ পুনরায় পূর্ণ ব্যবহারযোগ্য কোটা দেখতে পারবেন।