

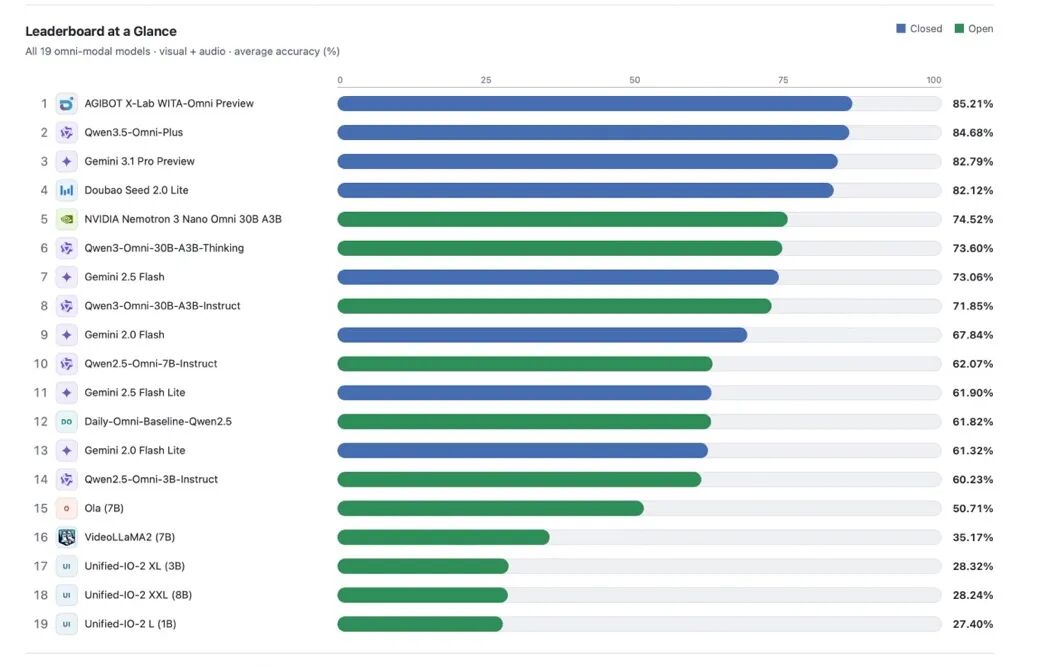
Zhipu AGIBOT-এর WeChat পাবলিক অ্যাকাউন্টের তথ্য অনুযায়ী, সম্প্রতি এমবডিড সর্বমোডাল বোঝাপড়ার স্বীকৃত তালিকা DailyOmni-এর সর্বশেষ মূল্যায়নের ফল প্রকাশিত হয়েছে। Zhipu-এর নিজস্বভাবে উন্নয়ন করা এমবডিড-নেটিভ সর্বমোডাল বৃহৎ মডেল WITA-Omni Preview অডিও-ভিডিও যৌথ বোঝাপড়া ও সময়ক্রমিক যুক্তির অগ্রগণ্য সক্ষমতার মাধ্যমে ৮৫.২১ পয়েন্টের সামগ্রিক ফল নিয়ে শীর্ষস্থান অর্জন করেছে। এটি Qwen, Gemini, Doubao, NVIDIA-সহ দেশ-বিদেশের শীর্ষস্থানীয় মডেলগুলোকে ছাড়িয়ে গেছে এবং আটটি উপ-সূচকের মধ্যে ছয়টিতে প্রথম হয়েছে।
IT之家-এর জানা মতে, DailyOmni হলো অডিও-ভিডিওর সময়ক্রমিক সামঞ্জস্য এবং আন্তঃমোডাল যৌথ যুক্তির সক্ষমতা যাচাইয়ের জন্য শিল্পক্ষেত্রে স্বীকৃত একটি নির্ভরযোগ্য তৃতীয় পক্ষের তালিকা। ছবি-লেখা বা স্বল্পদৈর্ঘ্য ভিডিওভিত্তিক প্রচলিত মূল্যায়ন কাজের বিপরীতে, এই তালিকায় বাস্তব উন্মুক্ত পরিবেশের অডিও-ভিডিও উপাদান ব্যাপকভাবে ব্যবহার করা হয়। এর মূল পরীক্ষা হলো মডেলটি ভিজ্যুয়াল দৃশ্য ও পরিবেশগত অডিও তথ্য একত্র করতে পারে কি না, শব্দ ও ছবির পারস্পরিক সম্পর্ক, ঘটনাগুলোর ক্রম এবং আন্তঃমোডাল অর্থ সঠিকভাবে শনাক্ত করতে পারে কি না। এই সক্ষমতাগুলো বাস্তব ভৌত পরিবেশে মানবাকৃতির রোবটের মানুষ-রোবট মিথস্ক্রিয়ার জন্য প্রয়োজনীয় মূল অনুধাবন ক্ষমতার সঙ্গে ঘনিষ্ঠভাবে সামঞ্জস্যপূর্ণ।
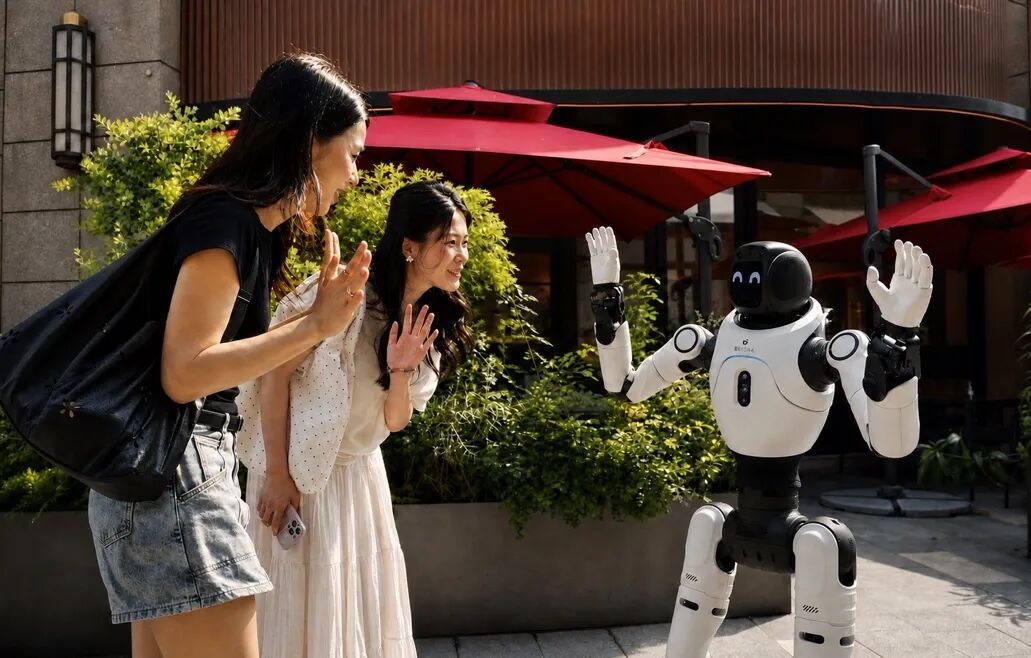
কর্তৃপক্ষ জানিয়েছে, WITA-Omni-এর অগ্রগতির মূল কারণ হলো এটি কেবল একটি চ্যাট মডেলকে রোবটের মধ্যে “স্থাপন” করেনি। বরং এটি শারীরিক ক্রিয়া ও অভিব্যক্তিকে কণ্ঠস্বরের সমান্তরালে প্রথম-স্তরের আউটপুটে উন্নীত করেছে এবং একটি নেটিভ এন্ড-টু-এন্ড মডেলের মাধ্যমে অনুধাবন, সিদ্ধান্ত গ্রহণ ও প্রকাশকে একীভূতভাবে পরিচালনা করে। Thinker–Talker প্যারাডাইম থেকে এটি এমবডিড আউটপুটের জন্য আরও বিস্তৃত Thinker–Talker–Actor আর্কিটেকচার তৈরি করেছে।
WITA-Omni-এর অগ্রগতি কেবল মডেলের আকারের ওপর নির্ভরশীল নয়; এর পেছনে রয়েছে এমবডিড সর্বমোডাল মিথস্ক্রিয়াকে কেন্দ্র করে নির্মিত স্তরভিত্তিক ডেটা ব্যবস্থা এবং লক্ষ্যনির্দিষ্ট প্রশিক্ষণ পদ্ধতি। মধ্য-প্রশিক্ষণ পর্যায়ে WITA-Omni মোট কোটি ঘণ্টা-পর্যায়ের উন্মুক্ত ও নিজস্ব মাল্টিমোডাল ডেটা ব্যবহার করেছে। এর ফলে শক্তিশালী টেক্সট ও ভিশন ভিত্তিকে এমন একটি সর্বমোডাল মডেলে উন্নীত করা হয়েছে, যা “শুনতে, বুঝতে এবং অডিও-ভিজ্যুয়াল যৌথ যুক্তি সম্পাদন করতে” পারে।
এছাড়া, উন্মুক্ত অডিও-ভিডিও ডেটায় সাধারণত বাস্তব মিথস্ক্রিয়ার পালা পরিবর্তন, প্রতিক্রিয়ার সময়, ক্রিয়া ও অভিব্যক্তির তথ্য অনুপস্থিত থাকে। ফলে এগুলো দিয়ে সরাসরি এন্ড-টু-এন্ড এমবডিড মিথস্ক্রিয়া মডেল প্রশিক্ষণ দেওয়া কঠিন। এ কারণে Zhipu মানুষকে কেন্দ্র করে বাস্তব মিথস্ক্রিয়ার পরিস্থিতির জন্য একটি বৃহৎ উচ্চমানের সর্বমোডাল ডেটাসেট তৈরি করেছে, যেখানে শব্দ, দৃশ্য, ভাষা, ক্রিয়া ও অভিব্যক্তির মধ্যকার স্বাভাবিক সময়ক্রমিক সম্পর্ক সম্পূর্ণভাবে সংরক্ষিত রয়েছে।