

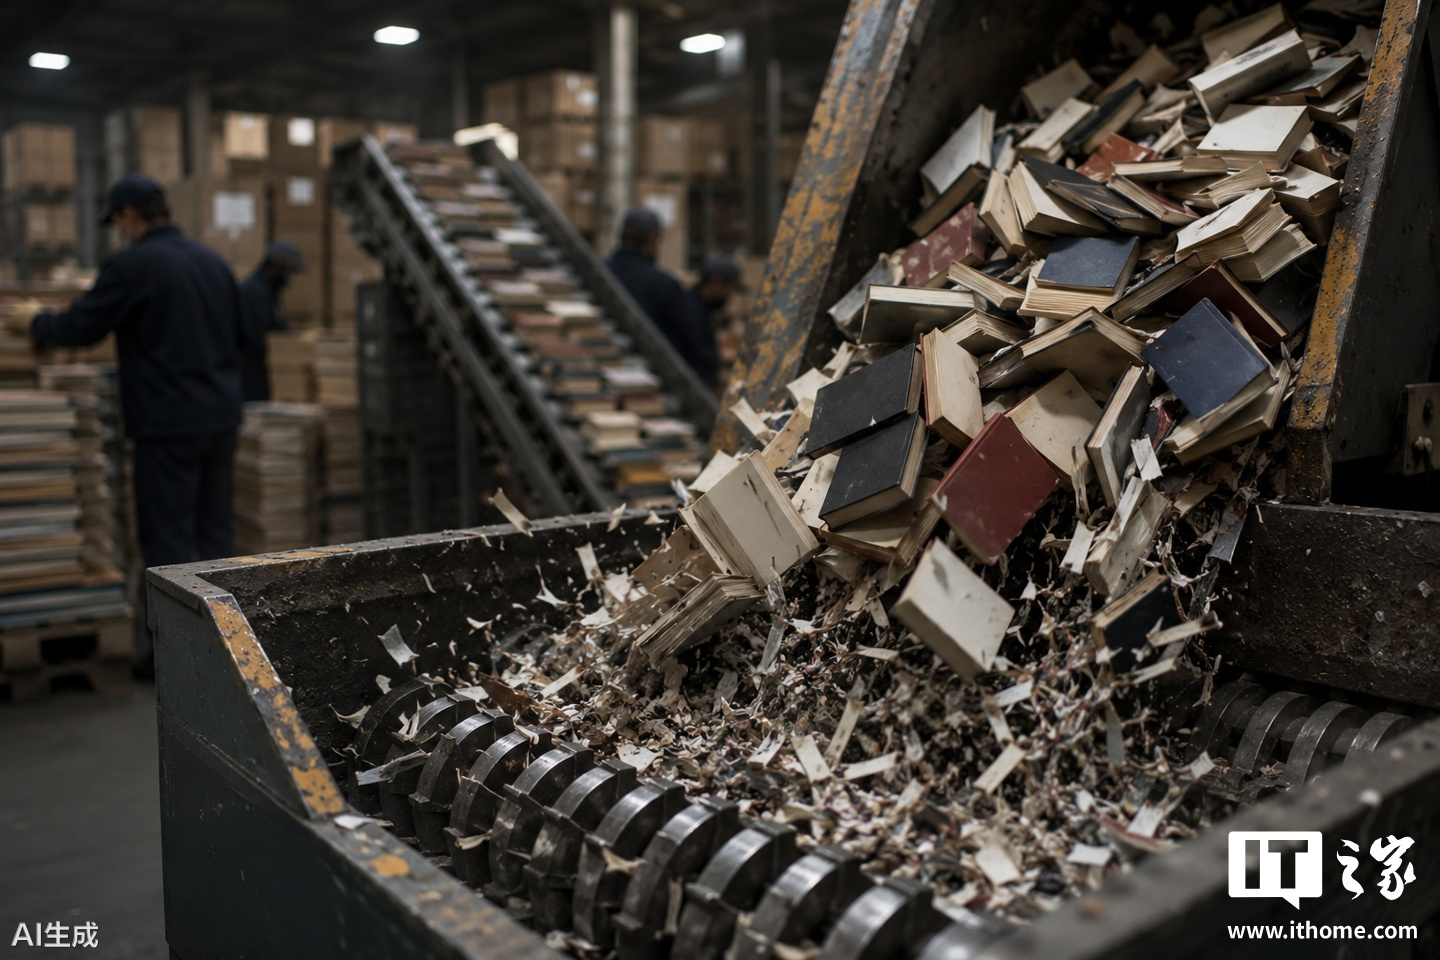
মেমরি ও স্টোরেজের সংকট ক্রমেই বাড়িয়ে তোলার পর AI কোম্পানিগুলো এখন যেন মানবজাতির সাহিত্যিক ঐতিহ্যের দিকেও নজর দিচ্ছে। অনুসন্ধানী সংবাদমাধ্যম 404 Media-এর সাম্প্রতিক প্রতিবেদনে বলা হয়েছে, একাধিক AI কোম্পানি জনমতের বিরূপ প্রতিক্রিয়া এড়ানোর পাশাপাশি AI মডেল প্রশিক্ষণের জন্য উচ্চমানের প্রশিক্ষণ ডেটা সংগ্রহ করতে মধ্যস্থতাকারীদের মাধ্যমে ব্যাপকভাবে পুরোনো বই কিনছে।
AI-এর বিকাশ বিপুল পরিমাণ ডেটার ওপর নির্ভরশীল, তবে সব ডেটার মূল্য সমান নয়; মূল বিষয় হলো ডেটার মান। সাম্প্রতিক বছরগুলোতে AI-উৎপাদিত বিপুল নিম্নমানের কনটেন্ট, যা প্রচলিতভাবে ‘AI আবর্জনা কনটেন্ট’ নামে পরিচিত, ইন্টারনেট ভরিয়ে ফেলেছে। এটি শুধু ডেটার পরিবেশকে দূষিত করেনি, AI-এর পরবর্তী শেখার কার্যকারিতাও কমিয়েছে। তাই শীর্ষস্থানীয় AI কোম্পানিগুলো আবার মানুষের তৈরি কনটেন্ট খুঁজতে শুরু করেছে, বিশেষ করে ২০২২ সালের আগে প্রকাশিত মুদ্রিত বই, কারণ এগুলো মৌলিক রচনা হওয়ার সম্ভাবনা বেশি এবং AI-উৎপাদিত কনটেন্টের দূষণ থেকে এখনো মুক্ত থাকার সম্ভাবনাও রয়েছে।
মডেল প্রশিক্ষণে মুদ্রিত বই ব্যবহারের নজির AI কোম্পানিগুলোর আগে থেকেই রয়েছে। বর্তমানে কপিরাইট মামলায় জড়িত প্রধান AI কোম্পানিগুলোর অন্যতম Anthropic একবার বিপুল পরিমাণ মুদ্রিত বই কিনতে কয়েক মিলিয়ন ডলার ব্যয় করেছিল। এসব বই থেকে কনটেন্ট নিয়ে Claude AI মডেল প্রশিক্ষণের পর বইগুলো ধ্বংস করে ফেলা হয়। জানা গেছে, কোম্পানিটি Better World Books থেকে বিপুল পরিমাণ বই কিনেছিল। আদালত যদিও রায় দিয়েছে যে কপিরাইটযুক্ত বই AI প্রশিক্ষণে ব্যবহার করা কপিরাইট আইনের ‘ন্যায্য ব্যবহার’-এর আওতায় পড়ে, তবে ৭০ লাখ চুরি করা বইয়ের একটি ডেটাবেস দীর্ঘদিন সংরক্ষণ করায় Anthropic লেখক ও প্রকাশকদের কপিরাইট লঙ্ঘন করেছে। শেষ পর্যন্ত কোম্পানিটিকে সর্বোচ্চ ১৫০ কোটি মার্কিন ডলার ক্ষতিপূরণ দিতে হয় (দ্রষ্টব্য: বর্তমান বিনিময় হারে প্রায় ১০১.৬২ বিলিয়ন চীনা ইউয়ান)।
একই ধরনের বিতর্ক Google-কেও ঘিরে দেখা দিয়েছে। সম্প্রতি একটি প্রকাশক জোট Google-এর বিরুদ্ধে মামলা করেছে। তাদের অভিযোগ, অনুমতি ছাড়াই কপিরাইট-সুরক্ষিত লাখ লাখ বই ব্যবহার করে Gemini AI মডেল প্রশিক্ষণ দেওয়া হয়েছে।
১ কোটি ১১ লাখেরও বেশি বইয়ের ক্যাটালগ তথ্য থাকা অনলাইন ডেটাবেস ISBNdb দীর্ঘদিন ধরে বই বিক্রেতা, গ্রন্থাগার ও পরিবেশকদের জন্য একটি গুরুত্বপূর্ণ প্ল্যাটফর্ম। AI শিল্পের দ্রুত বিকাশের সঙ্গে সঙ্গে ISBNdb-ও ব্যবসার দিক পরিবর্তন করতে শুরু করেছে এবং AI প্রতিষ্ঠানগুলোর জন্য বিশেষভাবে বড় পরিসরে বই কেনার সেবা চালু করেছে।
404 Media-এর প্রতিবেদনে বলা হয়েছে, সংশ্লিষ্ট অর্ডারের পরিমাণ একবারে ১ হাজার বই থেকে একবারে ১০ লাখ বই পর্যন্ত হতে পারে।
নাম প্রকাশে অনিচ্ছুক এক পেশাদার বই বিক্রেতা জানান, চলতি বছরের এপ্রিল থেকে বইয়ের বিক্রি অভূতপূর্বভাবে বেড়েছে। ব্যবসা ভালো থাকলেও আগে সপ্তাহে প্রায় ২০টি বই বিক্রি হতো; কিন্তু সাম্প্রতিক কয়েক মাসে সাপ্তাহিক বিক্রি বেড়ে কয়েকশতে পৌঁছেছে, যা স্বাভাবিক বিক্রির প্রায় পাঁচ গুণ।
Alibris, Biblio-এর মতো পুরোনো বইয়ের লেনদেন প্ল্যাটফর্মের অন্যান্য বই বিক্রেতারাও একই ধরনের বড় পরিসরের কেনাকাটার কথা জানিয়েছেন।
যদিও এসব কেনাকাটা নিশ্চিতভাবে ISBNdb বা কোনো নির্দিষ্ট AI কোম্পানির কাছ থেকে এসেছে, এমন অকাট্য প্রমাণ এখনো নেই, তবু এতে বেশ কিছু অস্বাভাবিকতা রয়েছে। উদাহরণস্বরূপ, বড় পরিসরে কেনা বইগুলোর প্রায় সবকটিতেই আন্তর্জাতিক মান বই নম্বর (ISBN) রয়েছে। ১৩ অঙ্কের এই কোডটি বিশ্বব্যাপী বই শনাক্ত করার একক পরিচয়চিহ্ন।
এ ছাড়া এসব কেনাকাটায় বিষয়, ধরন বা লেখক নিয়ে প্রায় কোনো পছন্দই দেখা যায় না। উপন্যাস, পাঠ্যবই কিংবা পেশাগত বই, সবই কেনার তালিকায় রয়েছে। আরও আশ্চর্যের বিষয় হলো, ক্রেতারা যেন দামের ব্যাপারে সম্পূর্ণ উদাসীন; কিছু বই বাজারদরের চেয়ে স্পষ্টতই বেশি দামে থাকলেও সেগুলো সরাসরি কিনে নেওয়া হচ্ছে।
Anthropic-এর কপিরাইট মামলার সময় Google Books প্রকল্পে কাজ করা এবং পরে Anthropic-এর ‘পানামা প্রকল্প (Project Panama)’ ডিজিটাইজেশন প্রকল্পের দায়িত্বে থাকা টম হার্ভে (Tom Harvey) নিশ্চিত করেন যে Anthropic মুদ্রিত বই ডিজিটাল রূপান্তরের জন্য একাধিক পেশাদার নথি স্ক্যানিং কোম্পানিকে নিয়োগ করেছিল।
সহযোগী প্রতিষ্ঠানগুলোর একটি ছিল Datamation Information Services। প্রতিষ্ঠানটি বই ডিজিটাইজ করার জন্য অক্ষত স্ক্যানিং এবং ধ্বংসাত্মক স্ক্যানিং, উভয় ধরনের সেবা দেয়।
অক্ষত স্ক্যানিংয়ে সাধারণত ওপর থেকে ছবি নেওয়া স্ক্যানার, ফ্ল্যাটবেড স্ক্যানার বা V-আকৃতির স্ক্যানিং যন্ত্র ব্যবহার করা হয় এবং বই না খুলেই ডিজিটাইজেশন সম্পন্ন করা হয়। অন্যদিকে ধ্বংসাত্মক স্ক্যানিংয়ে বই সরাসরি খুলে ফেলা হয়, এরপর প্রতিটি পৃষ্ঠা দ্রুতগতির শিল্প স্ক্যানারে পাঠানো হয়।
ধ্বংসাত্মক স্ক্যানিং বেশি কার্যকর এবং খরচ কম হওয়ায় AI কোম্পানিগুলো সাধারণত এই পদ্ধতিই বেছে নেয়। এর ফলে শেষ পর্যন্ত লাখ লাখ মুদ্রিত বই ধ্বংস হয়ে যায়।
নিঃসন্দেহে, মুদ্রিত বই AI-এর জন্য জ্ঞানের এক বিশাল ভাণ্ডার। তবে এই পদ্ধতি ক্রমবর্ধমান নৈতিক বিতর্কও তৈরি করছে।
সমালোচকদের মতে, ডিজিটাইজেশনের সময় AI কোম্পানিগুলো সাধারণ বই এবং মূল্যবান বা মুদ্রণ-বহির্ভূত বইয়ের মধ্যে পার্থক্য করে কি না, তা এখনো স্পষ্ট নয়। এসব দুর্লভ বই ধ্বংস হয়ে গেলে সেগুলো চিরতরে circulation-এর বাইরে চলে যেতে পারে।
আরও বড় প্রশ্ন হলো, স্ক্যান করা এসব কনটেন্ট শেষ পর্যন্ত AI কোম্পানিগুলোর নিজস্ব ডেটাবেসে জমা হবে এবং শুধু AI প্রশিক্ষণের কাজে ব্যবহৃত হবে; সাধারণ মানুষ এতে প্রবেশাধিকার পাবে না।
এর অর্থ হলো, মানুষ হয়তো আরও বুদ্ধিমান AI পেতে পারে, কিন্তু এর মূল্য হতে পারে মানবজাতির সঞ্চিত বিপুল জ্ঞানসম্পদ ভবিষ্যৎ প্রজন্মের জন্য আর উন্মুক্ত ও সহজলভ্য রূপে অবশিষ্ট না থাকা।