

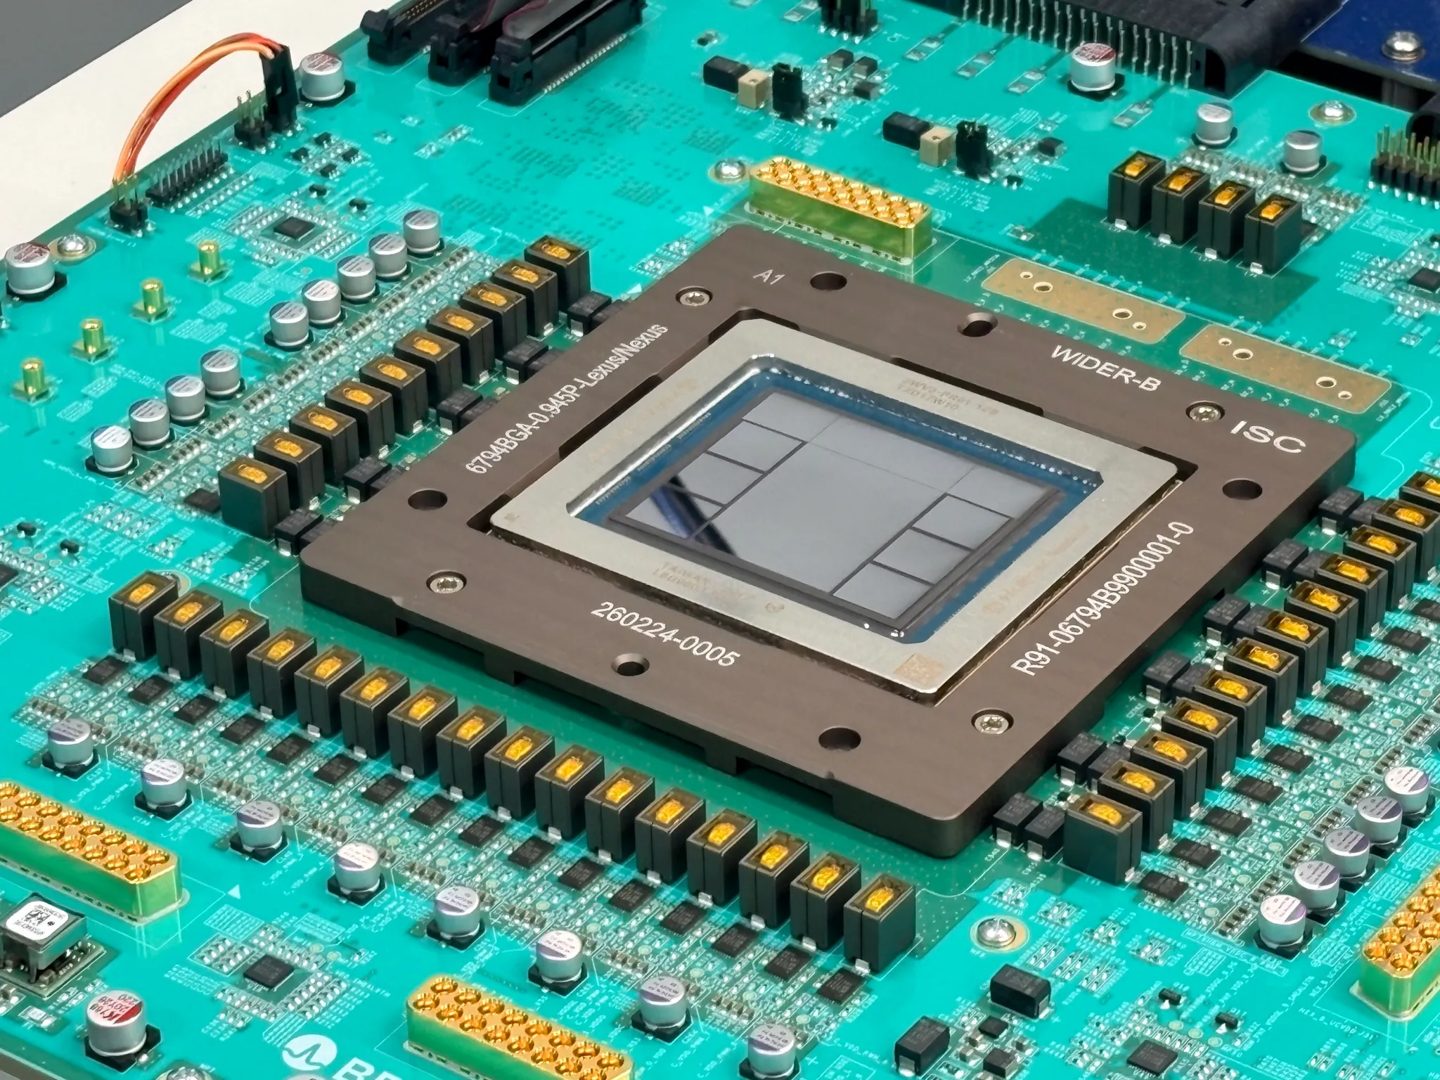
OpenAI আজ (২৫ তারিখ) সন্ধ্যায় Hot Chips সম্মেলনে নতুন ইনফারেন্স সিস্টেম Jalapeño সম্পর্কে আরও বিস্তারিত জানিয়েছে এবং প্রথমবারের মতো বেঞ্চমার্ক পরীক্ষার ফল প্রকাশ করেছে। SemiAnalysis-এর InferenceX পরীক্ষায় Jalapeño একক-ব্যবহারকারীর টোকেন প্রক্রিয়াকরণ এবং প্রতি কিলোওয়াটে থ্রুপুট—উভয় ক্ষেত্রেই—বর্তমানে বাজারের শীর্ষস্থানীয় ইনফারেন্স প্রসেসরগুলোর চেয়ে এগিয়ে রয়েছে।
OpenAI-এর হার্ডওয়্যার বিভাগের প্রধান রিচার্ড হো এক মিডিয়া কনফারেন্স কলে বলেন: “পরীক্ষার ফলাফলের সবচেয়ে গুরুত্বপূর্ণ দিক হলো, বর্তমানে সবচেয়ে উন্নত পণ্যগুলোর তুলনায় Jalapeño অত্যন্ত উল্লেখযোগ্য কর্মক্ষমতা বৃদ্ধি করেছে। একই পরিমাণ বিদ্যুৎ ব্যবহার করে এটি আরও বেশি AI ওয়ার্কলোড প্রক্রিয়া করতে পারে এবং দ্রুততর প্রতিক্রিয়া দিতে পারে। Jalapeño বিপুলসংখ্যক ব্যবহারকারীকে দক্ষতার সঙ্গে সেবা দেওয়ার পাশাপাশি খুব কম লেটেন্সিও বজায় রাখতে পারে।”
Jalapeño OpenAI ও Broadcom যৌথভাবে তৈরি করেছে, এবং OpenAI-এর নিজস্ব মডেলও এর গবেষণা ও উন্নয়নে অংশ নিয়েছে। OpenAI Jalapeño-কে এমন একটি প্রযুক্তি প্ল্যাটফর্মে পরিণত করতে চায়, যা একাধিক প্রজন্ম ধরে ব্যবহার করা যাবে। এর লক্ষ্য হলো AI পণ্য, মডেল, চিপ ও মেমোরিকে শুরু থেকেই সমন্বিতভাবে নকশা করা।
এই চিপটি মূলত AI ইনফারেন্সের জন্য দায়ী। অর্থাৎ, প্রশিক্ষিত AI মডেলকে বাস্তবে চালু করে কাজ সম্পন্ন করা বা AI এজেন্ট পরিচালনা করা।
OpenAI Jalapeño-এর ইনফারেন্স কর্মক্ষমতা পরীক্ষা করতে InferenceX প্ল্যাটফর্ম ব্যবহার করেছে এবং Nvidia GB200 ও GB300 সুপারচিপ সিস্টেমের সঙ্গে তুলনা করেছে। OpenAI জানিয়েছে, GPT-OSS 120B, DeepSeek R1 এবং Kimi K2.5 1T—এই তিনটি মডেলের ক্ষেত্রে প্রতি ওয়াটে Jalapeño যে পরিমাণ AI ওয়ার্কলোড সম্পন্ন করতে পারে, তা তুলনামূলক সিস্টেমগুলোর 1.5 থেকে 1.9 গুণ; অন্যদিকে, এন্ড-টু-এন্ড লেটেন্সি তুলনামূলক সিস্টেমগুলোর প্রায় 28% থেকে 59%।
পূর্ণ-স্ট্যাক সমন্বিত উন্নয়নের ফলে ইনফারেন্স প্রক্রিয়ার গতি কমিয়ে দেওয়ার সম্ভাবনাময় ধাপগুলো OpenAI সরাসরি অপ্টিমাইজ করতে পেরেছে। Jalapeño প্রিফিল ও যোগাযোগ পর্যায়ের লেটেন্সি কমানোর ওপর গুরুত্ব দিয়েছে। OpenAI-এর মতে, এই দুটি ধাপই প্রায়ই ইনফারেন্স কর্মক্ষমতার প্রধান বাধা হয়ে দাঁড়ায়।
পরীক্ষার ফল প্রকাশের ব্লগ পোস্টে OpenAI উল্লেখ করেছে, নকশার শুরু থেকেই Jalapeño ডেটা স্থানান্তর ও যোগাযোগজনিত লেটেন্সি কমানোর চেষ্টা করেছে। প্রতিক্রিয়া তৈরি করার সময় ব্যবহৃত KV ক্যাশের মতো মডেল স্টেটগুলো নির্দিষ্টভাবে স্থানীয়ভাবে সংরক্ষণ ও ধরে রাখা যায়। এরপর সিস্টেম ইনফারেন্সের বিভিন্ন পর্যায় অনুযায়ী উপযুক্ত কম্পিউটিং, মেমোরি ও নেটওয়ার্ক রিসোর্স বরাদ্দ করে।
IT之家-এর জানা অনুযায়ী, OpenAI চলতি বছরের শেষ নাগাদ প্রথমে Jalapeño “ছোট পরিসরে” স্থাপন করার পরিকল্পনা করেছে এবং 2027 সালে ধীরে ধীরে স্থাপনার পরিমাণ বাড়াবে। তবে আগামী বছর ঠিক কতগুলো চিপ স্থাপন করা হবে, তা জানানো হয়নি।
তথ্যসূত্র
OpenAI-এর সরকারি নিবন্ধ: Jalapeño’s first results show industry-leading speed and efficiency in AI inference