

আলি ক্লাউডের “মোদা ModelScope কমিউনিটি”公众号 গতকাল (১২ তারিখ) গভীর রাতে ঘোষণা করেছে যে, আলির Qwen দল আনুষ্ঠানিকভাবে Qwen3.8-2.4T-A95B মডেলের ওজন উন্মুক্ত করেছে।
এটি Qwen-Max স্তরের মডেলের ওজন উন্মুক্ত করার প্রথম ঘটনা। মডেলটির মোট প্যারামিটার 2.4T, প্রতিটি Token-এ 95B প্যারামিটার সক্রিয় হয়, নেটিভভাবে 262,144 Token কনটেক্সট সমর্থন করে এবং তা 1,010,000 Token পর্যন্ত সম্প্রসারণ করা যায়।
Qwen3.8, Qwen3.5-এর হাইব্রিড আর্কিটেকচার অব্যাহত রেখে প্রোগ্রামিং, অফিসের কাজ, গবেষণা এবং দীর্ঘমেয়াদি Agent কাজের এন্ড-টু-এন্ড সম্পন্ন করার সক্ষমতা উন্নত করেছে। অফিসিয়াল ক্লাউড সংস্করণ Qwen3.8-Max এই উন্মুক্ত ওজনের মডেলের ওপর ভিত্তি করে তৈরি এবং এতে উৎপাদন পরিবেশের জন্য আরও সক্ষমতা যুক্ত করা হয়েছে।
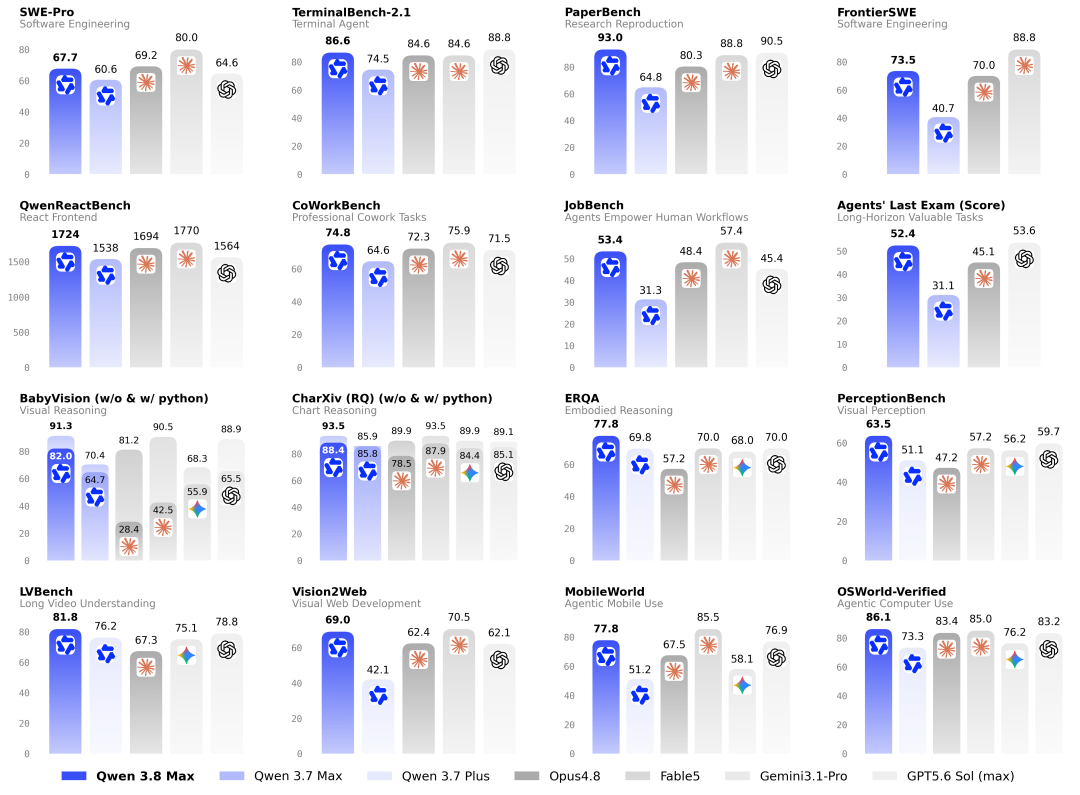
প্রকাশিত মূল্যায়নে কোডিং Agent, সাধারণ Agent, পেশাগত কাজ এবং দীর্ঘ কনটেক্সটসহ বিভিন্ন দিক অন্তর্ভুক্ত রয়েছে। Opus 4.8, Fable 5, GPT 5.6 Sol-এর মতো মডেলের সঙ্গে তুলনায় ফলাফল ক্ষেত্রভেদে ওঠানামা করেছে এবং PaperBench, IFBench-এর মতো Benchmark-এ তালিকাভুক্ত মডেলগুলোর মধ্যে তুলনামূলকভাবে উচ্চ ফল অর্জন করেছে।
উপরের প্রাসঙ্গিক লিংকগুলো নিচে দেওয়া হলো:
মডেল: https://modelscope.cn/models/Qwen/Qwen3.8-2.4T-A95B
blog: https://qwen.ai/blog?id=qwen3.8
Qwen Studio: https://chat.qwen.ai
Qwen3.8-2.4T-A95B একটি causal language model, যার মোট প্যারামিটার 2.4T এবং প্রতিটি Token-এ 95B প্যারামিটার সক্রিয় হয়। মডেলটির প্রতিটি MoE স্তরে 512টি expert রয়েছে; প্রতিটি Token 10টি routing expert নির্বাচন করে এবং একই সঙ্গে 1টি shared expert সক্রিয় করে।
মডেলটিকে একাধিক ধাপের MTP (Multi-Token Prediction) প্রশিক্ষণও দেওয়া হয়েছে, যাতে সংশ্লিষ্ট প্রক্রিয়া সমর্থনকারী inference engine-কে একাধিক পরবর্তী Token পূর্বাভাস দেওয়ার সক্ষমতা প্রদান করা যায়।
পরিচিতি অনুযায়ী, Qwen3.8-Max-এর অফিস ও Agent-সংক্রান্ত পরবর্তী প্রশিক্ষণ তিনটি ধাপে সংক্ষেপিত করা যায়:
বাস্তব পরিবেশ ক্রমাগত সম্প্রসারণ করা এবং এসব স্বাধীন মাত্রায় ডিকাপল করা: কাজ (Task) (একক কাজ → একাধিক কাজ → একাধিক দিনব্যাপী কাজ), ওয়ার্কস্পেস (Workspace) (একাধিক ফাইল → স্তরভিত্তিক ডিরেক্টরি → জটিল ভিন্নধর্মী ডিরেক্টরি), Harness (বিভিন্ন শ্রেণি, সংস্করণ, দক্ষতা)। এর ফলে প্রতিটি পরিবেশের জন্য আলাদা কাস্টম ইন্টিগ্রেশনের ওপর নির্ভর না করে পরিবেশের সংখ্যা সমন্বিত উপায়ে স্বাভাবিকভাবে বাড়তে পারে।
একটি অভিন্ন reward system তৈরি করা, যা বাস্তব কাজের ভিন্নধর্মী যাচাইকরণ পদ্ধতিগুলোকে এর মধ্যে অন্তর্ভুক্ত করবে। এই ব্যবস্থায় execution-ভিত্তিক যাচাই, টেক্সট ও রেন্ডার করা ভিজ্যুয়াল আউটপুটের rubric মূল্যায়ন এবং agentic পরীক্ষা অন্তর্ভুক্ত রয়েছে। বিভিন্ন ফর্ম ও modality-কে একটি reward system-এ একীভূত করে আমরা সব পরিবেশের জন্য সামঞ্জস্যপূর্ণ ও নির্ভরযোগ্য reward signal প্রদান করেছি, ফলে কাজ-নির্দিষ্ট verifier রক্ষণাবেক্ষণের অন্তর্নিহিত অসামঞ্জস্য দূর হয়েছে।
একটি online data balancer তৈরি করা, যা প্রতিটি batch পুনর্গঠন করে Task, difficulty, Workspace এবং Harness-এর বণ্টনকে অত্যন্ত ভারসাম্যপূর্ণ রাখবে। এতে batch-গুলোর মধ্যকার gradient variance কমে এবং reinforcement learning-এর প্রশিক্ষণ গণনাশক্তি স্থিতিশীল ও ধারাবাহিকভাবে সম্প্রসারণ করা সম্ভব হয়।