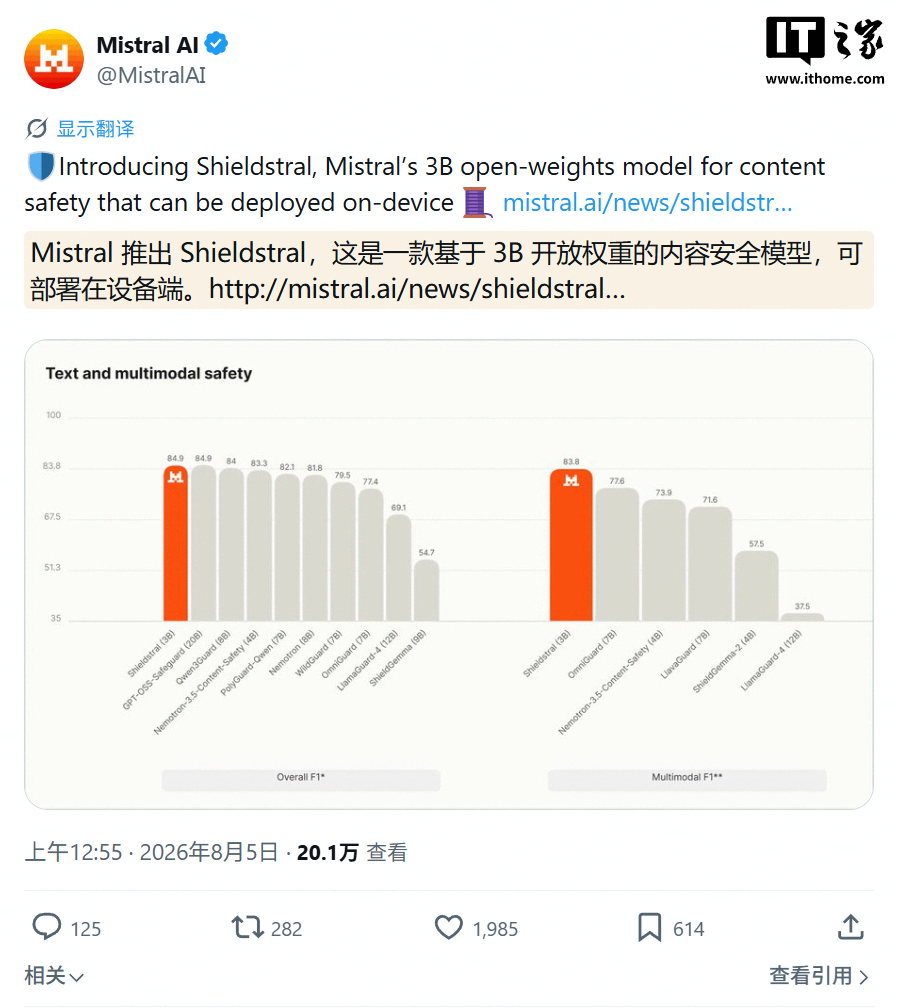
Mistral AI গতকাল (4 আগস্ট) এক ঘোষণায় Shieldstral কনটেন্ট মডারেশন AI মডেল উন্মোচনের কথা জানিয়েছে। মডেলটির মোট প্যারামিটার 3B (3 বিলিয়ন), এটি ওপেন ওয়েট ব্যবহার করে এবং Apache 2.0 লাইসেন্সের অধীনে প্রকাশিত হয়েছে।
মডেলটি Hugging Face প্ল্যাটফর্মে প্রকাশিত হয়েছে, 12টি ভাষা সমর্থন করে এবং একটি 16GB GPU-তে চালানো যায়। Mistral জানিয়েছে, কনটেন্ট নিরাপত্তার ক্ষেত্রে এই মডেলটি 7 গুণ বড় ওপেন মডেলের সমতুল্য কর্মক্ষমতা দেখায় এবং মাল্টিমোডাল কনটেন্ট মডারেশন ক্ষেত্রে SOTA অর্জন করেছে।
নোট: SOTA-এর পূর্ণরূপ state-of-the-art। নির্দিষ্ট কৃত্রিম বুদ্ধিমত্তা কাজ বা বেঞ্চমার্ক পরীক্ষায় সর্বোত্তম ও সবচেয়ে অগ্রসর কর্মক্ষমতা দেখানো মডেল বা অ্যালগরিদমের সমষ্টিকে এটি বোঝায়। প্রযুক্তির অগ্রগতি এবং নতুন গবেষণা প্রকাশের সঙ্গে এর মানদণ্ডও পরিবর্তিত হতে থাকে।
Mistral জানিয়েছে, বেশিরভাগ সুরক্ষা মডেল ক্ষতির শ্রেণিবিন্যাসকে মডেলের ওজনের মধ্যে স্থায়ীভাবে নির্ধারণ করে রাখে। ব্যবহারের ক্ষেত্র পরিবর্তন হলে ডেভেলপারদের সাধারণত মডেলটি পুনরায় প্রশিক্ষণ দিতে হয়।
অন্যদিকে, Shieldstral মডারেশন নীতিকে ইনপুট কনটেন্টে রাখে: অপারেটর একটি “হ্যাঁ বা না” প্রশ্ন লিখে তার সঙ্গে মূল্যায়নের পরিস্থিতি ও কঠোরতার মাত্রা জানাতে পারেন। এরপর মডেলটি একটি মাত্র আউটপুট টোকেন থেকে ক্যালিব্রেট করা নিরাপত্তা স্কোর তৈরি করে।
মডেলটি প্রতিটি মডারেশন কাজকে দ্বিমুখী প্রশ্নোত্তরে রূপান্তর করে। ইনপুটে লেবেলযুক্ত 3টি ফিল্ড থাকে:
<Instruct>: মূল্যায়নের পরিস্থিতি ও কঠোরতার মাত্রা ব্যাখ্যা করে।
<Query>: একটি “হ্যাঁ বা না” প্রশ্ন করে, যেমন “এই কনটেন্ট কি শারীরিক সহিংসতার প্রচার করে?”
<Document>: পর্যালোচনার জন্য কনটেন্ট সরবরাহ করে। এটি প্রম্পট, উত্তর, প্রম্পট ও উত্তরের সমন্বয়, অথবা ঐচ্ছিক টেক্সটসহ একটি ছবি হতে পারে।
ইনফারেন্সের সময় মডেলটি শুধু “হ্যাঁ” এবং “না” এই দুটি টোকেনের লজিক্যাল মান পড়ে, পরে softmax-এর মাধ্যমে সেগুলোকে একটি ধারাবাহিক স্কোরে রূপান্তর করে এবং 0.5-কে সীমামান ধরে দ্বিমুখী সিদ্ধান্ত দেয়। এই পদ্ধতি প্রম্পট শ্রেণিবিন্যাস, উত্তর পর্যালোচনা, প্রত্যাখ্যান শনাক্তকরণ এবং বিষাক্ততা শনাক্তকরণে প্রয়োগ করা যায়।