
- মাসিক ভিজিট
- 0
- মূল্য
- সেট করা হয়নি
- তালিকাভুক্ত
- —
- আপডেট করা হয়েছে
- 2026-10-10
01TalkLikeYou কী
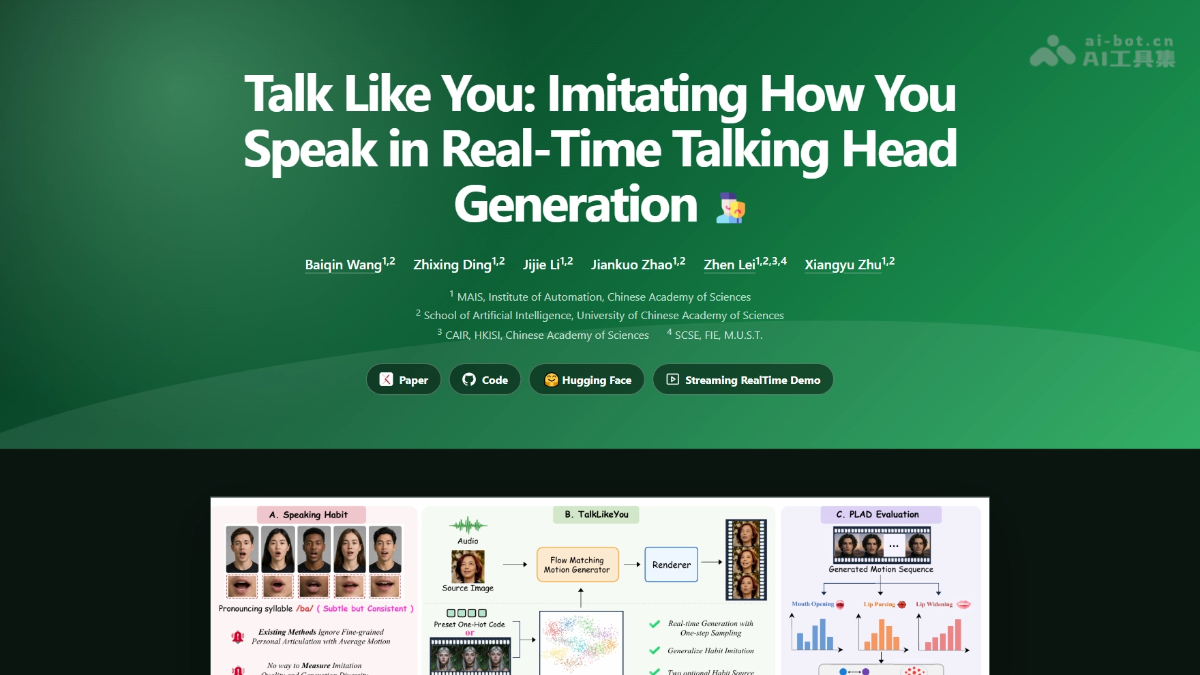
TalkLikeYou হলো চাইনিজ একাডেমি অব সায়েন্সেসের অটোমেশন ইনস্টিটিউটের ওপেন-সোর্স রিয়েল-টাইম ডিজিটাল হিউম্যান ফ্রেমওয়ার্ক। একটি ছবি ও একটি অডিও দিলে ছবির মানুষটিকে কথা বলানো যায়, এবং মুখের নড়াচড়া নির্দিষ্ট ব্যক্তির কথা বলার অভ্যাস অনুকরণ করতে পারে। TalkLikeYou মোশন-স্পেস মডেলিং ও এক-ধাপ স্যাম্পলিংয়ের মাধ্যমে রিয়েল-টাইম জেনারেশন সম্পন্ন করে। এটি প্রিসেট আইডি বা রেফারেন্স ভিডিও ব্যবহার করে অভ্যাস কাস্টমাইজ করতে পারে, অনুকরণের সাদৃশ্য পরিমাপের জন্য বিশেষ সূচক প্রস্তাব করে এবং সম্পূর্ণ কোড ও ওজন ওপেন সোর্স হিসেবে প্রকাশ করে।
02TalkLikeYou-এর প্রধান ফিচার
ছবিকে কথা বলানো: একটি পোর্ট্রেট ছবি ও একটি অডিও আপলোড করলে ব্যক্তিকে কথা বলার ভিডিও তৈরি করা যায়।
অভ্যাস অনুকরণ: নির্দিষ্ট ব্যক্তির মুখের কথা বলার অভ্যাস অনুকরণ করা যায়, যা প্রিসেট আইডি বা 4 সেকেন্ডের রেফারেন্স ভিডিও দিয়ে নির্ধারণ করা যায়।
রিয়েল-টাইম জেনারেশন: এক-ধাপ স্যাম্পলিং প্রযুক্তি ব্যবহার করে 32.43 FPS গতিতে ভিডিও তৈরি করে এবং রিয়েল-টাইম স্ট্রিমিং আউটপুট সমর্থন করে।
ভিডিও ডাবিং: ভিডিওর ব্যক্তির মুখের নড়াচড়া প্রতিস্থাপন করে মূল মাথার নড়াচড়া ও সময়ক্রম বজায় রাখে, তাই বহুভাষিক ডাবিংয়ের জন্য উপযোগী।
কথোপকথনমূলক ডিজিটাল হিউম্যান: বড় ভাষা মডেল ও স্পিচ রিকগনিশন-সিন্থেসিস সিস্টেম যুক্ত করলে রিয়েল-টাইম কথোপকথনমূলক ডিজিটাল অবতার তৈরি করা যায়।
স্টাইলাইজড ড্রাইভিং: স্কেচ, তেলচিত্র, অ্যানিমে, 3D চরিত্রসহ অ-বাস্তবধর্মী শৈলীর পোর্ট্রেট চালানো সমর্থন করে।
03TalkLikeYou-এর প্রযুক্তিগত নীতি
WeChat-এ ফলো করে “开源” লিখে উত্তর দিন, AI ওপেন-সোর্স প্রকল্পের আলোচনা গ্রুপে যোগ দিন
মোশন-স্পেস মডেলিং: সরাসরি পিক্সেল স্পেসে ছবি তৈরি করার বদলে TalkLikeYou প্রথমে ছবিকে মোশন প্যারামিটারে বিশ্লেষণ করে। এরপর এই হালকা সংখ্যাগত উপস্থাপনায় কথা বলার নড়াচড়া শেখে ও তৈরি করে, এবং রেন্ডারার দিয়ে তা আবার ভিডিওতে রূপান্তর করে। এতে গতি ও পরিচয়ের স্থায়িত্ব দুটোই বজায় থাকে।
এক-ধাপ Flow Matching স্যাম্পলিং: Flow Matching ব্যবহার করে নয়েজ থেকে লক্ষ্যে যাওয়ার সরল পথ শেখানো হয়। পুনঃপ্যারামিটারাইজেশনের সাহায্যে পরিষ্কার মোশন সিকোয়েন্স সরাসরি পূর্বানুমান করা হয়। এক-ধাপ স্যাম্পলিং প্রায় 50 ধাপের লিপ-সিঙ্ক গুণমান অর্জন করতে পারে এবং 32.43 FPS রিয়েল-টাইম গতি দেয়।
একীভূত অভ্যাস স্পেস: ইন্টারপোলেশনযোগ্য নিম্ন-মাত্রিক অভ্যাস ভেক্টর স্পেস তৈরি করে, যেখানে ডেটাসেটের মানুষের মুখের নড়াচড়ার পরিসংখ্যান one-hot এনকোডিংয়ে সংকুচিত করা হয়। রেফারেন্স ভিডিও অভ্যাস নিষ্কাশকের মাধ্যমে একই স্পেসে এনকোড হয়। দুটি ইনপুট পদ্ধতি স্বাধীনভাবে বদলানো যায়, এমনকি ইন্টারপোলেশন করে মিশ্রিতও করা যায়।
দুই-পর্যায়ের প্রশিক্ষণ কৌশল: প্রথমে 380 জনের HDTF ডেটাসেটে one-hot এনকোডিং ব্যবহার করে “অভ্যাস কী” শেখানো হয়। পরে বড় CelebV-HQ ডেটাসেটে রেফারেন্স ভিডিও ব্যবহার করে সাধারণীকরণ ক্ষমতা প্রশিক্ষণ দেওয়া হয়। ভুলে যাওয়া রোধে পর্যায়ক্রমে one-hot ডেটা পুনরায় ব্যবহার করা হয়, ফলে অভ্যাসের সাদৃশ্য 0.33 থেকে 0.64-এ উন্নীত হয়।
PLAD মূল্যায়ন সূচক: মুখের নড়াচড়াকে মুখ খোলার মাত্রা, ঠোঁট সঙ্কোচন ও ঠোঁট প্রসারণ—এই তিনটি উচ্চারণ অক্ষে প্রক্ষেপণ করা হয়। এরপর বিতরণ হিস্টোগ্রামের মাধ্যমে রেফারেন্স ব্যক্তির সঙ্গে তুলনা করে সাদৃশ্য গণনা করা হয়। এটি প্রথমবারের মতো “কথা বলার অভ্যাস কতটা একই” বিষয়টির পরিমাণগত মানদণ্ড প্রদান করে।
04TalkLikeYou কীভাবে ব্যবহার করবেন
পরিবেশ প্রস্তুতি: Linux সিস্টেম ব্যবহার করুন, Python 3.10 + CUDA 12.1 + FFmpeg ইনস্টল করুন এবং নিশ্চিত করুন যে NVIDIA GPU-এর VRAM কমপক্ষে 12GB।
কোড ডাউনলোড: GitHub থেকে TalkLikeYou-এর মূল রিপোজিটরি ক্লোন করুন।
নির্ভরতা ইনস্টল: conda env create -f environment.yaml চালিয়ে পরিবেশ তৈরি ও সক্রিয় করুন, অথবা CUDA সংস্করণের PyTorch নিজে ইনস্টল করে pip install -r requirements.txt চালান।
ওজন ডাউনলোড: hf download doubi-killer/TalkLikeYou কমান্ড ব্যবহার করে মডেলের ওজন রিপোজিটরির রুট ডিরেক্টরিতে ডাউনলোড করুন।
উপকরণ প্রস্তুত: একটি পোর্ট্রেট ছবি (অথবা ভিডিও) ও একটি অডিও প্রস্তুত করুন। ইনপুট ভিডিও 25 FPS হতে হবে।
ইনফারেন্স চালান: python -m talklikeyou --source ছবি --audio অডিও --person-id 192 --sampling-steps 1 চালিয়ে ভিডিও তৈরি করুন। --person-id বদলালে কথা বলার অভ্যাসও বদলাবে।
অভ্যাস কাস্টমাইজ: --person-id-এর বদলে --habit-reference ব্যবহার করে অন্তত 100 ফ্রেমের একটি রেফারেন্স ভিডিও নির্দিষ্ট করুন। এতে ওই ভিডিওর ব্যক্তির কথা বলার অভ্যাস অনুকরণ করা যাবে।
ভিডিও ডাবিং: --source-এ ভিডিও ফাইল দিন এবং --pose-mode source যোগ করুন। এতে শুধু মুখের নড়াচড়া বদলাবে, মূল মাথার নড়াচড়া বজায় থাকবে।
05TalkLikeYou-এর মূল সুবিধা
কথা বলার অভ্যাসের নির্দিষ্ট অনুকরণ: ব্যক্তিগত মুখের কথা বলার অভ্যাসকে স্বতন্ত্রভাবে মডেল করা শিল্পক্ষেত্রের প্রথম ওপেন-সোর্স ফ্রেমওয়ার্ক। এটি আইডি বা ভিডিও দিয়ে নির্ধারণ করা যায়, ফলে “সবার জন্য একই” গড় মুখের নড়াচড়া এড়ানো যায়।
দ্রুত রিয়েল-টাইম গতি: এক-ধাপ Flow Matching স্যাম্পলিং 32.43 FPS গতি দেয়, যা ইমেজ ডিফিউশন পদ্ধতির Sonic-এর চেয়ে প্রায় একশ গুণ দ্রুত। একটি RTX 3090-এ VRAM ব্যবহার 4GB-এরও কম।
ছবির মান ও সিঙ্ক্রোনাইজেশন দুটোই উন্নত: FID 7.71, যা দ্বিতীয় স্থানের এক-তৃতীয়াংশেরও কম; Sync-C 8.73, যা পুরো প্রতিযোগিতায় সর্বোচ্চ। ফলে ঠোঁটের সিঙ্ক ও ছবির মান দুটোই বজায় থাকে।
অভ্যাসের সাদৃশ্যে এগিয়ে: PLAD সূচকে অভ্যাসের সাদৃশ্য 0.62, যা MimicTalk (0.48), PC-Talk (0.39) প্রভৃতি প্রতিদ্বন্দ্বীর তুলনায় উল্লেখযোগ্যভাবে বেশি।
দুটি ইনপুট পদ্ধতিতে নমনীয় কাস্টমাইজেশন: অফিসিয়াল প্রিসেট আইডি দিয়ে বিনা খরচে শৈলী বদলানো যায়, যেকোনো রেফারেন্স ভিডিও থেকে তাৎক্ষণিকভাবে শেখানো যায় এবং ইন্টারপোলেশনের মাধ্যমে নতুন অভ্যাস তৈরি করা যায়।
06TalkLikeYou প্রকল্পের ঠিকানা
প্রকল্পের ওয়েবসাইট: https://bq-wang0511.github.io/TalkLikeYou/
GitHub রিপোজিটরি: https://github.com/BQ-Wang0511/TalkLikeYou
HuggingFace মডেল রিপোজিটরি: https://huggingface.co/doubi-killer/TalkLikeYou
arXiv প্রযুক্তিগত গবেষণাপত্র: https://arxiv.org/pdf/2610.06658
07TalkLikeYou-এর প্রয়োগক্ষেত্র
ভার্চুয়াল主播/লাইভ কমার্স: ব্যক্তিগত কথা বলার অভ্যাসসম্পন্ন ভার্চুয়াল主播 কম খরচে তৈরি করা যায়। 4GB VRAM-এ স্থানীয়ভাবে রিয়েল-টাইমে চালানো সম্ভব, তাই প্রকৃত ব্যক্তিকে ক্যামেরার সামনে আসতে হয় না।
বহুভাষিক ভিডিও ডাবিং: ভিডিওর ব্যক্তির মুখের নড়াচড়া প্রতিস্থাপন করে মূল মাথার নড়াচড়া ও সময়ক্রম বজায় রাখা যায়, ফলে অনূদিত চলচ্চিত্র বা বিদেশি বাজারের কনটেন্টে ঠোঁটের নড়াচড়া লক্ষ্য ভাষার সঙ্গে স্বাভাবিকভাবে মিলে যায়।
ডিজিটাল অবতার/ভার্চুয়াল কাস্টমার সার্ভিস: বড় ভাষা মডেল ও স্পিচ সিন্থেসিস যুক্ত করে রিয়েল-টাইম কথোপকথনমূলক অবতার তৈরি করা যায়, যা অনলাইন কাস্টমার সার্ভিস, স্মার্ট গাইডসহ “সামনাসামনি” মিথস্ক্রিয়ার প্রয়োজনীয় ক্ষেত্রে ব্যবহারযোগ্য।
ব্যক্তিগতকৃত শিক্ষা/প্রশিক্ষণ: শিক্ষক বা প্রশিক্ষকের জন্য ব্যক্তিগত ডিজিটাল অবতার তৈরি করে তাঁদের স্বতন্ত্র কথা বলার ধরন পুনর্নির্মাণ করা যায়, যা কোর্স রেকর্ডিং বা দূরশিক্ষণে ব্যবহার করা সম্ভব।
© দাবিত্যাগ: সময়ের সঙ্গে ডোমেইন ও লিংক করা কনটেন্ট পরিবর্তিত হতে পারে। AIEZZ তৃতীয় পক্ষের ওয়েবসাইট নিয়ন্ত্রণ করে না। বাহ্যিক কনটেন্ট ও ঝুঁকি স্বাধীনভাবে পর্যালোচনা করুন।
ব্যবহারকারীর রিভিউ0