
- মাসিক ভিজিট
- 0
- মূল্য
- বিনামূল্যে এবং পে করুন
- তালিকাভুক্ত
- 2026-08-12
- আপডেট করা হয়েছে
- 2026-08-12
01PAST-Bench কী
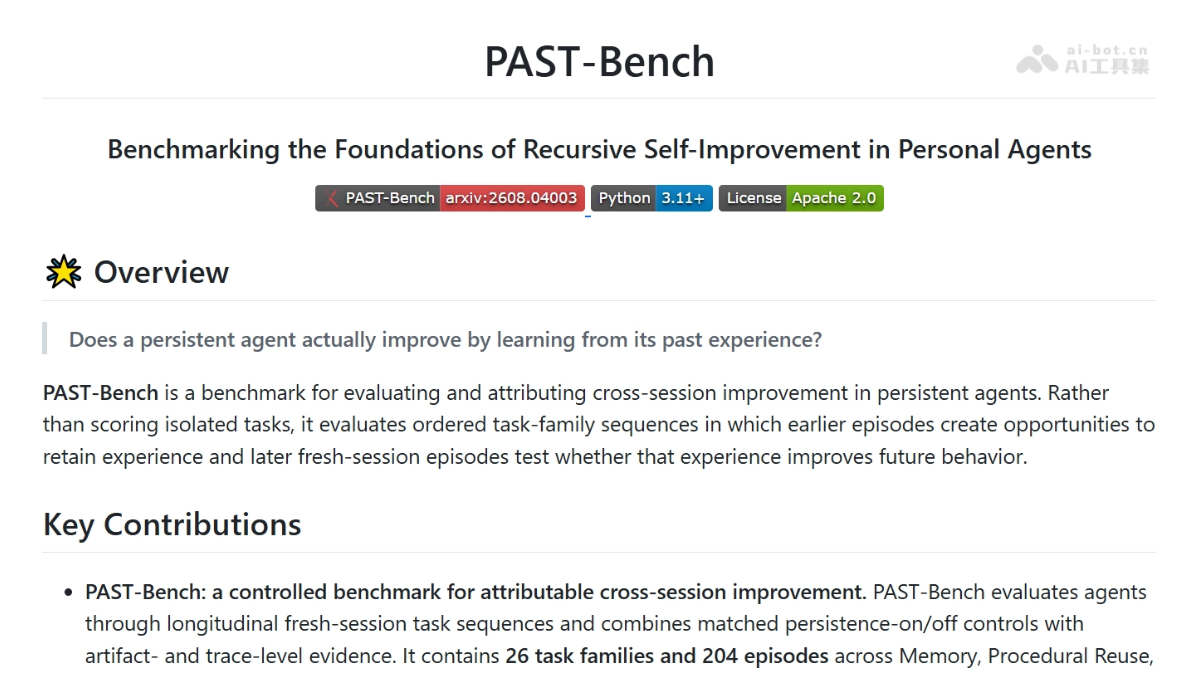
PAST-Bench হলো প্রিন্সটন বিশ্ববিদ্যালয়ের ওয়াং মেংদি দলের তৈরি একটি বেঞ্চমার্ক, যা ব্যক্তিগত AI Agent-এর পুনরাবৃত্তিমূলক স্ব-উন্নয়নের সক্ষমতা যাচাই করতে ব্যবহৃত হয়। PAST-Bench স্মৃতিসহ ও স্মৃতিবিহীন অবস্থায় কাজের পারফরম্যান্স তুলনা করে নির্ধারণ করে, Agent যে আন্তঃসেশন অভিজ্ঞতা সংরক্ষণ করেছে তা পরবর্তী আচরণকে সত্যিই উন্নত করেছে কি না। PAST-Bench স্মৃতি, প্রক্রিয়া পুনর্ব্যবহার, তথ্য সংগ্রহ ও আপডেট, এই চার ধরনের সক্ষমতা অন্তর্ভুক্ত করে; মোট 26টি দৃশ্যপটে 204টি কাজের রাউন্ড রয়েছে।
02PAST-Bench-এর প্রধান功能
পুনরাবৃত্তিমূলক স্ব-উন্নয়ন মূল্যায়ন: ব্যক্তিগত AI Agent সংরক্ষিত আন্তঃসেশন অভিজ্ঞতা (স্মৃতি, দক্ষতা, কাজের ইতিহাস) পরবর্তী আচরণকে সত্যিই উন্নত করেছে কি না তা যাচাই করে।
অভিজ্ঞতা সঞ্চয়ের প্রভাব পৃথকীকরণ: স্কোরের উন্নতি অভিজ্ঞতা সঞ্চয় থেকে এসেছে, নাকি বেস মডেল উন্নত হওয়া, Prompt পরিবর্তন, কাজের জটিলতা ইত্যাদি অন্য কারণে হয়েছে তা আলাদা করে।
চার-মাত্রিক সক্ষমতা নির্ণয়: স্মৃতি, প্রক্রিয়া পুনর্ব্যবহার, তথ্য সংগ্রহ ও স্টেট আপডেট, এই চারটি মাত্রা কভার করে এবং Agent-এর ঠিক কোন ধরনের সক্ষমতায় ঘাটতি আছে তা শনাক্ত করে।
প্রক্রিয়াগত কারণ বিশ্লেষণ: শুধু চূড়ান্ত স্কোর দেখা নয়, বরং “সংরক্ষণ→পুনরুদ্ধার→প্রয়োগ”-এর সম্পূর্ণ পথও অনুসরণ করে, যাতে উন্নতির পেছনে বাস্তব প্রক্রিয়াগত সমর্থন আছে কি না নির্ধারণ করা যায়।
03PAST-Bench-এর প্রযুক্তিগত নীতি
কাজের পরিবারের ক্রম নকশা: Agent একই কাজের পরিবারের একাধিক সেশন ধারাবাহিকভাবে সম্পন্ন করে। প্রাথমিক সেশনগুলো সংরক্ষিত অভিজ্ঞতা তৈরির সুযোগ দেয়, আর পরবর্তী সেশনগুলো যাচাই করে এই অভিজ্ঞতা সঠিকভাবে ব্যবহার করা হয়েছে কি না।
ম্যাচড কন্ট্রোল পরীক্ষা: পরবর্তী প্রতিটি সেশনের জন্য একটি নিয়ন্ত্রণ সংস্করণ তৈরি করা হয়, যেখানে স্থায়ী সংরক্ষণ ক্ষমতা বন্ধ থাকে এবং অন্যান্য সব শর্ত সম্পূর্ণ অভিন্ন থাকে। “স্মৃতিসহ স্কোর – স্মৃতিবিহীন স্কোর” থেকে স্ব-উন্নয়নের পার্থক্য Δ নির্ণয় করা হয়।
প্রক্রিয়াগত প্রমাণ অনুসরণ: রানটাইমে স্মৃতিতে লেখা, দক্ষতা কল, সেশন পুনরুদ্ধার ও স্টেট আপডেটের মতো টেলিমেট্রি ডেটা রেকর্ড করা হয়। এরপর Mechanism-Evidence Score গণনা করে যাচাই করা হয় উন্নতি প্রত্যাশিত পথ অনুসরণ করেছে কি না।
স্থায়ী সংরক্ষিত উপাদান নিরীক্ষা: Agent বাস্তবে যে বিষয়গুলো সংরক্ষণ করেছে (স্মৃতি এন্ট্রি, দক্ষতা ফাইল, সেশন ইনডেক্স) সেগুলো পরীক্ষা করে তাদের গঠন, সময়োপযোগিতা ও পুনর্ব্যবহারযোগ্যতা বিশ্লেষণ করা হয়।
04PAST-Bench কীভাবে ব্যবহার করবেন
পরিবেশ প্রস্তুতি: GitHub থেকে PAST-Bench রিপোজিটরি ক্লোন করে মূল নির্ভরতা ও Agent অ্যাডাপ্টার ইনস্টল করুন।
মডেল কনফিগারেশন: ব্যবহৃত মডেলের API Key পরিবেশ ভেরিয়েবলে কনফিগার করুন।
স্যান্ডবক্স তৈরি: মূল্যায়নের জন্য প্রয়োজনীয় Docker স্যান্ডবক্স ইমেজ তৈরি করতে past-bench build-image --kind sandbox চালান।
দ্রুত যাচাই: একটি কাজের পরিবার চালাতে past-bench evolve ব্যবহার করুন এবং Smoke Test-এর জন্য --compare-no-persistence প্যারামিটার যোগ করুন।
সম্পূর্ণ মূল্যায়ন: সব 26টি কাজের পরিবারে মূল্যায়ন চালান। প্রতিটি কাজের পরিবারে “স্থায়ী সংরক্ষণসহ” ও “স্থায়ী সংরক্ষণবিহীন” দুটি নিয়ন্ত্রণ পরীক্ষা স্বয়ংক্রিয়ভাবে সম্পন্ন হবে।
ফলাফল বিশ্লেষণ: --trace-dir ডিরেক্টরির sequence_comparison.json দেখুন এবং Δ মান ও প্রক্রিয়াগত প্রমাণের স্কোর সংগ্রহ করুন।
কাস্টম ইন্টিগ্রেশন: নিজস্ব Agent মূল্যায়ন করতে agents/ ডিরেক্টরিতে একটি অ্যাডাপ্টার বাস্তবায়ন করুন এবং --compare-no-persistence সুইচ সমর্থন নিশ্চিত করুন।
05PAST-Bench-এর মূল সুবিধা
প্রকৃত কারণ নির্ণয়ের সক্ষমতা: PAST-Bench নির্ভুলভাবে আলাদা করতে পারে উন্নতি অভিজ্ঞতা সঞ্চয় থেকে এসেছে, নাকি মডেল নিজে উন্নত হয়েছে, Prompt পরিবর্তিত হয়েছে বা কাজ সহজ হয়েছে।
ম্যাচড কন্ট্রোল পরীক্ষার নকশা: প্রতিটি কাজের পরিবারের জন্য স্থায়ী সংরক্ষণ বন্ধ থাকা একটি নিয়ন্ত্রণ সংস্করণ রয়েছে। অন্যান্য সব শর্ত সম্পূর্ণ অভিন্ন থাকায় স্মৃতিসহ ও স্মৃতিবিহীন অবস্থার সরাসরি কারণগত তুলনা করা যায়।
প্রক্রিয়া-স্তরের নির্ণয়: Mechanism-Evidence Score প্রস্তাব করে, যা Agent সঠিক উত্তর দিয়েছে কি না তা যাচাই করার পাশাপাশি “সংরক্ষণ→পুনরুদ্ধার→প্রয়োগ”-এর সম্পূর্ণ পথ অনুসরণ করে এবং “কাকতালীয়ভাবে সঠিক উত্তর” ও “সত্যিকার অর্থে অভিজ্ঞতা পুনর্ব্যবহার”-এর পার্থক্য শনাক্ত করে।
চার-মাত্রিক সক্ষমতা বিশ্লেষণ: অস্পষ্ট স্ব-উন্নয়নকে স্মৃতি, প্রক্রিয়া পুনর্ব্যবহার, তথ্য সংগ্রহ ও স্টেট আপডেট, এই চারটি নির্দিষ্ট সক্ষমতায় ভাগ করে দুর্বলতা নির্ভুলভাবে শনাক্ত করে।
নির্ণয়-চালিত উন্নয়ন: বেঞ্চমার্কে প্রকাশিত রানটাইম ত্রুটির ভিত্তিতে সরাসরি Hermes+ ফ্রেমওয়ার্কের জন্ম হয়েছে। এটি প্রমাণ করে যে PAST-Bench শুধু একটি মূল্যায়ন সরঞ্জাম নয়, Agent আর্কিটেকচার উন্নয়নের একটি নির্ণয় ইঞ্জিনও।
06PAST-Bench-এর প্রকল্প ঠিকানা
GitHub রিপোজিটরি:https://github.com/Gen-Verse/PAST-Bench
arXiv প্রযুক্তিগত গবেষণাপত্র:https://arxiv.org/pdf/2608.04003
07PAST-Bench-এর প্রয়োগ ক্ষেত্র
একাডেমিক গবেষণা: Agent-এর পুনরাবৃত্তিমূলক স্ব-উন্নয়নের জন্য মানসম্মত, পুনরুৎপাদনযোগ্য পরিমাণগত মূল্যায়ন পরিবেশ প্রদান করে এবং বিভিন্ন আর্কিটেকচারের বস্তুনিষ্ঠ তুলনা সমর্থন করে।
ফ্রেমওয়ার্ক উন্নয়ন: চার-মাত্রিক সক্ষমতা বিশ্লেষণের মাধ্যমে Agent ফ্রেমওয়ার্কের দুর্বলতা নির্ভুলভাবে শনাক্ত করে এবং আর্কিটেকচার উন্নয়নে নির্দেশনা দেয় (যেমন Hermes+ তৈরি হওয়া)।
মডেল নির্বাচন: নির্দিষ্ট ফ্রেমওয়ার্কের অধীনে বিভিন্ন বেস মডেলের আন্তঃসেশন অভিজ্ঞতা পুনর্ব্যবহারের পারফরম্যান্স তুলনা করে এবং প্রতিটি মডেলের সক্ষমতার প্রবণতা শনাক্ত করে।
স্থায়ী সংরক্ষণ যাচাই: বিভিন্ন স্মৃতি কাঠামো ও পুনরুদ্ধার কৌশলের বাস্তব ফলাফল পরীক্ষা করে, “সংরক্ষণ করা হয়েছে কিন্তু খুঁজে পাওয়া যায় না” বা “সংরক্ষণ করা হয়েছে কিন্তু ব্যবহার হয়নি”-এর মতো অকার্যকর স্থায়ী সংরক্ষণ এড়ায়।
পণ্য পুনরাবৃত্তি: নতুন সংস্করণের স্কোর বৃদ্ধি “আন্তঃসেশন অভিজ্ঞতা সঞ্চয়” থেকে এসেছে, নাকি “বেস মডেল উন্নত হওয়া” থেকে এসেছে তা আলাদা করে, যাতে স্থায়ী সংরক্ষণ ফিচার সত্যিই মূল্য তৈরি করে।
© দাবিত্যাগ: সময়ের সঙ্গে ডোমেইন ও লিংক করা কনটেন্ট পরিবর্তিত হতে পারে। AIEZZ তৃতীয় পক্ষের ওয়েবসাইট নিয়ন্ত্রণ করে না। বাহ্যিক কনটেন্ট ও ঝুঁকি স্বাধীনভাবে পর্যালোচনা করুন।
ব্যবহারকারীর রিভিউ0