
- মাসিক ভিজিট
- 0
- মূল্য
- সেট করা হয়নি
- তালিকাভুক্ত
- —
- আপডেট করা হয়েছে
- 2026-11-10
01Sophon-Realtime v1 কী
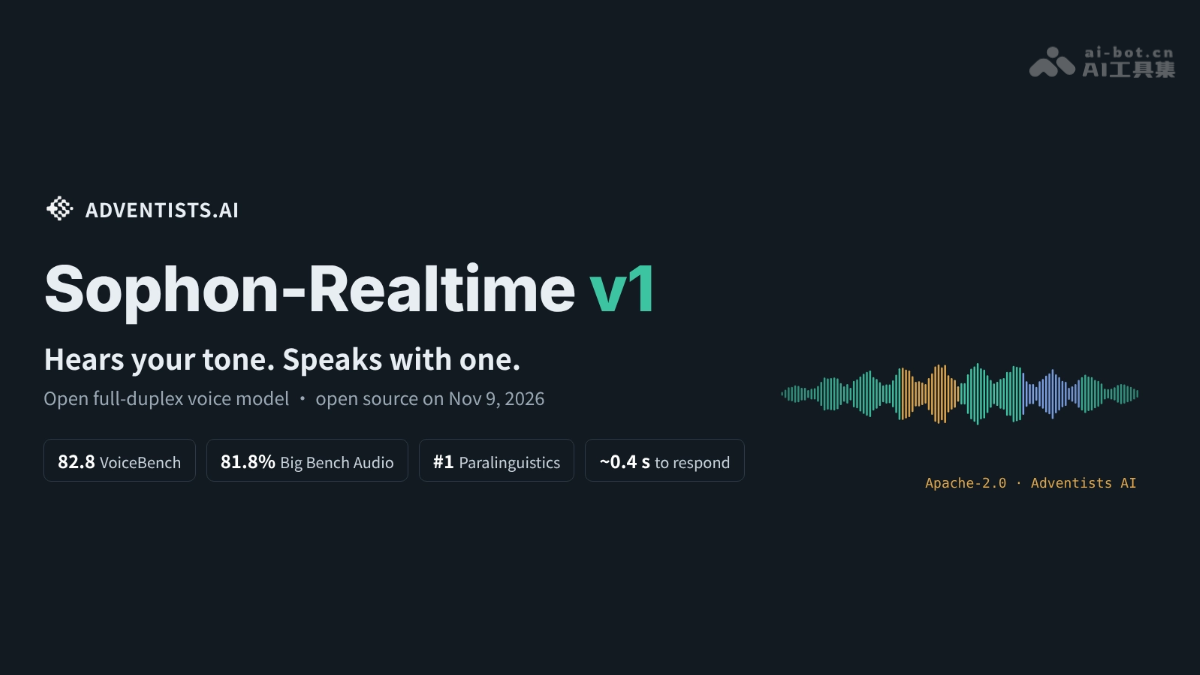
Sophon-Realtime v1 হলো AI降临派 (Adventists AI)-এর ওপেন-সোর্স করা ফুল-ডুপ্লেক্স ভয়েস মডেল। এটি একই সঙ্গে শুনতে শুনতে কথার পালা বুঝতে পারে, যেকোনো সময় বাধা দেওয়া যায়, কণ্ঠের ভঙ্গি, হাসি ও দীর্ঘশ্বাস বুঝতে পারে এবং আবেগপূর্ণ কণ্ঠে উত্তর দেয়। 32B প্যারামিটারের Sophon-Realtime v1 ভয়েস মূল্যায়ন VoiceBench-এ 82.8 স্কোর পেয়েছে, যা ওপেন-সোর্স ফুল-ডুপ্লেক্স মডেলগুলোর মধ্যে প্রথম। Sophon-Realtime v1-এর Tag (অভিব্যক্তিপূর্ণ), Flash (দ্রুত প্রতিক্রিয়া) এবং E2E (গবেষণা প্রিভিউ) এই তিনটি সংস্করণ রয়েছে। একটি 80GB GPU-তেই এটি স্থাপন করা যায় এবং Apache-2.0 লাইসেন্সের অধীনে বাণিজ্যিকভাবে ব্যবহারযোগ্য।
02Sophon-Realtime v1-এর প্রধান ফিচার
ফুল-ডুপ্লেক্স সংলাপ: কথা বলার সময়ও এটি শুনতে থাকে; আপনি থামলেই উত্তর শুরু করে এবং মাঝপথে কথা বললে সঙ্গে সঙ্গে থেমে নতুন প্রশ্নের উত্তর দেয়।
কণ্ঠের ভঙ্গি বোঝা: দ্বিধা, জোর, হাসি, দীর্ঘশ্বাস, ব্যঙ্গসহ বিভিন্ন প্যারালিঙ্গুইস্টিক তথ্য শনাক্ত করতে পারে; শুধু আক্ষরিক বিষয়বস্তু শোনে না।
কণ্ঠের ভঙ্গি প্রকাশ: উত্তরের সময় কণ্ঠে স্বাভাবিকভাবে হাসি, দীর্ঘশ্বাস, গলা পরিষ্কার করা ও শ্বাস নেওয়ার ভঙ্গি প্রকাশ পায়; শুধু লেখা পড়ে শোনায় না।
মাল্টিমোডাল বোঝাপড়া: চার্ট ও স্ক্রিনশট দেখালে সেগুলো বুঝে মৌখিকভাবে ব্যাখ্যা করতে পারে।
টুল কলিং: বহু ধাপের টুল কলিং সমর্থন করে (Full-Duplex-Bench v3 Pass@1 48%), তাই কাজ সম্পন্ন করতে পারে।
Live মোড: OpenAI GPT-Live প্রোটোকলের সঙ্গে সামঞ্জস্যপূর্ণ এবং বড় মডেলের ব্যাকএন্ডের সঙ্গে একত্রে কাজ করতে পারে।
দ্রুত স্থাপন: একটি কমান্ড ও একটি 80GB GPU দিয়েই চালু করা যায়; Flash সংস্করণের প্রথম প্যাকেট পেতে মাত্র 0.31 সেকেন্ড লাগে।
ফাইন-টিউন করা যায়: ms-swift ব্যবহার করে LoRA-এর মাধ্যমে ব্যক্তিত্ব, কথার ধরন, ডোমেইন জ্ঞান ও টুল কলিংয়ের অভ্যাস ফাইন-টিউন করা যায়।
03Sophon-Realtime v1-এর প্রযুক্তিগত নীতি
04Sophon-Realtime v1 কীভাবে ব্যবহার করবেন
পরিবেশ ইনস্টল: সিস্টেমে Linux + CUDA + Python 3.12 নিশ্চিত করে pip install sophon-realtime চালান।
সার্ভিস চালু: sophon-realtime serve চালান। প্রথমবার চালু হলে প্রায় 42GB Tag ওজন স্বয়ংক্রিয়ভাবে ডাউনলোড হবে; এরপর সার্ভিসটি 8000 পোর্টে শুনবে।
ইন্টারফেস কল: ws://HOST:8000/v1/realtime (ফুল-ডুপ্লেক্স) অথবা POST /v1/chat/completions (ভয়েস ইনপুট, লেখা+ভয়েস আউটপুট) ব্যবহার করে মডেলের সঙ্গে যোগাযোগ করুন।
সংলাপ পরীক্ষা: python client_example.py --wav 我的问题.wav --lang zh --voice vivian_zh চালিয়ে একটি ভয়েস বার্তা পাঠান এবং উত্তর শুনুন।
Live মোড সংযুক্তি (ঐচ্ছিক): ইঞ্জিনের পাশে cd sophon-realtime/live && BUILD=tag PORT=8000 LIVE_PORT=8780 bash start_live.sh চালালে OpenAI GPT-Live প্রোটোকলের মাধ্যমে আপনার ব্যাকএন্ডের বড় মডেলের সঙ্গে সংযুক্ত হওয়া যাবে।
ফাইন-টিউন ও কাস্টমাইজ (ঐচ্ছিক): 80GB GPU-তে ms-swift ব্যবহার করে LoRA পদ্ধতিতে প্রশিক্ষণ দিন। jsonl ফরম্যাটের সংলাপ ডেটা প্রস্তুত করুন (অডিও লিখুন, উত্তরে [laughter] ইত্যাদি ট্যাগ যোগ করুন), তারপর swift sft কমান্ড চালিয়ে ব্যক্তিত্ব ও ডোমেইন জ্ঞান পরিবর্তন করুন।
05Sophon-Realtime v1-এর মূল সুবিধা
ওপেন-সোর্স ফুল-ডুপ্লেক্সে শীর্ষস্থানীয়: VoiceBench-এ 82.8 স্কোর, GPT-4o-mini-Audio-এর সমতুল্য এবং MiniCPM-o 4.5 (76.1)-সহ অন্যান্য ওপেন-সোর্স ফুল-ডুপ্লেক্স মডেলকে ছাড়িয়ে গেছে।
ভয়েস রিজনিংয়ে শক্তিশালী: 1,000টি ভয়েস রিজনিং প্রশ্নের Big Bench Audio পরীক্ষায় 81.8% সঠিক উত্তর দিয়েছে, যা আগের সেরা ওপেন-সোর্স মডেল Raon SpeechChat (58%)-এর চেয়ে অনেক বেশি।
কণ্ঠের ভঙ্গি বোঝে: শ্রবণ মডেল DuplexJev LISTEN, StressTest ও MSPB প্যারালিঙ্গুইস্টিক বেঞ্চমার্কে সম্মিলিতভাবে প্রথম (48.6), Gemini 3.8 Flash ও Qwen3-Omni-এর চেয়েও এগিয়ে।
কণ্ঠের ভঙ্গি প্রকাশ করে: NVV-SuperBench-এ Tag সংস্করণের চীনা স্কোর 0.86 এবং ইংরেজি স্কোর 0.80; হাসি, দীর্ঘশ্বাস ও গলা পরিষ্কার করার মতো অভিব্যক্তি সবচেয়ে স্বাভাবিক।
কাজ করতে পারে: Full-Duplex-Bench v3 টুল কলিংয়ে Pass@1 48%, Grok (43%)-এর চেয়ে বেশি; প্রয়োজন হলে 100% ক্ষেত্রে সঠিকভাবে কথায় যোগ দেয়।
দ্রুত ও নির্ভরযোগ্য: Flash সংস্করণের প্রথম প্যাকেট 0.31 সেকেন্ডে আসে এবং একটি GPU-তে 40টি সমান্তরাল সংযোগ সমর্থন করে; Tag সংস্করণে প্রায় 0.6 সেকেন্ড লাগে এবং 16টি সমান্তরাল সংযোগ সমর্থিত।
06Sophon-Realtime v1-এর প্রকল্প ঠিকানা
GitHub রিপোজিটরি: https://github.com/adventists-ai/sophon-realtime
07Sophon-Realtime v1-এর প্রয়োগক্ষেত্র
স্মার্ট কাস্টমার সার্ভিস: Flash সংস্করণের প্রথম প্যাকেট 0.31 সেকেন্ডে আসে এবং একটি GPU-তে 40টি সমান্তরাল সংযোগ চালাতে পারে। এটি গ্রাহকের আবেগ বুঝে বহু ধাপে টুল কল করে কাজ সম্পন্ন করতে পারে, তাই বড় কল সেন্টারের জন্য উপযোগী।
AI সঙ্গী ও ভার্চুয়াল চরিত্র: Tag সংস্করণের কণ্ঠের অভিব্যক্তি সবচেয়ে শক্তিশালী; এটি হাসতে ও দীর্ঘশ্বাস ফেলতে পারে, তাই আবেগগত সঙ্গী, ভার্চুয়াল প্রেমিক বা গেম NPC তৈরিতে উপযোগী।
গাড়ির ভয়েস অ্যাসিস্ট্যান্ট: ফুল-ডুপ্লেক্সে যেকোনো সময় কথা বলা যায় এবং কম বিলম্বে উত্তর পাওয়া যায়; জাগানোর শব্দ ছাড়াই এটি কণ্ঠের ভঙ্গি বুঝে চালকের অবস্থাও বিশ্লেষণে সহায়তা করতে পারে।
AI হার্ডওয়্যার টার্মিনাল: দলের প্রযুক্তি ইতিমধ্যে 300টিরও বেশি হার্ডওয়্যার পণ্যে ব্যবহৃত হয়েছে। Apache-2.0 লাইসেন্সে বাণিজ্যিক ব্যবহারযোগ্য হওয়ায় স্পিকার, খেলনা, রোবটসহ বিভিন্ন ডিভাইসে সংযুক্ত করার জন্য উপযোগী।
এন্টারপ্রাইজ ভয়েস এজেন্ট: Live মোড GPT-Live প্রোটোকলের সঙ্গে সামঞ্জস্যপূর্ণ। Sophon “শোনা ও বলা”র দায়িত্ব নেয়, আর অনুসন্ধান ও কাজ সম্পন্ন করার দায়িত্ব ব্যাকএন্ডের বড় মডেলকে দেয়; ব্যাংক, সরকারি পরিষেবা, বিমান পরিবহনসহ বিভিন্ন শিল্পে কাস্টমাইজড পরিষেবার জন্য উপযোগী।
© দাবিত্যাগ: সময়ের সঙ্গে ডোমেইন ও লিংক করা কনটেন্ট পরিবর্তিত হতে পারে। AIEZZ তৃতীয় পক্ষের ওয়েবসাইট নিয়ন্ত্রণ করে না। বাহ্যিক কনটেন্ট ও ঝুঁকি স্বাধীনভাবে পর্যালোচনা করুন।
ব্যবহারকারীর রিভিউ0