
- মাসিক ভিজিট
- 0
- মূল্য
- বিনামূল্যে এবং পে করুন
- তালিকাভুক্ত
- 2026-08-06
- আপডেট করা হয়েছে
- 2026-08-06
01InstructAV2AV কী
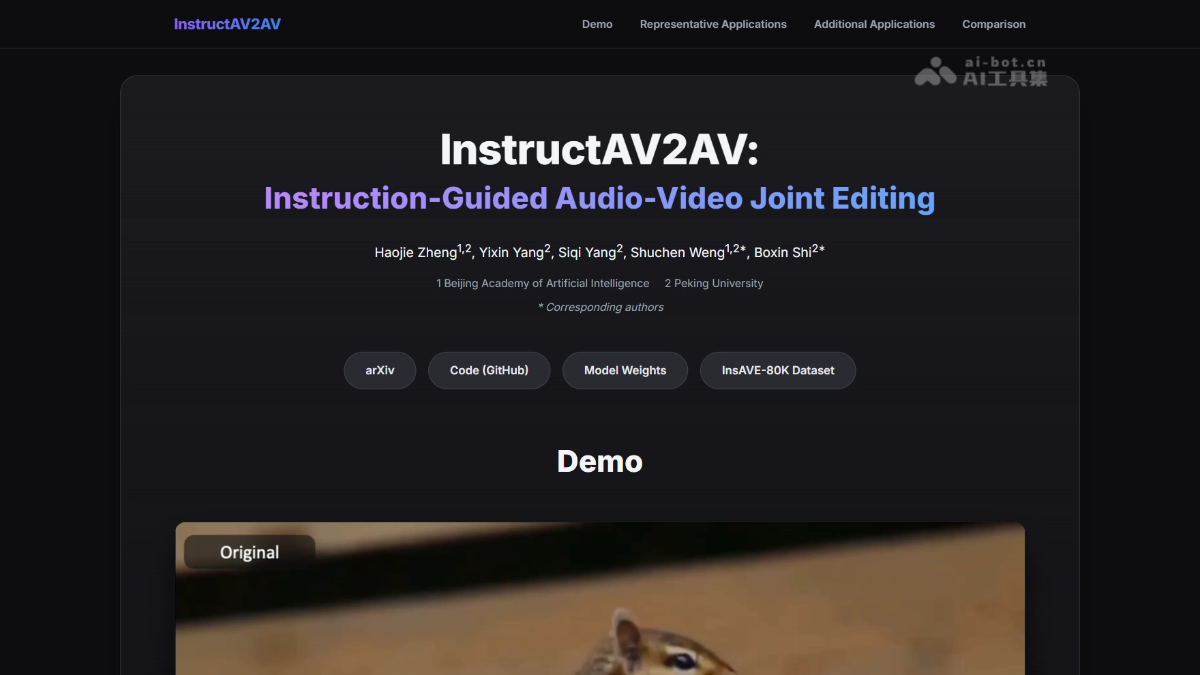
InstructAV2AV হলো বেইজিং ঝিয়ুয়ান কৃত্রিম বুদ্ধিমত্তা গবেষণা ইনস্টিটিউট ও পেকিং বিশ্ববিদ্যালয়ের যৌথভাবে তৈরি অডিও-ভিডিও যৌথ সম্পাদনা মডেল। ব্যবহারকারী শুধু একটি স্বাভাবিক ভাষার নির্দেশ দিয়েই এন্ড-টু-এন্ড প্রজন্ম প্রক্রিয়ায় ভিডিও দৃশ্য ও সংশ্লিষ্ট শব্দ একই সঙ্গে সম্পাদনা করতে পারেন, হাতে তৈরি মাস্ক বা ধাপে ধাপে প্রক্রিয়াকরণের প্রয়োজন হয় না। মডেলটি সংলাপ পরিবর্তন, ব্যক্তি প্রতিস্থাপন, অবজেক্ট সংযোজন ও অপসারণ সমর্থন করে এবং পটভূমি ও পরিবেশের শব্দ অপরিবর্তিত রেখে দৃশ্য ও শব্দের সময়গত সামঞ্জস্য বজায় রাখতে পারে।
02InstructAV2AV-এর প্রধান ফিচার
পরিচয়-সংরক্ষণকারী কণ্ঠস্বর পরিবর্তন: ব্যক্তির চেহারা অপরিবর্তিত রেখে শুধু তার কথার বিষয়বস্তু প্রতিস্থাপন করা।
অডিও-ভিডিও ইনস্ট্যান্স প্রতিস্থাপন: দৃশ্যের নির্দিষ্ট ব্যক্তিকে তার কণ্ঠস্বর ও সংলাপসহ একসঙ্গে পরিবর্তন করা।
ইনস্ট্যান্স সংযোজন: দৃশ্যে নতুন অবজেক্ট যোগ করা এবং তার সঙ্গে সামঞ্জস্যপূর্ণ শব্দ স্বয়ংক্রিয়ভাবে তৈরি করা।
ইনস্ট্যান্স অপসারণ: নির্দিষ্ট অবজেক্ট এবং অডিও ট্র্যাকে থাকা সংশ্লিষ্ট শব্দ অপসারণ করা।
বৈশিষ্ট্যের সমন্বিত সম্পাদনা: ব্যক্তির চেহারা, কথার বিষয়বস্তু ও কণ্ঠস্বরের বৈশিষ্ট্য আলাদাভাবে পরিবর্তন করে স্বাধীনভাবে সমন্বয় করা।
03InstructAV2AV-এর প্রযুক্তিগত নীতি
WeChat-এ ফলো করে “开源” লিখে উত্তর পাঠান, AI ওপেন সোর্স প্রকল্পের আলোচনা গ্রুপে যোগ দিন
উৎস ল্যাটেন্ট ভেরিয়েবল সংযোজন: উৎস ভিডিও ও উৎস অডিওর ল্যাটেন্ট ভেরিয়েবল এবং নয়েজকে চ্যানেল মাত্রা বরাবর সংযুক্ত করা হয়, যাতে উৎস বিষয়বস্তু পুরো ডিনয়জিং প্রক্রিয়ার কাঠামোগত শর্ত হয়ে ওঠে। এর ফলে মডেল পটভূমি, অপ্রাসঙ্গিক অবজেক্ট ও পরিবেশের শব্দ সংরক্ষণ করে এবং “একটি লক্ষ্য পরিবর্তন করতে গিয়ে পুরো পৃথিবী নতুন করে আঁকা” এড়ায়।
SIGA গেটেড অ্যাটেনশন: Source-Instruction Gated Attention প্রতিটি token-কে একই সঙ্গে উৎস বৈশিষ্ট্য ও নির্দেশ বৈশিষ্ট্যের সঙ্গে আন্তঃক্রিয়া করায়। শেখারযোগ্য সফট গেটিং প্রতিটি অবস্থানে কতটা পরিবর্তন ও কতটা সংরক্ষণ করা হবে তা নির্ধারণ করে, ফলে বিষয়বস্তু সংরক্ষণ ও নির্দেশ কার্যকর করার মধ্যে গতিশীল ভারসাম্য বজায় থাকে।
দুই-প্রবাহ আন্তঃক্রিয়া আর্কিটেকচার: Ovi-এর সমমিত দুই-প্রবাহ ডিফিউশন Transformer-এর ওপর ভিত্তি করে ভিডিও ও অডিও শাখা পৃথকভাবে self-attention মডেলিং সম্পন্ন করার পর দ্বিমুখী cross-modal attention-এর মাধ্যমে বৈশিষ্ট্য বিনিময় করে। এর ফলে দৃশ্যগত গতি ও শব্দের ঘটনা পরস্পরকে নিয়ন্ত্রণ করে এবং সামঞ্জস্য বজায় রাখে।
দুই-পর্যায়ের প্রশিক্ষণ: cross-modal attention বন্ধ রেখে পৃথকভাবে একক-মোডাল সম্পাদনা ক্ষমতা প্রশিক্ষণ দেওয়া হয়। পরে পূর্ণ আর্কিটেকচার পুনরায় সক্রিয় করে যৌথ fine-tuning করা হয়, যাতে দৃশ্য ও শব্দের মধ্যে সূক্ষ্ম সামঞ্জস্য শেখা যায়।
স্বয়ংক্রিয় ডেটা পাইপলাইন: উপকরণ বাছাই, সম্পাদনার লক্ষ্য সংশ্লেষণ এবং পাঁচ-মাত্রিক স্বয়ংক্রিয় মূল্যায়ন ও মানব পর্যালোচনার তিনটি ধাপের মাধ্যমে InsAVE-80K ডেটাসেট তৈরি করা হয়েছে, যা জোড়া প্রশিক্ষণ ডেটার ঘাটতি সমাধান করে।
04InstructAV2AV কীভাবে ব্যবহার করবেন
কোড ক্লোন করুন: GitHub থেকে InstructAV2AV কোড রিপোজিটরি স্থানীয় কম্পিউটারে ক্লোন করুন।
পরিবেশ কনফিগার করুন: রিপোজিটরির নির্দেশনা অনুযায়ী Python পরিবেশ কনফিগার করে প্রয়োজনীয় নির্ভরতা ইনস্টল করুন।
ওজন ডাউনলোড করুন: Hugging Face থেকে InstructAV2AV মডেলের ওজন ডাউনলোড করুন।
উপকরণ প্রস্তুত করুন: ইনপুট হিসেবে শব্দসহ একটি ভিডিও উপকরণ প্রস্তুত করুন।
নির্দেশ দিন: যে বিষয় পরিবর্তন করতে চান তা বর্ণনা করে একটি স্বাভাবিক ভাষার সম্পাদনা নির্দেশ দিন।
ইনফারেন্স চালান: ইনফারেন্স স্ক্রিপ্ট চালিয়ে মডেলের সম্পাদিত ভিডিও ও অডিও তৈরি হওয়ার জন্য অপেক্ষা করুন।
ফলাফল সংরক্ষণ করুন: আউটপুট ফলাফল দেখুন এবং সম্পাদিত অডিও-ভিডিও ফাইল সংরক্ষণ করুন।
05InstructAV2AV-এর প্রকল্পের ঠিকানা
প্রকল্পের ওয়েবসাইট: https://hjzheng.net/projects/InstructAV2AV/
GitHub রিপোজিটরি: https://github.com/suimuc/InstructAV2AV
HuggingFace মডেল রিপোজিটরি: https://huggingface.co/suimu/InstructAV2AV
arXiv প্রযুক্তিগত গবেষণাপত্র: https://arxiv.org/pdf/2605.18467
06InstructAV2AV-এর প্রয়োগক্ষেত্র
চলচ্চিত্রের পোস্ট-প্রোডাকশন: চলচ্চিত্রের পোস্ট-প্রোডাকশন কর্মীরা এটি ব্যবহার করে অভিনেতাদের সংলাপ পরিবর্তন ও ঠোঁটের নড়াচড়ার সঙ্গে সামঞ্জস্য করতে পারেন, ফলে পুনরায় শুটিংয়ের খরচ কমে।
স্বল্পদৈর্ঘ্য ভিডিও তৈরি: স্বল্পদৈর্ঘ্য ভিডিও নির্মাতারা একটি বাক্যের নির্দেশে উপকরণের ব্যক্তি ও শব্দ পরিবর্তন করে সৃষ্টির দক্ষতা বাড়াতে পারেন।
ভার্চুয়াল মানব: ভার্চুয়াল মানব পরিচালনা দল ডিজিটাল মানুষের চেহারা, কণ্ঠস্বরের বৈশিষ্ট্য ও কথার বিষয়বস্তু সামঞ্জস্য করতে এটি ব্যবহার করতে পারে।
বিজ্ঞাপনের সৃজনশীলতা: বিজ্ঞাপন পেশাজীবীরা বিভিন্ন ব্যক্তি ও সংলাপের সংস্করণসহ প্রচারমূলক ভিডিও ব্যাপকভাবে তৈরি করতে এটি ব্যবহার করতে পারেন।
ইন্টার্যাকটিভ কনটেন্ট উৎপাদন: গেম ও শিক্ষা ক্ষেত্রের কর্মীরা দৃশ্য ও শব্দে সামঞ্জস্যপূর্ণ মাল্টিমিডিয়া উপকরণ গতিশীলভাবে তৈরি করতে এটি ব্যবহার করতে পারেন।
© দাবিত্যাগ: সময়ের সঙ্গে ডোমেইন ও লিংক করা কনটেন্ট পরিবর্তিত হতে পারে। AIEZZ তৃতীয় পক্ষের ওয়েবসাইট নিয়ন্ত্রণ করে না। বাহ্যিক কনটেন্ট ও ঝুঁকি স্বাধীনভাবে পর্যালোচনা করুন।
ব্যবহারকারীর রিভিউ0