
- মাসিক ভিজিট
- 0
- মূল্য
- বিনামূল্যে এবং পে করুন
- তালিকাভুক্ত
- 2026-08-13
- আপডেট করা হয়েছে
- 2026-08-13
01dots.tts কী
dots.tts হলো Xiaohongshu-এর dots টিম ও Shanghai Jiao Tong University-এর X-LANCE Laboratory-এর যৌথভাবে উন্মুক্ত করা ২ বিলিয়ন প্যারামিটারের সম্পূর্ণ-ধারাবাহিক অটোরিগ্রেসিভ স্পিচ সিন্থেসিস বেস মডেল। মডেলটি সরাসরি ধারাবাহিক ল্যাটেন্ট স্পেসে ধাপে ধাপে 48kHz অডিও তৈরি করে এবং Seed-TTS-Eval-সহ বিভিন্ন বেঞ্চমার্কে কণ্ঠসাদৃশ্য ও বিষয়বস্তুর নির্ভুলতায় SOTA ফলাফল অর্জন করেছে। এটি zero-shot cloning, স্ট্রিমিং আউটপুট এবং কম-বিলম্বের ডুপ্লেক্স কথোপকথন সমর্থন করে। প্রকল্পটির সম্পূর্ণ সোর্স কোড ও মডেল ওজন উন্মুক্ত করা হয়েছে এবং dots.tts.edit-এর মাধ্যমে নির্ভুল ভয়েস এডিটিং সুবিধাও যুক্ত করা হয়েছে।
02dots.tts-এর প্রধান সুবিধা
Zero-shot কণ্ঠ ক্লোনিং: মাত্র 3–10 সেকেন্ডের রেফারেন্স অডিও দিয়ে একই কণ্ঠে যেকোনো নতুন লেখা পড়ানো যায়। এটি আন্তঃভাষিক ক্লোনিং সমর্থন করে এবং Seed-TTS-Eval বেঞ্চমার্কে বিষয়বস্তুর নির্ভুলতা ও বক্তার সাদৃশ্যে SOTA ফলাফল অর্জন করেছে।
টেক্সট-টু-স্পিচ সংশ্লেষণ: এলোমেলো কণ্ঠ নির্বাচন থেকে নির্দিষ্ট বক্তার উচ্চমানের ভয়েস জেনারেশন পর্যন্ত সুবিধা দেয়। 2B প্যারামিটারের ধারাবাহিক অটোরিগ্রেসিভ মডেলের ভিত্তিতে সরাসরি 48 kHz অডিও আউটপুট দেয়।
স্ট্রিমিং জেনারেশন ও কম-বিলম্বের ইন্টারঅ্যাকশন: স্বাভাবিকভাবেই স্ট্রিমিং আউটপুট সমর্থন করে; টেক্সট প্রিফিক্স ইনপুট দেওয়ার পর অডিও ধাপে ধাপে তৈরি হয়। 1T1A ডুয়াল-স্ট্রিম মোডে, আপস্ট্রিম LLM প্রতিটি টেক্সট Token আউটপুট দেওয়ার সঙ্গে সঙ্গে ভয়েস সাড়া দেয়। অডিওর প্রথম প্যাকেটের বিলম্ব 54.4 মিলিসেকেন্ড পর্যন্ত কম হতে পারে, যা রিয়েল-টাইম ভয়েস Agent ও ডুপ্লেক্স কথোপকথনের জন্য উপযোগী।
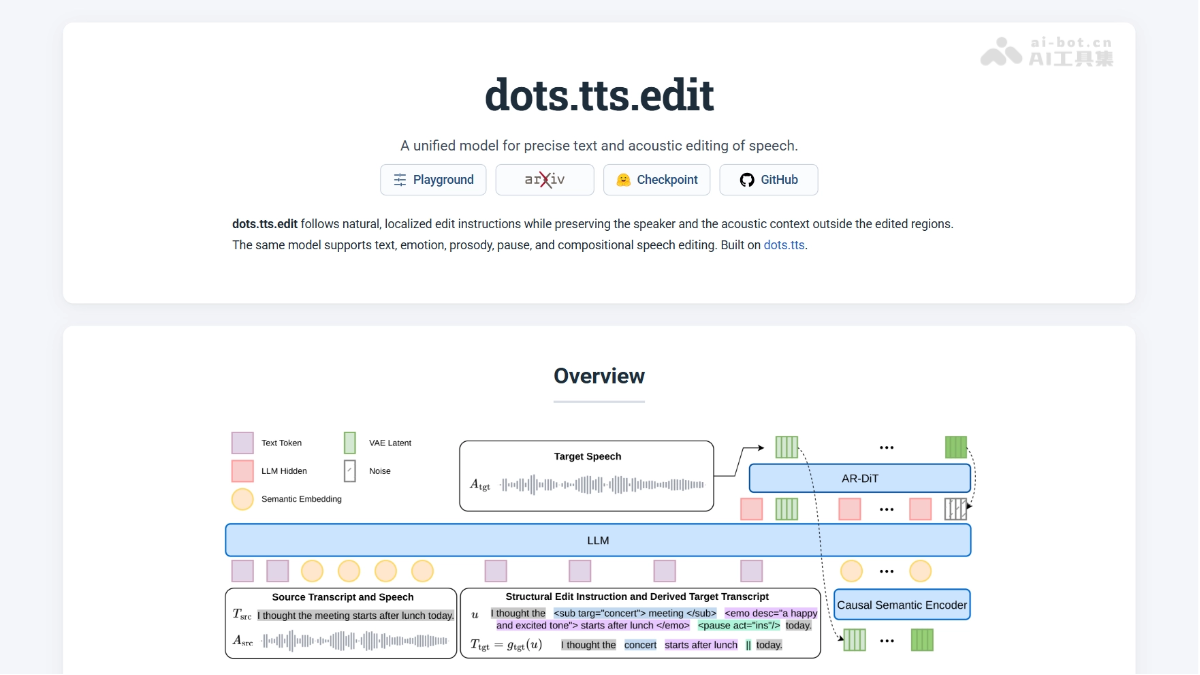
নির্ভুল ভয়েস এডিটিং: বিদ্যমান রেকর্ডিংয়ে টেক্সট প্রতিস্থাপন, আবেগ নিয়ন্ত্রণ, পিচ ও গতি পরিবর্তন, বিরতি যোগ বা মুছে ফেলা যায়। এক নির্দেশনায় একাধিক অপারেশন একসঙ্গে সম্পন্ন করা যায় এবং অপরিবর্তিত অংশ আগের মতো থাকে।
বহুভাষা সমর্থন: 24টি ভাষা সমর্থন করে। MiniMax বহুভাষিক মূল্যায়নে গড় বক্তা-সাদৃশ্য 83.9 অর্জন করেছে, যার মধ্যে 19টি ভাষায় এককভাবে প্রথম স্থান পেয়েছে।
বিভিন্ন ইনফারেন্স গতি: Base, SOAR, MeanFlow (4 ধাপ), দুই-ধাপের sCM এবং এক-ধাপের DMD-সহ একাধিক checkpoint রয়েছে। ব্যবহারকারীরা প্রয়োজন অনুযায়ী অডিওর মান ও ইনফারেন্স গতির মধ্যে নির্বাচন করতে পারেন।
03dots.tts-এর প্রযুক্তিগত নীতি
WeChat-এ ফলো করে “开源” লিখে রিপ্লাই দিন এবং AI ওপেন-সোর্স প্রকল্পের গ্রুপে যোগ দিন
সম্পূর্ণ-ধারাবাহিক অটোরিগ্রেসিভ আর্কিটেকচার: dots.tts প্রচলিত পদ্ধতিতে স্পিচকে বিচ্ছিন্ন Token-এ quantize করার প্রক্রিয়া বাদ দেয়। পুরো জেনারেশন চেইন ধারাবাহিক ল্যাটেন্ট স্পেসে পরিচালিত হয়। মডেলটি অটোরিগ্রেসিভ পদ্ধতিতে ধাপে ধাপে অ্যাকোস্টিক অংশ পূর্বানুমান করে এবং BigVGAN-ধাঁচের ডিকোডারের মাধ্যমে 48 kHz waveform-এ রূপান্তর করে। ফলে বিচ্ছিন্ন quantization-এর কারণে তৈরি তথ্যের bottleneck ও কণ্ঠের সূক্ষ্ম বৈশিষ্ট্য হারানোর সমস্যা মৌলিকভাবে এড়ানো যায়।
সেমান্টিক ধারাবাহিক উপস্থাপন: HoliTok-ভিত্তিক নকশার AudioVAE ব্যবহার করে মডেলটি মূল waveform-কে 25 FPS ধারাবাহিক latent variable-এ সংকুচিত করে। Encoder-এর সেমান্টিক প্রশিক্ষণ reconstruction fidelity ও ল্যাটেন্ট স্পেসের কাঠামোবদ্ধতার মধ্যে ভারসাম্য তৈরি করে। এর ফলে পুনর্গঠিত বক্তা-সাদৃশ্য 0.969-এ পৌঁছায় এবং পরবর্তী অটোরিগ্রেসিভ জেনারেশনের জন্য সমৃদ্ধ কণ্ঠ ও অ্যাকোস্টিক বৈশিষ্ট্য সংরক্ষিত থাকে।
ত্রুটি নিয়ন্ত্রণ ব্যবস্থা: ধারাবাহিক অটোরিগ্রেসিভ জেনারেশনে আগের ধাপের সামান্য বিচ্যুতি পরবর্তী ধাপগুলোতে জমে ছড়িয়ে পড়তে পারে। এই সমস্যা মোকাবিলায় dots.tts একটি causal semantic encoder ব্যবহার করে, যা তৈরি হওয়া VAE patch-কে রিয়েল-টাইমে সংক্ষিপ্ত সেমান্টিক ইতিহাসে সংকুচিত করে এবং তা বড় ভাষা মডেলে ফেরত দেয়। উচ্চ-ভ্যারিয়েন্সের স্থানীয় অ্যাকোস্টিক পরিবর্তন বাদ দিয়ে শুধু দীর্ঘমেয়াদি সেমান্টিক সারাংশ সংরক্ষণ করার মাধ্যমে দীর্ঘ সিকোয়েন্সে ত্রুটি ছড়িয়ে পড়া, শিসের মতো শব্দ ও কণ্ঠের drift কার্যকরভাবে কমানো হয়।
জেনারেশন প্রক্রিয়া: জেনারেশন প্রক্রিয়ার কেন্দ্রে রয়েছে বড় ভাষা মডেল, যা Qwen2.5-1.5B দিয়ে initialize করা হয়েছে। এটি সরাসরি BPE টেক্সট Token গ্রহণ করে এবং প্রতিটি ধাপে hidden state আউটপুট দেয়। এরপর অটোরিগ্রেসিভ flow-matching head (18-স্তরের DiT) LLM hidden state ও অটোরিগ্রেসিভ prefix-এর শর্তে পরবর্তী অ্যাকোস্টিক patch-এর denoising generation সম্পন্ন করে। একই সময়ে frozen CAM++ speaker encoder থেকে পাওয়া global x-vector কণ্ঠের সামঞ্জস্য নিশ্চিত করে।
পোস্ট-ট্রেনিং ত্বরান্বিতকরণ: SOAR self-correction alignment-এর মাধ্যমে দলটি প্রশিক্ষণের সময় বাস্তব ইনফারেন্সে তৈরি বিচ্যুত অবস্থার অনুকরণ করিয়ে মডেলকে স্বয়ংক্রিয় সংশোধন শেখায়। এতে reward model ছাড়াই স্থিতিশীলতা বাড়ে। MeanFlow distillation-এর মাধ্যমে শিক্ষক মডেলের বহু-ধাপের trajectory-কে average velocity-তে সংকুচিত করে 4 ধাপে উচ্চমানের জেনারেশন সম্ভব করা হয়। Simplified consistency model (sCM) ব্যবহার করে এটি 2 ধাপে সংকুচিত করা যায়। Reward-aware distribution matching distillation (DMD) ও dual-timescale update strategy-এর মাধ্যমে স্বাভাবিক ও স্পষ্ট উচ্চমানের এক-ধাপের মডেল তৈরি করা হয়।
04dots.tts কীভাবে ব্যবহার করবেন
ইনস্টলেশন: pip install dots.tts চালালেই ইনস্টল হয়ে যাবে। অথবা GitHub থেকে সোর্স কোড clone করে pip install -e . চালিয়ে local development installation করা যায়। উচ্চ concurrency-এর ক্ষেত্রে CUDA Graph acceleration ও continuous batching সমর্থনের জন্য অতিরিক্তভাবে SGLang Omni deploy করা যেতে পারে।
কমান্ড-লাইন সংশ্লেষণ: dots.tts entry point ব্যবহার করে --model-name-or-path, --text এবং লক্ষ্য --prompt-audio ও --prompt-text নির্দিষ্ট করলে zero-shot কণ্ঠ ক্লোনিং করা যায়। --prompt-text বাদ দিলে x-vector cloning-এ রূপান্তরিত হয়, আর --prompt-audio বাদ দিলে এলোমেলো কণ্ঠ sampling করা হয়।
কমান্ড-লাইন এডিটিং: dots.tts.edit entry point ব্যবহার করে --source-audio এবং XML-ধাঁচের --instruction দিলে বিদ্যমান রেকর্ডিংয়ে টেক্সট প্রতিস্থাপন, আবেগ বা prosody পরিবর্তনসহ নির্ভুল সম্পাদনা করা যায়।
Python API-এর মৌলিক ব্যবহার: DotsTtsRuntime.from_pretrained() দিয়ে মডেল লোড করার পর generate() কল করুন। এতে টেক্সট ও ঐচ্ছিক রেফারেন্স অডিও পাঠালে সংশ্লেষিত অডিও tensor পাওয়া যাবে এবং ফাইলে সংরক্ষণ করা যাবে।
Python API স্ট্রিমিং আউটপুট: generate_stream() কল করলে অডিও tensor ধাপে ধাপে পাওয়া যায়। এটি রিয়েল-টাইমে player বা WebSocket-এ পাঠিয়ে তৈরি হওয়ার সঙ্গে সঙ্গে প্লে করা যায়।
Python API ডুয়াল-স্ট্রিম কথোপকথন: DotsTtsRuntimeDoubleStreaming দিয়ে session চালু করে Token অনুযায়ী টেক্সট পাঠালে ভয়েস সঙ্গে সঙ্গে তৈরি হতে শুরু করে। অডিওর প্রথম প্যাকেটের বিলম্ব 54.4 মিলিসেকেন্ড পর্যন্ত কম হতে পারে, যা রিয়েল-টাইম ভয়েস Agent-এর জন্য উপযোগী।
Fine-tuning: accelerate launch scripts/train_dots_tts.py চালিয়ে নিজস্ব ডেটা path কনফিগার করলে public checkpoint-এর ভিত্তিতে কণ্ঠ বা domain adaptation fine-tuning করা যায়।
Distillation acceleration: scripts/train_dots_tts_meanflow.py ব্যবহার করে SOAR checkpoint-কে শিক্ষক মডেল হিসেবে MeanFlow distillation চালালে 4-ধাপ, 2-ধাপ বা 1-ধাপের উচ্চমানের student model পাওয়া যায়। বিভিন্ন latency ও concurrency প্রয়োজনের সঙ্গে মানিয়ে নিতে এগুলো ব্যবহার করা যায়।
Web interface: python apps/gradio/app.py চালিয়ে visual synthesis interface শুরু করুন। অথবা apps/edit_playground/app.py চালিয়ে Edit Playground শুরু করুন, যেখানে browser-এ অডিও upload, edit range চিহ্নিত এবং ফলাফল real-time preview করা যায়।
05dots.tts-এর মূল সুবিধা
সম্পূর্ণ-ধারাবাহিক ল্যাটেন্ট স্পেস মডেলিং: বিচ্ছিন্ন অ্যাকোস্টিক Token বাদ দিয়ে সরাসরি ধারাবাহিক ল্যাটেন্ট স্পেসে অটোরিগ্রেসিভ জেনারেশন করা হয়। এতে spectrum-এর texture, breathiness-সহ সমৃদ্ধ কণ্ঠের সূক্ষ্ম বৈশিষ্ট্য সংরক্ষিত থাকে এবং reconstruction speaker similarity 0.969 পর্যন্ত পৌঁছায়।
SOTA সংশ্লেষণ মান: Seed-TTS-Eval বেঞ্চমার্কে বিষয়বস্তুর নির্ভুলতা ও কণ্ঠসাদৃশ্য উভয় ক্ষেত্রেই SOTA ফলাফল অর্জন করেছে। 24টি ভাষার MiniMax মূল্যায়নে গড় SIM 83.9 এবং সামগ্রিক কর্মক্ষমতা প্রচলিত সমাধানকে ছাড়িয়ে গেছে।
নেটিভ স্ট্রিমিং ও কম latency: 1T1A ডুয়াল-স্ট্রিম মোডে অডিওর প্রথম প্যাকেট 54.4 মিলিসেকেন্ডের মধ্যে পাওয়া যায়। SGLang Omni-সহ একক H100 GPU-তে 16টি concurrent stream-এ throughput 4.76 req/s, যা রিয়েল-টাইম ভয়েস Agent-এর চাহিদা পূরণ করে।
একীভূত এডিটিং সুবিধা: একই base model-এর ওপর তৈরি dots.tts.edit XML-ভিত্তিক structured instruction ব্যবহার করে টেক্সট, আবেগ, prosody ও বিরতি নির্ভুলভাবে সম্পাদনা করতে পারে। doteBench মূল্যায়নে এটি অন্যান্য open-source system-এর তুলনায় সামগ্রিকভাবে এগিয়ে।
06dots.tts-এর প্রকল্পের ঠিকানা
GitHub repository: https://github.com/studio-dots-ai/dots.tts
arXiv প্রযুক্তিগত গবেষণাপত্র: https://arxiv.org/pdf/2608.02673
07dots.tts-এর প্রয়োগের ক্ষেত্র
রিয়েল-টাইম ভয়েস Agent: 1T1A ডুয়াল-স্ট্রিম মোডে প্রথম প্যাকেটের latency 54.4 মিলিসেকেন্ড পর্যন্ত কম। এটি LLM-চালিত রিয়েল-টাইম ডুপ্লেক্স কথোপকথন ও ভয়েস assistant-এর জন্য উপযোগী।
Zero-shot কণ্ঠ ক্লোনিং: কয়েক সেকেন্ডের reference audio দিয়েই যেকোনো কণ্ঠ পুনর্নির্মাণ করা যায়। আন্তঃভাষিক cloning সমর্থিত, তাই audiobook, dubbing ও personalized content creation-এ ব্যবহারযোগ্য।
বহুভাষিক কনটেন্ট জেনারেশন: 24টি ভাষা সমর্থন করে এবং উচ্চ speaker similarity বজায় রাখে। বৈশ্বিক পণ্যের বহুভাষিক voice broadcast ও localization service-এর জন্য উপযোগী।
নির্ভুল ভয়েস এডিটিং: dots.tts.edit ব্যবহার করে বিদ্যমান recording-এ টেক্সট প্রতিস্থাপন, আবেগ নিয়ন্ত্রণ, prosody পরিবর্তন ও বিরতি সমন্বয় করা যায়। podcast post-production ও audio content refinement-এ এটি উপযোগী।
লাইভস্ট্রিম ও রিয়েল-টাইম সম্প্রচার: LLM-এর streaming output-এর সঙ্গে ব্যবহার করলে তৈরি হওয়ার সঙ্গে সঙ্গে playback করা যায়। সংবাদ সম্প্রচার, live commerce এবং রিয়েল-টাইম তথ্য প্রচারের ক্ষেত্রে এটি ব্যবহারযোগ্য।
© দাবিত্যাগ: সময়ের সঙ্গে ডোমেইন ও লিংক করা কনটেন্ট পরিবর্তিত হতে পারে। AIEZZ তৃতীয় পক্ষের ওয়েবসাইট নিয়ন্ত্রণ করে না। বাহ্যিক কনটেন্ট ও ঝুঁকি স্বাধীনভাবে পর্যালোচনা করুন।
ব্যবহারকারীর রিভিউ0