
- মাসিক ভিজিট
- 0
- মূল্য
- সেট করা হয়নি
- তালিকাভুক্ত
- —
- আপডেট করা হয়েছে
- 2026-11-04
01EvaOmni কী
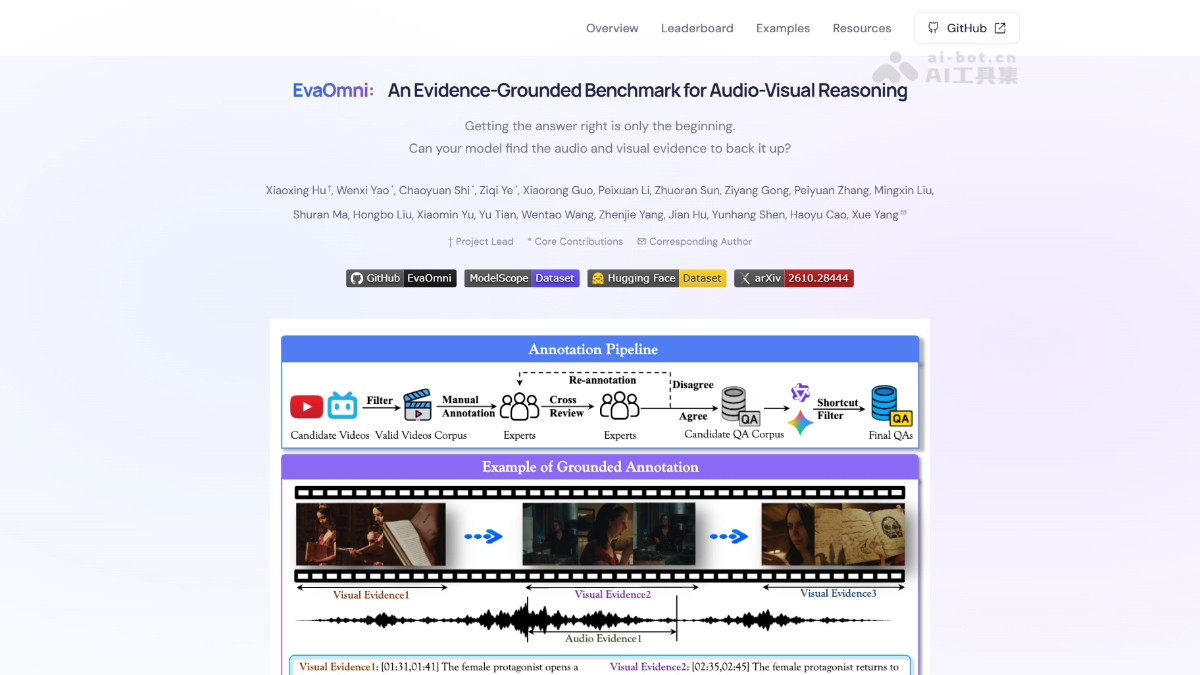
EvaOmni হলো সাংহাই জিয়াও টং বিশ্ববিদ্যালয়, ফুদান বিশ্ববিদ্যালয়, টেনসেন্ট ইউথু প্রভৃতি প্রতিষ্ঠানের উন্মুক্ত করা সর্বমোডাল বৃহৎ মডেল মূল্যায়ন বেঞ্চমার্ক। এতে 392টি বাস্তব ভিডিও ও 1,027টি মানব-অ্যানোটেটেড প্রশ্নোত্তর রয়েছে, যা 15 ধরনের সক্ষমতা এবং 3টি যুক্তির স্তর কভার করে। EvaOmni-কে একই সঙ্গে উত্তর এবং অডিও ও ভিডিও প্রমাণের সময়সীমা দিতে হয়। উত্তর নির্ভুলতা, প্রমাণ কভারেজ এবং দ্বিমোডাল অবস্থান নির্ধারণের তিনটি সূচকে স্কোর দেওয়া হয়। EvaOmni-তে পরীক্ষিত 24টি মডেলের মধ্যে সেরা Gemini3.7-Flash-এর নির্ভুলতা 79.4%, কিন্তু দ্বিমোডাল অবস্থান নির্ধারণ মাত্র 35.1%; মানব বিশেষজ্ঞের 94.3%-এর তুলনায় ব্যবধান 59.2 শতাংশ পয়েন্ট। এতে সঠিক উত্তর দিলেও তার ভিত্তি ব্যাখ্যা করতে না পারার দুর্বলতা স্পষ্ট হয়।
02EvaOmni-এর প্রধান বৈশিষ্ট্য
উত্তর মূল্যায়ন: অডিও-ভিজ্যুয়াল বহুনির্বাচনী প্রশ্নে মডেলের উত্তর সঠিক কি না নির্ধারণ করে এবং Acc. নির্ভুলতা প্রদান করে।
প্রমাণ অ্যানোটেশন ও প্রদান: প্রতিটি প্রশ্নে উত্তরের সমর্থনকারী অডিও ও ভিডিও সময়সীমা মানুষ দ্বারা অ্যানোটেট করা হয়; মডেলকে উত্তরের সঙ্গে দ্বিমোডাল প্রমাণের সময়সীমাও দিতে হয়।
প্রমাণ কভারেজ স্কোর (C.G.): মানব-অ্যানোটেটেড প্রমাণ অংশ মডেলের পূর্বানুমান করা সময়সীমায় কতবার পড়েছে, তার অনুপাত গণনা করে; মডেল কতগুলো সহায়ক সূত্র খুঁজে পেয়েছে তা মাপে।
দ্বিমোডাল bottleneck শনাক্তকরণ (B.G.): অডিও ও ভিডিওর জন্য পৃথকভাবে temporal IoU গণনা করে দুর্বলতর মোডালিটির স্কোর নেওয়া হয়; উভয় মোডালিটিতে একই সঙ্গে নির্ভুল অবস্থান নির্ধারণ আবশ্যক।
তিন-স্তরের সক্ষমতা বিন্যাস: retrieval ও অবস্থান নির্ধারণ, মৌলিক বোঝাপড়া এবং জটিল যুক্তি অনুযায়ী কাজ ভাগ করা হয়, যাতে একক বিন্দুতে alignment থেকে multi-hop reasoning পর্যন্ত মডেলের সক্ষমতার পরিসর যাচাই করা যায়।
শর্টকাট ফিল্টারিং: টেক্সট, অডিও ও ভিজ্যুয়াল একক-মোডাল ইনপুট দিয়ে প্রশ্ন যাচাই করা হয়; শুধু একটি মোডালিটি বা সাধারণ জ্ঞান ব্যবহার করে সঠিক উত্তর দেওয়া যায় এমন নমুনা বাদ দেওয়া হয়।
মডেল তুলনামূলক মূল্যায়ন: 24টি সর্বমোডাল মডেলের জন্য অভিন্ন বেঞ্চমার্ক ও র্যাঙ্কিং দেওয়া হয়, যাতে উন্মুক্ত ওজনের এবং মালিকানাধীন মডেলের তুলনা ও নির্বাচন করা যায়।
03EvaOmni-এর প্রযুক্তিগত নীতি
WeChat-এ ফলো করে “开源” লিখে উত্তর পাঠান এবং AI ওপেন-সোর্স প্রকল্পের যোগাযোগ গ্রুপে যোগ দিন
প্রমাণ-সচেতন অ্যানোটেটেড ডেটা কাঠামো: EvaOmni প্রতিটি প্রশ্নে অডিও প্রমাণের সময়সীমা ও ভিডিও প্রমাণের সময়সীমা একসঙ্গে অ্যানোটেট করে এবং ভিডিও বিষয়বস্তুর ভিত্তিতে তৈরি বিভ্রান্তিকর বিকল্পের একটি সেট যুক্ত করে। ফলে মডেলের আউটপুট তিনটি উপাদানের সমষ্টি হিসেবে সংজ্ঞায়িত হয়: বিকল্প, অডিও টাইমস্ট্যাম্পের সেট এবং ভিডিও টাইমস্ট্যাম্পের সেট। মূল্যায়ন প্রোগ্রাম আলাদাভাবে উত্তরের সঠিকতা ও প্রমাণের অবস্থান নির্ধারণের মান যাচাই করতে পারে।
চার-পর্যায়ের ডেটা নির্মাণ পাইপলাইন: ডেটা উৎপাদন ভিডিও বাছাই, মানব অ্যানোটেশন, ক্রস-রিভিউ এবং শর্টকাট ফিল্টারিং—এই চারটি ধাপের মধ্য দিয়ে যায়। প্রথমে হার্ডকোডেড সাবটাইটেল বা বড় পরিমাণের টেক্সট-আবৃত ভিডিও বাদ দেওয়া হয়, যাতে শ্রাব্য ও দৃশ্যমান সূত্র বাস্তব ও কার্যকর থাকে। বিশেষজ্ঞরা প্রশ্ন তৈরি করেন, ভিডিও বিষয়বস্তুর সঙ্গে যুক্ত বিভ্রান্তিকর বিকল্প নকশা করেন এবং দুই মোডালিটির প্রমাণের সময়সীমা অ্যানোটেট করেন। অন্যান্য অ্যানোটেটররা সক্ষমতার শ্রেণিবিন্যাস, প্রমাণের মান ও শর্টকাট সমস্যা ক্রস-রিভিউ করেন; বিতর্কিত নমুনা দুই অতিরিক্ত বিশেষজ্ঞ স্বাধীনভাবে পুনরায় যাচাই করেন। এরপর মডেলকে শুধু টেক্সট, শুধু অডিও এবং শুধু ভিজ্যুয়াল—এই তিন ধরনের একক-মোডাল ইনপুটে আলাদাভাবে উত্তর দিতে দেওয়া হয়। একক মোডালিটিতে সঠিকভাবে উত্তর দেওয়া যায় এমন সব প্রশ্ন পুনর্গঠন ও পুনরায় অ্যানোটেট করা হয়, যাতে ডেটা স্তরেই “শ্রাব্য-দৃশ্যমান যৌথ যুক্তি এড়িয়ে যাওয়ার” শর্টকাট বন্ধ করা যায়।
কভারেজ ও অবস্থান নির্ধারণের দ্বৈত-সূচক স্কোরিং ব্যবস্থা: প্রমাণ কভারেজ স্কোর C.G. প্রতিটি মানব-অ্যানোটেটেড প্রমাণ অংশের সঙ্গে যেকোনো পূর্বানুমানকৃত সময়সীমার ধনাত্মক দৈর্ঘ্যের overlap আছে কি না গণনা করে, অর্থাৎ প্রমাণটি খুঁজে পাওয়া গেছে কি না তা মাপে। Bottleneck অবস্থান স্কোর B.G.-তে প্রতিটি মোডালিটির সব পূর্বানুমানকৃত সময়সীমা ও অ্যানোটেটেড সময়সীমার union নিয়ে temporal intersection over union (IoU) গণনা করা হয়; চূড়ান্ত স্কোর অডিও ও ভিডিওর দুই IoU-এর দুর্বলতরটি। উভয় সূচকই উত্তরের সঠিকতার স্কোর দিয়ে গুণ করা হয়; ভুল উত্তর হলে শূন্য স্কোর। এই নকশায় বিস্তৃত পূর্বানুমান শুধু কভারেজ স্কোর পায়, আর নির্ভুল সীমারেখা অবস্থান স্কোরে অবদান রাখে। একই সঙ্গে “দুর্বল মোডালিটি” দিয়ে স্কোর নির্ধারণ করায় শক্তিশালী মোডালিটি দিয়ে দুর্বল মোডালিটির ঘাটতি ঢাকার সুযোগ থাকে না।
তিন-স্তরের সক্ষমতা বিন্যাস: যুক্তি ও প্রমাণের জটিলতা অনুযায়ী ডেটাসেটটি তিন স্তরে সাজানো। Level 1 retrieval ও অবস্থান নির্ধারণে অডিও-ভিডিওর মধ্যে সময়, ঘটনা ও সত্তার alignment পরীক্ষা করা হয়। Level 2 মৌলিক বোঝাপড়ায় পরস্পর-পরিপূরক শ্রাব্য ও দৃশ্যমান সূত্র একত্র করে ঘটনা, আবেগ ও উদ্দেশ্য বোঝার প্রয়োজন হয়। Level 3 জটিল যুক্তিতে বিভিন্ন সময়ে ছড়িয়ে থাকা একাধিক প্রমাণ একত্র করে multi-hop সিদ্ধান্তে পৌঁছাতে হয়। স্তর যত উচ্চ, প্রতি প্রশ্নে প্রমাণের সংখ্যা ও কভারেজ সময় তত উল্লেখযোগ্যভাবে বাড়ে; এর ফলে retrieval, বোঝাপড়া এবং দীর্ঘ-পরিসরের বহু-ধাপের যুক্তিতে মডেলের দুর্বলতা নির্দিষ্ট স্তরে শনাক্ত করা যায়।
04EvaOmni কীভাবে ব্যবহার করবেন
ModelScope ক্লায়েন্ট ইনস্টল করুন: ModelScope SDK ইনস্টল বা আপগ্রেড করতে pip install -U modelscope চালান।
ডেটাসেট ডাউনলোড করুন: dataset_snapshot_download ব্যবহার করে ডেটাসেট ID VisionXLab/EvaOmni-Dataset নির্দিষ্ট করুন এবং ডেটা স্থানীয় ডিরেক্টরিতে আনুন।
মডেল ইনপুট প্রস্তুত করুন: মূল্যায়ন প্রোটোকল অনুযায়ী ভিডিও প্রিপ্রসেস করে সংশ্লিষ্ট অডিও যুক্ত করুন।
মূল্যায়নাধীন মডেল সংযুক্ত করুন: GitHub রিপোজিটরির নির্দেশনা অনুযায়ী আপনার সর্বমোডাল মডেল সংযুক্ত করুন এবং অভিন্ন প্রম্পট ব্যবহার করে মডেলকে বিকল্প, অডিও টাইমস্ট্যাম্প ও ভিডিও টাইমস্ট্যাম্পের তিন-উপাদানের আউটপুট দিতে বলুন।
মূল্যায়ন চালান: মূল্যায়ন ফ্রেমওয়ার্ক ব্যবহার করে 1,027টি প্রশ্নোত্তরের ওপর ব্যাচ ইনফারেন্স চালান; প্রোগ্রাম স্বয়ংক্রিয়ভাবে উত্তর ও সময়সীমার মিল যাচাই করবে।
ফলাফল দেখুন: Acc., C.G. ও B.G. তিনটি সূচক এবং তিন স্তরের সক্ষমতার ফল পড়ে র্যাঙ্কিংয়ের সঙ্গে তুলনা করে মডেলের দুর্বলতা শনাক্ত করুন।
05EvaOmni-এর মূল সুবিধা
প্রমাণের অবস্থান নির্ধারণ স্কোরে অন্তর্ভুক্ত: মডেলকে অডিও ও ভিডিও প্রমাণের সময়সীমা দিতে বলা হয়, ফলে অনুমান করে সঠিক উত্তর এবং প্রমাণসহ উত্তর আলাদা করা যায়।
প্রমাণের মান পরিমাপে দ্বৈত সূচক: প্রমাণ কভারেজ স্কোর C.G. সূত্রগুলো সম্পূর্ণভাবে খুঁজে পাওয়া গেছে কি না মাপে; bottleneck অবস্থান স্কোর B.G. temporal IoU অনুযায়ী দুর্বলতর মোডালিটির স্কোর নেয়, ফলে শক্তিশালী মোডালিটি দিয়ে দুর্বল মোডালিটি আড়াল করা যায় না।
তিন-স্তরের সূক্ষ্ম সক্ষমতা বিন্যাস: retrieval ও অবস্থান নির্ধারণ থেকে মৌলিক বোঝাপড়া এবং জটিল multi-hop reasoning পর্যন্ত ধাপে ধাপে অগ্রসর হয়, ফলে বিভিন্ন যুক্তির গভীরতায় মডেলের নির্দিষ্ট দুর্বলতা শনাক্ত করা যায়।
উচ্চমানের মানব অ্যানোটেশন: বিশেষজ্ঞের প্রশ্ন প্রণয়ন, ক্রস-রিভিউ এবং বিতর্কিত নমুনায় দুই বিশেষজ্ঞের পুনঃযাচাইয়ের মাধ্যমে ডেটার নির্ভরযোগ্যতা স্বয়ংক্রিয়ভাবে নির্মিত অনুরূপ বেঞ্চমার্কের চেয়ে বেশি।
কঠোর শর্টকাট ফিল্টারিং: টেক্সট, অডিও ও ভিজ্যুয়াল তিন ধরনের একক-মোডাল ইনপুট দিয়ে প্রশ্ন যাচাই করে শ্রাব্য-দৃশ্যমান যৌথ যুক্তি এড়িয়ে সঠিক উত্তর দেওয়া যায় এমন নমুনা বাদ দেওয়া হয়, ফলে মূল্যায়নের ন্যায্যতা বজায় থাকে।
বাস্তব সক্ষমতার ব্যবধান উন্মোচন: পরীক্ষায় দেখা গেছে, সেরা মডেলের উত্তর নির্ভুলতা মানুষের তুলনায় মাত্র 17 শতাংশ পয়েন্ট কম, কিন্তু দ্বিমোডাল অবস্থান নির্ধারণে ব্যবধান 59.2 শতাংশ পয়েন্ট; এতে বর্তমান মডেলগুলোর প্রকৃত দুর্বলতা স্পষ্ট হয়।
06EvaOmni প্রকল্পের ঠিকানা
প্রকল্পের ওয়েবসাইট: https://xiaoxing2001.github.io/EvaOmni.github.io/
GitHub রিপোজিটরি: https://github.com/VisionXLab/EvaOmni
HuggingFace মডেল রিপোজিটরি: https://huggingface.co/datasets/VisionXLab/EvaOmni-Dataset
arXiv প্রযুক্তিগত গবেষণাপত্র: https://arxiv.org/pdf/2610.28444
07EvaOmni-এর প্রয়োগক্ষেত্র
সর্বমোডাল মডেল গবেষণা ও মূল্যায়ন: মডেল দল Omni LLM উন্নত করার সময় Acc./C.G./B.G. তিনটি সূচক ব্যবহার করে “উত্তর উন্নত হলেও প্রমাণের অবস্থান নির্ধারণ এগোয়নি” ধরনের সক্ষমতার বিচ্ছিন্নতা শনাক্ত করতে পারে এবং প্রশিক্ষণ উন্নতির দিক নির্ধারণ করতে পারে।
এন্টারপ্রাইজ AI নির্বাচন ও গ্রহণযোগ্যতা যাচাই: আর্থিক ও সরকারি পরিষেবার মতো ক্ষেত্রে যেখানে মডেলকে “যাচাইযোগ্য ভিত্তি” দিতে হয়, ক্রয়কারী B.G. bottleneck অবস্থান স্কোর ব্যবহার করে প্রকৃতপক্ষে নির্ভরযোগ্য দ্বিমোডাল মডেল বাছাই করতে পারেন।
ভিডিও বিষয়বস্তু পর্যালোচনা ও উৎস-অনুসরণ: পর্যালোচনা-ভিত্তিক অ্যাপ্লিকেশনে মডেলকে বলতে হয় নিষিদ্ধ বিষয়বস্তু “কোন দৃশ্যে, কোন শব্দাংশে” উপস্থিত হয়েছে। EvaOmni-এর সময়সীমা আউটপুট ও অবস্থান নির্ধারণের সূচক সরাসরি গ্রহণযোগ্যতার মানদণ্ড হিসেবে ব্যবহার করা যায়।
শিক্ষা ও চলচ্চিত্র বিষয়বস্তুর প্রশ্নোত্তর পণ্য: ভিডিও-সহ শেখার সহকারী ও চলচ্চিত্র ব্যাখ্যামূলক পণ্যে মূল ভিডিওর অংশ উদ্ধৃত করে উত্তর দিতে হয়; এই বেঞ্চমার্ক দিয়ে সংশ্লিষ্ট দৃশ্য ও সংলাপে মডেল নির্ভুলভাবে পৌঁছাতে পারে কি না মূল্যায়ন করা যায়।
একাডেমিক গবেষণা ও র্যাঙ্কিং নির্মাণ: গবেষকেরা প্রমাণ-অ্যানোটেটেড 392টি উন্মুক্ত ভিডিও ব্যবহার করে শ্রাব্য-দৃশ্যমান যুক্তি, সময় নির্ধারণ, multi-hop reasoning ইত্যাদি বিষয়ে আরও গবেষণা করতে পারেন অথবা এটিকে বহু-বেঞ্চমার্কের যৌথ মূল্যায়ন ব্যবস্থায় অন্তর্ভুক্ত করতে পারেন।
© দাবিত্যাগ: সময়ের সঙ্গে ডোমেইন ও লিংক করা কনটেন্ট পরিবর্তিত হতে পারে। AIEZZ তৃতীয় পক্ষের ওয়েবসাইট নিয়ন্ত্রণ করে না। বাহ্যিক কনটেন্ট ও ঝুঁকি স্বাধীনভাবে পর্যালোচনা করুন।
ব্যবহারকারীর রিভিউ0